Servidor lento: mide antes de ampliar
Actualizado el 28 de octubre de 2026 · Guía para empresas en México
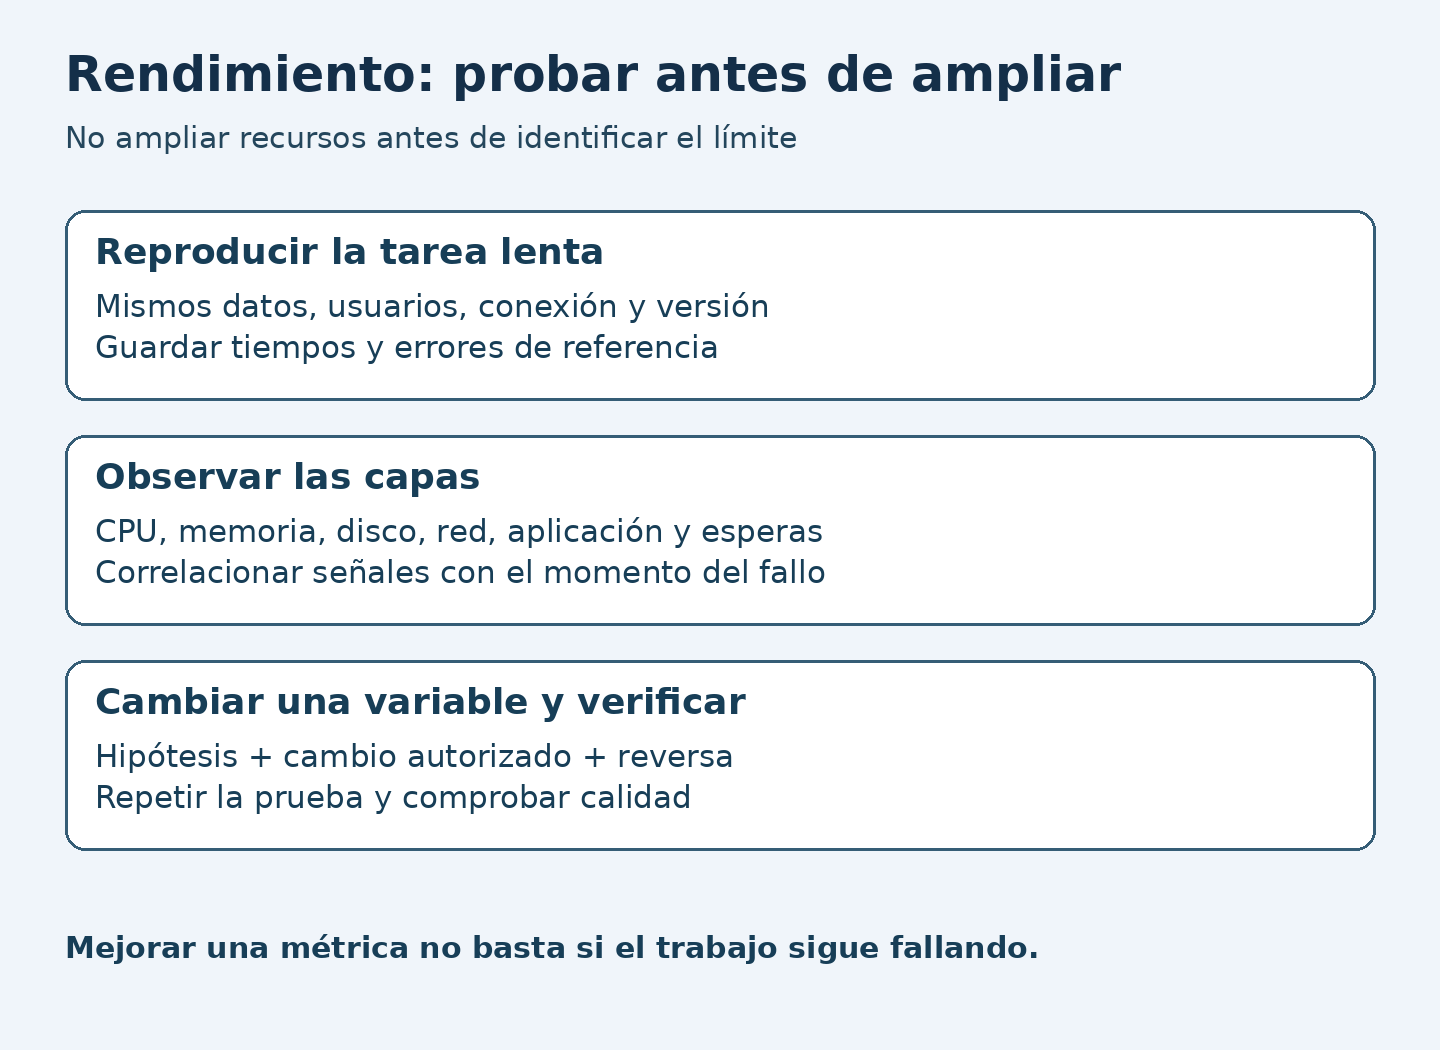
Para optimizar un servidor en la nube, reproduce primero una tarea lenta y localiza dónde pierde tiempo. Más CPU, memoria o disco puede ayudar cuando ese recurso es el límite comprobado; no resuelve automáticamente bloqueos de base de datos, errores de aplicación o una mala conexión de una sucursal.
Esta guía se centra en sistemas administrativos y ERP alojados en servidores. No es una receta para mejorar imágenes de una web ni una invitación a ejecutar ajustes de base de datos sin respaldo y autorización. El resultado que importa es completar la tarea correctamente, no conseguir una gráfica de recursos más bonita.
1. Describe la lentitud de forma reproducible
Registra aplicación y versión, tarea, filtros, tamaño de datos, usuario o perfil de prueba, conexión, concurrencia, hora y duración. Separa tres preguntas: ¿afecta a todos o a una sucursal?, ¿a todas las tareas o a una concreta?, ¿es constante o coincide con un horario?
- Una sucursal: compara conexión, equipo y cliente de acceso antes de culpar al servidor.
- Un reporte: pide revisar su consulta, volumen, filtros y posibles esperas; no presupongas falta de memoria.
- Todas las tareas a una hora: correlaciona con carga de usuarios, procesos programados, respaldos y cambios registrados.
- Desde una actualización: conserva evidencia de versiones y configuración anterior; evalúa regresión con el responsable del sistema.
Conserva una línea base en un periodo normal y otra durante el problema. Una captura aislada de CPU o un ping no mide el tiempo completo de una operación del ERP. No reinicies por rutina antes de recoger evidencia si el servicio permite hacerlo con seguridad: puedes perder la señal que necesitabas investigar.
2. Observa las capas durante la misma ventana
Pide al administrador recopilar métricas con herramientas admitidas para el sistema y permisos de lectura adecuados. Define frecuencia, duración y retención; la captura también consume recursos y puede contener datos sensibles. Microsoft recomienda relacionar datos de recursos con el comportamiento de la carga, no mirarlos de forma aislada.
| Capa | Qué observar | Qué comprobar antes de cambiar |
|---|---|---|
| CPU | Uso sostenido y proceso asociado durante la tarea | Si la carga proviene de trabajo útil, consultas costosas, otro proceso o límites del entorno |
| Memoria | Disponibilidad, presión y paginación relacionadas con el síntoma | Qué proceso crece y si existen límites o configuración inadecuada; uso alto por sí solo no demuestra agotamiento |
| Disco | Latencia de operaciones, colas, volumen de lectura/escritura y espacio | Si hay espera de E/S, límites del servicio o tareas coincidentes; espacio libre no equivale a rendimiento |
| Red | Latencia, pérdida, transferencia y diferencias entre sedes | Si el tiempo se consume antes de llegar al servidor o al transferir resultados |
| Base de datos | Duración, esperas, bloqueos y consultas relacionadas | Si el motor está ejecutando trabajo o esperando un recurso; no añadir índices a ciegas |
| Aplicación | Tiempos de cada paso, errores e integraciones externas | Si espera una API, un archivo, una impresión o trabajo serial que más CPU no paraleliza |
No hay un umbral universal de CPU, memoria o latencia de disco que pruebe el problema para cualquier carga. Compáralo con la línea base, los límites contratados y el tiempo aceptable de la tarea. Una correlación orienta la investigación; todavía no demuestra causa.
3. Si usas SQL Server, distingue ejecución de espera
Microsoft documenta un diagnóstico que distingue consultas ocupadas en CPU de consultas que pasan gran parte del tiempo esperando. El responsable de la base debe identificar la consulta y el tipo de espera, con herramientas y permisos adecuados a la edición. Una duración alta no significa siempre que falten procesadores.
Los bloqueos, la E/S y otras esperas requieren investigación específica. Evita inferir una causa restando tiempos sin considerar consultas paralelas: pueden acumular más tiempo de CPU que su duración de reloj. Para otros motores, utiliza su documentación y métricas propias; no traslades nombres de contadores o soluciones de SQL Server como si fueran universales.
Crear índices, cambiar memoria, actualizar estadísticas, modificar consultas o separar la base de datos puede tener consecuencias y costos. El DBA o implementador debe probar la intervención aplicable, conservar recuperación y verificar escritura, lectura y operaciones críticas. Esta guía no proporciona comandos para alterar producción.
4. Diseña un experimento con una sola variable
- Hipótesis: expresa qué señal explica la tarea lenta y qué resultado esperas si es correcta.
- Cambio: el responsable autorizado elige una intervención acotada, su ventana, riesgos y forma de revertir.
- Comparación: repite la misma tarea con datos, filtros, usuarios y condiciones lo más equivalentes posible. Registra diferencias inevitables.
- Calidad: comprueba totales, archivos, permisos y errores; una tarea más rápida con resultado incorrecto falla la prueba.
- Decisión: conserva el cambio solo si cumple el criterio acordado y no perjudica otras tareas. Si no, revierte según el plan y revisa la hipótesis.
No cambies simultáneamente tamaño del servidor, versión de aplicación, índices y configuración de red: aunque mejore, será difícil identificar qué funcionó y cómo recuperar un fallo.
Una hoja de medición que puedes completar sin herramientas nuevas
Registra varias repeticiones autorizadas de una tarea representativa y conserva los valores individuales, no solo el promedio. No ejecutes una prueba de carga sobre producción sin coordinación; puedes perjudicar a otros usuarios.
Abrir registro de prueba para copiar
Tarea / aplicación / versión / fecha:
Datos, filtros y resultado esperado:
Conexión / cliente / usuarios simultáneos:
Condiciones: normal, pico, cierre u otra:
Duraciones antes (misma unidad):
Errores antes / resultado funcional:
Señal observada y evidencia:
Hipótesis y cambio único autorizado:
Respaldo, ventana y procedimiento de reversa:
Duraciones después (misma unidad):
Errores después / resultado funcional:
Otras tareas afectadas:
Decisión, responsable y próxima revisión:
Ejemplo hipotético: cinco ejecuciones comparables tardan 30, 32, 31, 29 y 33 segundos; la mediana es 31. Tras un cambio, tardan 24, 25, 23, 26 y 24; la mediana es 24. La reducción de la mediana es (31−24)÷31×100 ≈ 22.6%. No es un benchmark ni demuestra el comportamiento en hora pico. Si aumentaron errores o cambió el volumen de datos, esa cifra no acredita mejora.
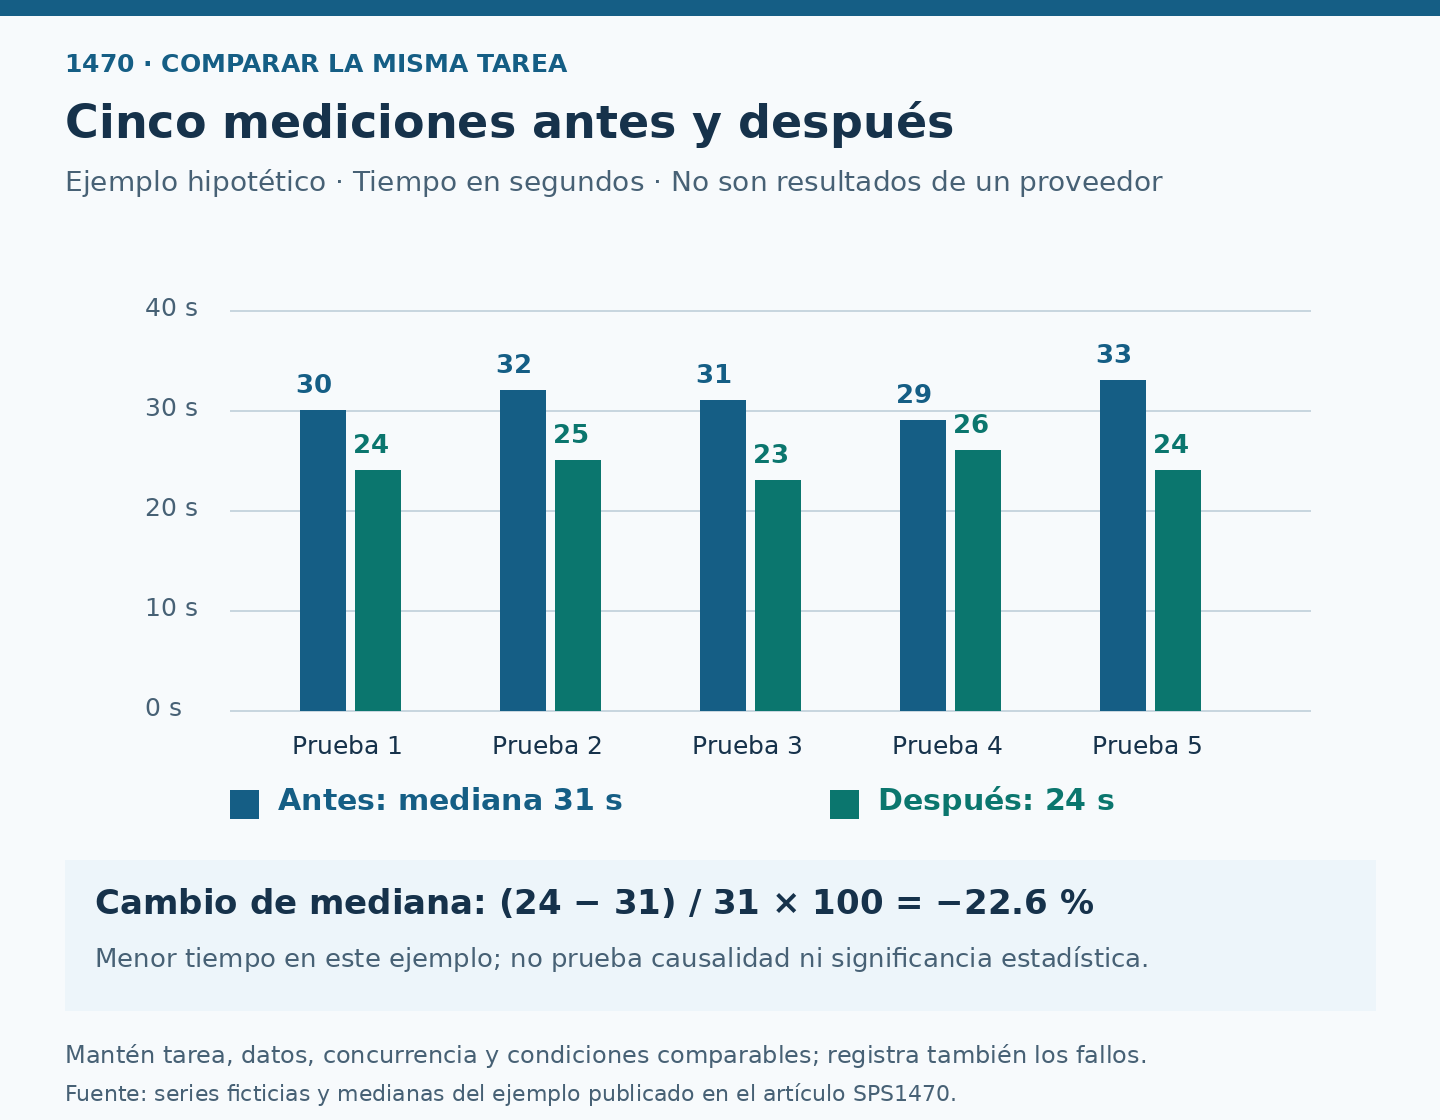
Una muestra pequeña sirve para documentar un ensayo, no para asegurar capacidad o calcular percentiles fiables de toda la operación. Usa una ventana y cantidad de observaciones apropiadas al proceso antes de tomar una decisión de producción.
Compara tus mediciones con la herramienta interactiva
Introduce al menos tres tiempos por serie y los fallos observados; confirma que la tarea y las condiciones son comparables. La herramienta calcula medianas, variación porcentual y rangos. No mide tu servidor, no identifica por sí sola la causa ni demuestra significancia estadística.
Abrir comparador de mediciones (nueva pestaña)
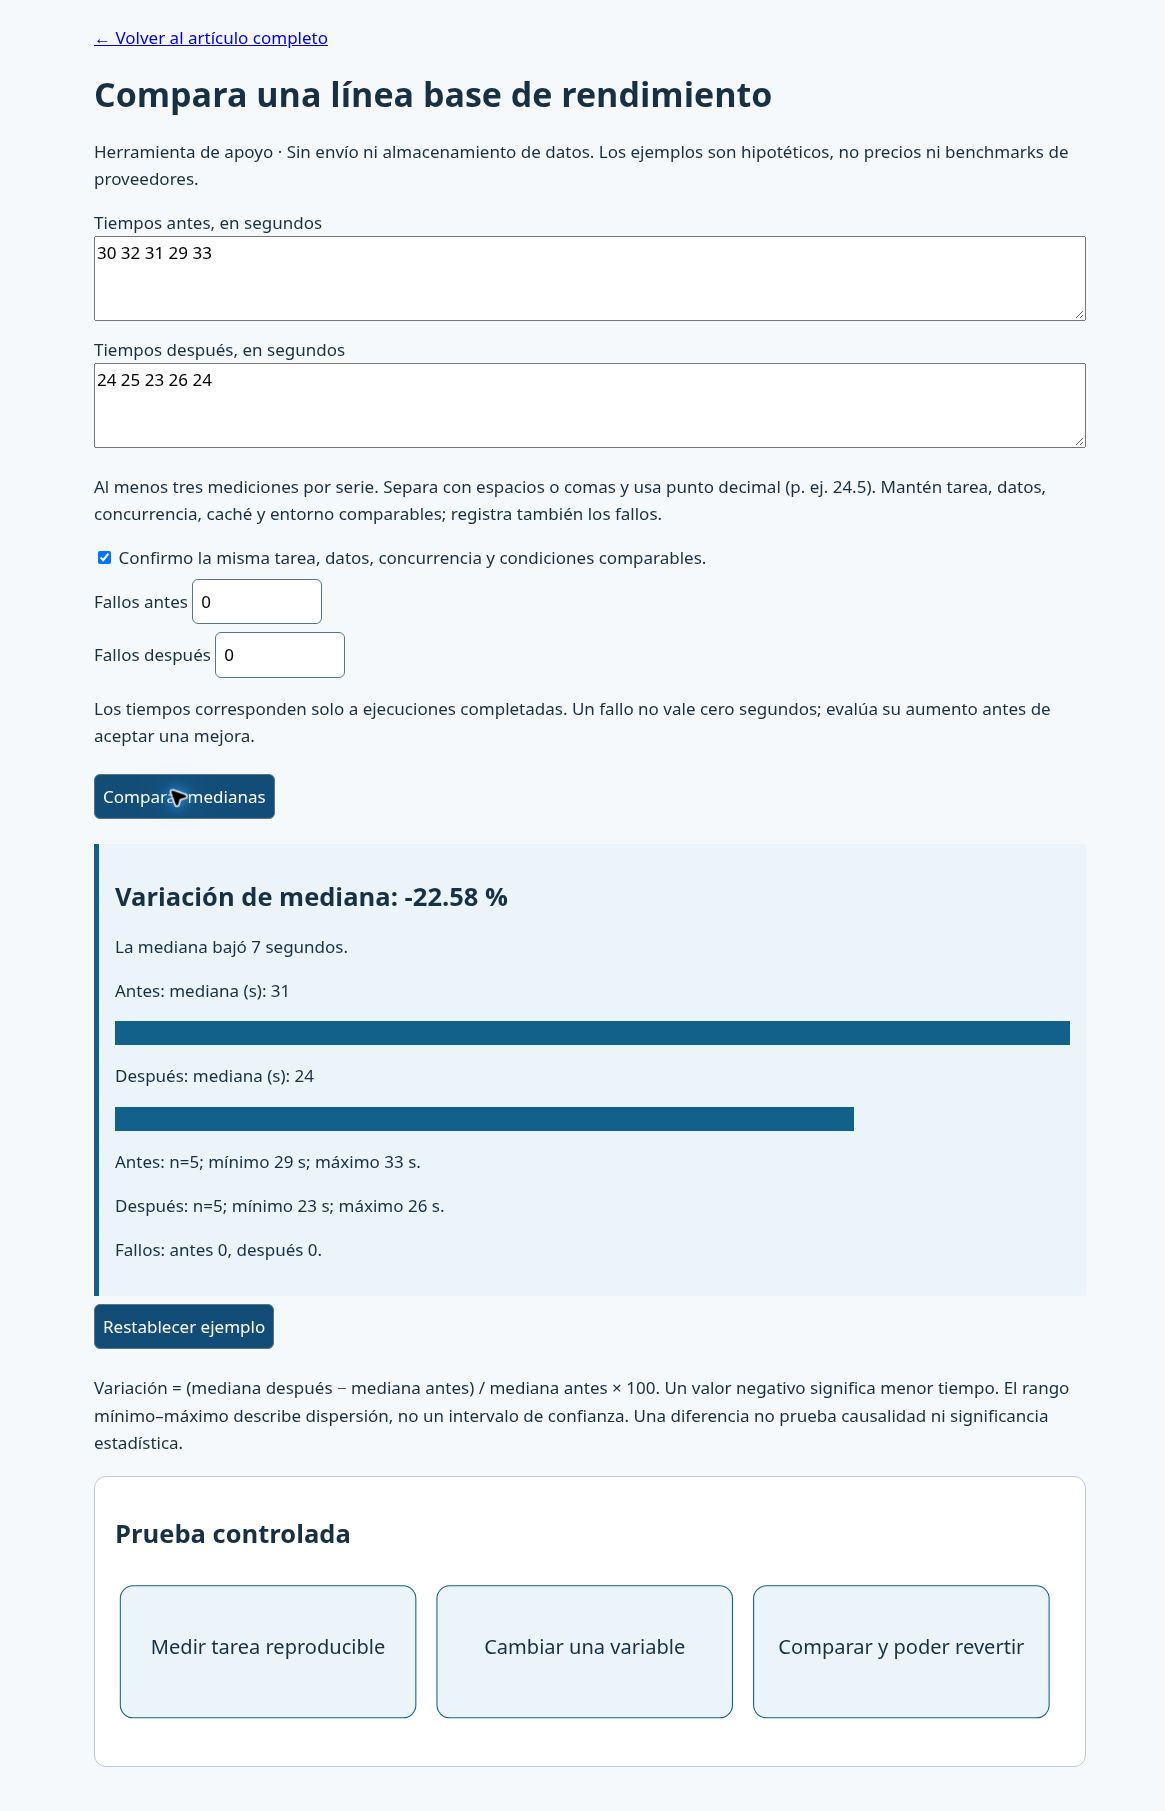
Los cálculos se ejecutan en tu navegador, sin enviar ni almacenar las mediciones. Requiere JavaScript; la fórmula, el ejemplo y la ficha de esta guía siguen disponibles sin él.
Cuándo sí considerar ampliar o cambiar la infraestructura
Considéralo cuando la evidencia muestre una limitación de capacidad relevante para la carga y se hayan evaluado las alternativas compatibles con el sistema. Comprueba costo, licencias, interrupción, límites y recuperación. Más recursos no siempre se aprovechan: una tarea serial o una espera externa puede seguir igual.
Separar la base de datos agrega red y administración; una caché necesita reglas de vigencia e invalidación; balancear varias instancias requiere que sesiones, datos y arquitectura lo soporten. Una CDN puede ayudar con contenido web distribuible, pero no corrige automáticamente una consulta lenta de ERP o una sesión remota. No conviertas estas técnicas en recetas universales.
Las actualizaciones deben planificarse por soporte y seguridad, probarse y contar con retorno; no prometas que toda actualización aumentará velocidad. Tampoco desactives controles de seguridad para mejorar un número.
IA como apoyo al registro, no como administrador automático
Puede ordenar métricas anonimizadas y ayudarte a formular hipótesis o resumir un ensayo. Puede confundir correlación con causa e inventar parámetros. Revisa todo con el administrador y la documentación; no compartas secretos ni datos personales de registros. No le delegues ajustes de base de datos, reinicios o cambios de seguridad sin revisión y ejecución autorizadas.
Solicitar ayuda con evidencia
Si necesitas apoyo, presenta a Cobalt Blue Web la ficha del problema, indicando tarea, horario, cambios recientes y señales observadas. Comparte registros solo por el canal autorizado y depurados de secretos. Para separar restricciones de versión de problemas de rendimiento, consulta también la matriz de compatibilidad.
Fuentes y alcance
- Microsoft: observar el rendimiento de una carga.
- Microsoft: consultas lentas, ejecución y esperas en SQL Server.
- Microsoft: diagnóstico por capas de una aplicación con SQL Server.
Revisión documental: 28 de octubre de 2026. No se ha medido tu servidor; el ejemplo numérico es didáctico y no garantiza rendimiento.