ERP con Disaster Recovery: cómo evaluar y probar al proveedor
Actualizado el 29 de octubre de 2026 · Guía para empresas en México
Para contratar recuperación ante desastres de un ERP, pide una prueba que termine con una operación válida del negocio, no sólo con un servidor encendido. Debe mostrar cuánto duró la recuperación, hasta qué punto llegaron los datos, qué dependencias se comprobaron y quién puede autorizar volver a operar.
Disaster Recovery, o DR, reúne capacidades y procedimientos para recuperar el servicio ante un escenario definido. No garantiza por sí solo ausencia de interrupciones o pérdidas. Esta guía te ayuda a evaluar al proveedor mediante un caso resuelto, una línea temporal, un laboratorio interactivo y una ficha de aceptación. Se centra en un incidente y su ensayo, no en el corte de una migración planificada.
Acordar objetivos antes de comprar una arquitectura
RTO es el objetivo de tiempo para recuperar el servicio definido. RPO expresa cuánto puede retroceder el punto de recuperación de los datos respecto del momento de referencia acordado. Son objetivos del negocio; los tiempos y puntos obtenidos durante una prueba son evidencia observada. No conviene llamar «RTO garantizado» al mejor ensayo del proveedor.
Define dónde empieza y termina el reloj. En el caso de esta guía empieza con la interrupción simulada y termina con la aceptación funcional limitada del ejercicio. Si una propuesta mide sólo desde que recibe el ticket hasta que inicia una restauración, está midiendo otro intervalo. Tampoco el tiempo de primera respuesta del soporte equivale al tiempo hasta que el usuario vuelve a trabajar.
Para cada proceso, indica quién acepta los resultados y con qué comprobación: consultar un saldo no es lo mismo que registrar una operación sin duplicarla. La guía de contingencia NIST SP 800-34 Rev.1 actualizada relaciona prioridades de recuperación con el análisis de las operaciones. Es una referencia de planificación, no una certificación de tu instalación ni una receta universal para empresas mexicanas.
- Objetivo temporal: proceso incluido, inicio del reloj, punto de aceptación y tiempo acordado.
- Objetivo de datos: conjuntos incluidos, instante de referencia y antigüedad máxima aceptable del punto recuperable.
- Integridad: transacciones, documentos y dependencias que deben concordar, además de poder abrir la aplicación.
- Responsabilidad: quién declara el incidente, ejecuta la recuperación, valida el negocio y autoriza el siguiente paso.
Réplicas, respaldo y failover responden a problemas distintos
Una réplica puede ayudar a continuar ante la falla de un componente, pero también puede reproducir cambios no deseados. Un respaldo permite recuperar un estado conservado, aunque restaurarlo, reconstruir accesos y validar el ERP consuma tiempo. Un diseño necesita explicar qué escenarios cubre: caída de servidor, pérdida de sitio, error lógico, corrupción o cuenta comprometida no son el mismo evento.
La guía de opciones de recuperación en AWS distingue estrategias de respaldo/restauración, capacidad de reserva y múltiples sitios. También señala la necesidad de recuperar configuración e infraestructura, no sólo datos. Son opciones que se evalúan para una carga, no una tabla que permita deducir automáticamente la arquitectura a partir de dos números.
En SQL Server, la documentación de modos de failover de grupos de disponibilidad condiciona la conmutación sin pérdida al modo y estado de sincronización correspondientes; la conmutación forzada puede perder datos. Aun con una base correctamente recuperada, el ERP puede depender de identidad, archivos, red y servicios externos. «Síncrono» no certifica cero pérdida del negocio completo.
Ni activo/activo significa recuperación inmediata de cualquier incidente, ni activo/pasivo tiene un tiempo fijo. Pide la secuencia real, capacidad disponible, dependencias y evidencia. Si una credencial necesaria sólo está accesible en el sitio afectado, un segundo servidor puede quedarse esperando la misma dependencia.
Caso resuelto: el reloj cumple, pero el plan todavía no
Todo este caso es hipotético. Empresa, tiempos, documentos y resultados son inventados para explicar la evaluación; no representan pruebas de clientes ni promesas de un proveedor. Se ensaya un ERP con datos sintéticos en un entorno separado. No se ejecuta un failover real ni se alteran sistemas productivos.
El proceso incluido es registrar pedidos y consultar su estado. El objetivo temporal del ejercicio es 90 minutos desde la interrupción simulada hasta la aceptación funcional del conjunto recuperado. El objetivo de datos permite retroceder como máximo 30 minutos. Se acuerda probar aplicación, base, documentos asociados y acceso de un usuario autorizado. Los pagos externos quedan sin ejecutar durante el ensayo; su conciliación se revisa con referencias sintéticas.
Primera prueba: dos resultados que no deben confundirse
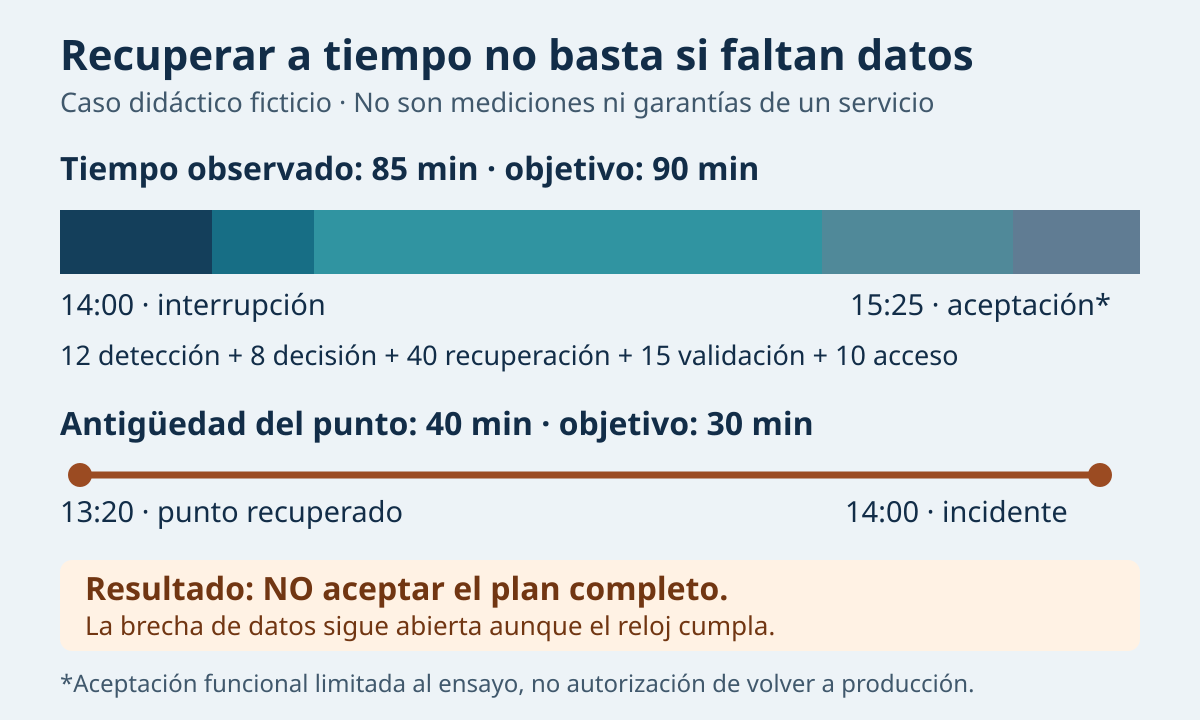
La interrupción simulada ocurre a las 14:00, UTC−06. El último punto consistente y recuperable comprobado corresponde a las 13:20. La bitácora presenta cinco fases consecutivas, sin solapamientos:
- 14:00–14:12, detección: transcurren 12 minutos hasta identificar la interrupción en el escenario.
- 14:12–14:20, evaluación y autorización: el coordinador valida el alcance del ejercicio y autoriza la ruta prevista;8 minutos.
- 14:20–15:00, recuperación técnica: se recuperan los componentes definidos en el entorno de prueba;40 minutos.
- 15:00–15:15, validación funcional: el responsable comprueba referencias, totales y documentos del punto recuperado;15 minutos.
- 15:15–15:25, acceso y aceptación del alcance probado: el usuario autorizado abre, registra una operación sintética y confirma su resultado;10 minutos.
Tiempo observado:12+8+40+15+10=85 minutos. Está cinco minutos dentro del objetivo de 90 para este ensayo. Antigüedad del punto recuperado:14:00−13:20=40 minutos. Excede por diez el objetivo de 30. No se debe convertir un resultado temporal favorable en aprobación de todo el plan.
Qué demuestra la validación y qué deja abierto
La operación sintética P-100, anterior a las 13:20, conserva su importe y documento asociado en el conjunto recuperado. P-101, registrada después de ese punto en la historia del ejercicio, no aparece. No se inventa que la diferencia está resuelta ni se reenvía un pago sólo porque el ERP ya abre. El responsable compara las referencias de operaciones posteriores con la bitácora externa sintética para identificar qué requiere conciliación.
Decisión de la primera prueba: no aceptar el plan completo para esos objetivos. Se reconoce que la ruta funcional del conjunto recuperado tardó 85 minutos; sigue abierta la brecha de datos y su conciliación. Esa aceptación funcional limitada no autoriza volver a producción, ni implica que sea seguro retomar operaciones reales con información incompleta.
Corrección y segundo ensayo: evidencia nueva, no magia retrospectiva
El proveedor debe explicar por qué el punto utilizable quedó en 13:20: frecuencia prevista no alcanzada, copia incompleta, atraso de réplica, validación fallida u otra causa demostrada. En el supuesto del caso, una tarea había fallado y nadie había escalado su alerta. Se corrige el procedimiento de supervisión y se asignan titular y suplente. No se cambia a una arquitectura costosa sin comprobar primero esa causa.
En un ensayo posterior, con un conjunto nuevo de datos sintéticos, se comprueba un punto consistente 20 minutos anterior a la nueva interrupción. Las fases duran 10,5,40,15 y 10 minutos:80 en total. El responsable verifica las referencias esperadas de ese nuevo punto y documenta las operaciones posteriores que quedarían fuera. La primera pérdida simulada no se recupera retroactivamente por haber corregido la tarea.
Decisión del segundo ensayo: se acepta la ruta para el escenario, volumen, versiones y criterios probados, con 80 minutos frente a 90 y 20 de antigüedad frente a 30. Se conserva el alcance y el registro de pendientes ajenos al ensayo. No se garantiza que todos los incidentes futuros tendrán el mismo resultado ni se declara cubierta una dependencia que no se probó.
Qué haría cambiar la decisión
- Identidad o conexión del usuario no funcionan: el reloj no termina cuando el motor queda en línea; el proceso todavía no está disponible dentro del alcance acordado.
- Se sospecha corrupción o compromiso: el punto más reciente puede no ser apropiado. La recuperación necesita revisión de seguridad y coherencia; no se prescribe restaurar inmediatamente sobre producción.
- El volumen, versión o integración cambia: se revisa la evidencia afectada y se repite el ensayo correspondiente. No se conserva una aceptación antigua como si cubriera el nuevo escenario.
- Hay operaciones externas posteriores al punto: se concilian antes de reenviar. Restaurar una base no revierte automáticamente un cobro o un despacho efectuado fuera del ERP.
Compara tu bitácora sin confundir datos faltantes con cero
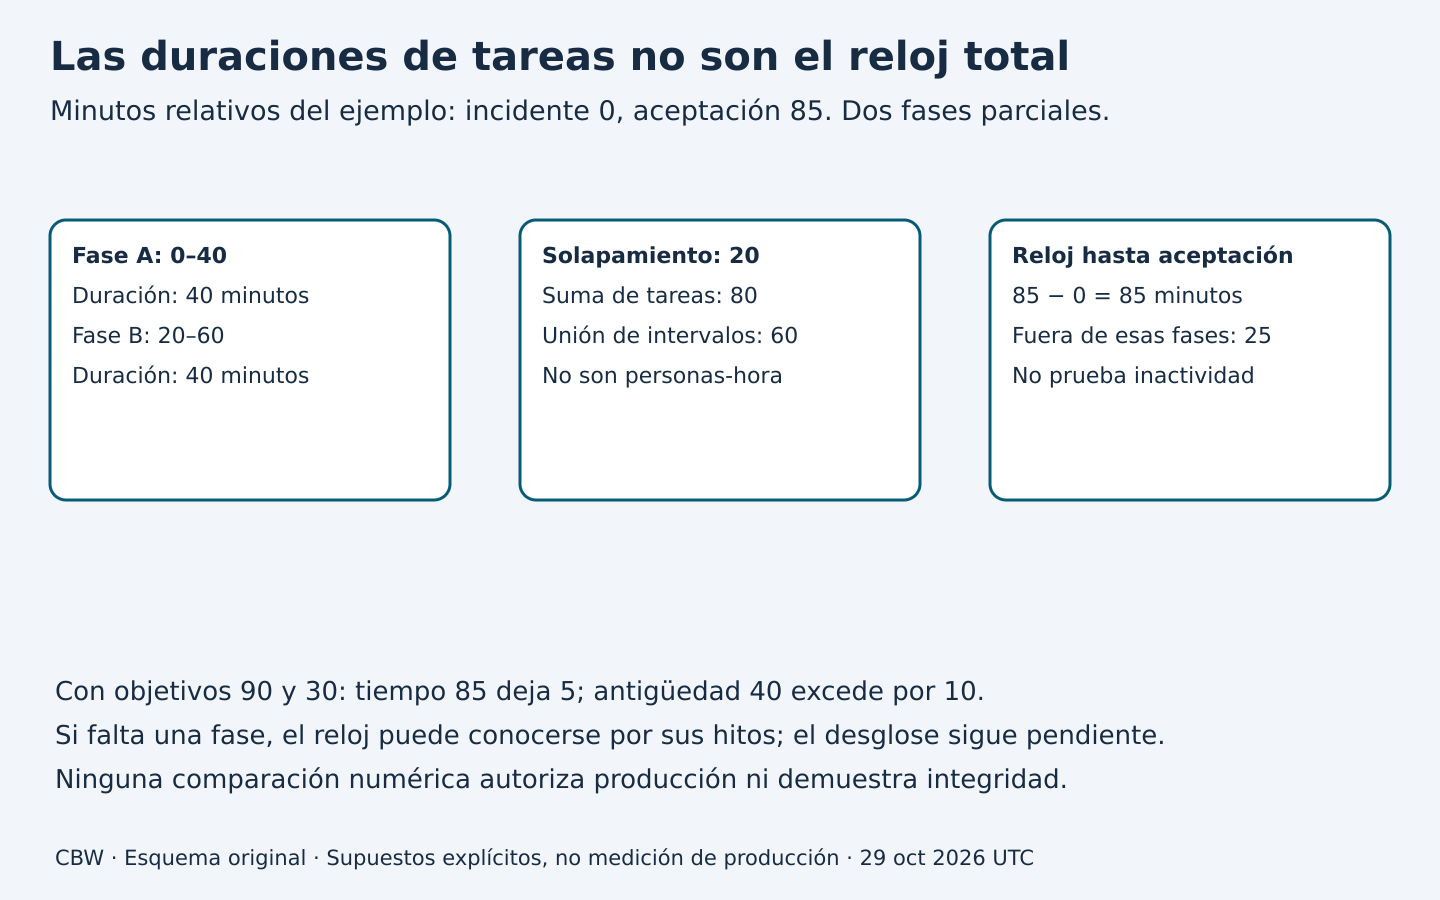
La regla general es tiempo transcurrido = instante de aceptación funcional − instante de interrupción, con el mismo origen temporal. La suma de fases del primer caso da 85 minutos porque son consecutivas y cubren todo el intervalo. Si se solapan o quedan huecos, sumar duraciones no sustituye el reloj completo.
Después compara cada resultado por separado: objetivo temporal menos tiempo transcurrido; objetivo de datos menos antigüedad del punto comprobado. En el primer caso, 90−85=5 minutos de holgura temporal y 30−40=−10 en el eje de datos. En el segundo, ambas diferencias son 10. Ninguna combinación acredita por sí sola integridad, seguridad, licencias o autorización de retomar producción.
El laboratorio enlazado usa minutos relativos ficticios, con la interrupción en el minuto 0. No consulta sistemas, no admite bases de datos y no ejecuta recuperaciones. Permite conservar por separado un resultado conocido y otro pendiente; desconocido no significa cero.
Comparar tiempo y punto recuperado por separado
Abre un recurso separado de este artículo. Los controles y resultados funcionan localmente en tu navegador con ejemplos ficticios; no se envían datos a terceros.
Abrir la herramienta interactiva
Incluye reinicio y descarga local del resultado. No recupera sistemas ni aprueba producción. Conserva desconocidos y separa fases solapadas del reloj total. Puedes volver a esta guía desde el recurso.
Hitos, solapamientos y esperas: alternativa sin JavaScript
Escribe el origen del incidente, la aceptación funcional y el punto recuperable comprobado. Si la aceptación es 85 y el punto es −40 respecto del incidente 0, el intervalo es 85 y la antigüedad es 40. Si falta la aceptación, conserva pendiente el intervalo; si conoces el punto, todavía puedes calcular su antigüedad. Lo mismo ocurre a la inversa.
Una duración de fase desconocida no impide calcular el intervalo cuando inicio y aceptación están documentados: queda pendiente el desglose, no necesariamente el reloj. Si faltan los hitos, conocer algunas fases no permite inventar el total.
Para hacer visible el solapamiento, el laboratorio comienza con dos tareas ilustrativas 0–40 y 20–60, distintas de las cinco fases consecutivas del caso narrado. Con aceptación en 85, el reloj sigue siendo 85 aunque las dos duraciones sumen 80; el tramo 60–85 queda sin tarea representada, no necesariamente sin actividad.
Ejemplo de solapamiento: dos tareas ocupan los intervalos 0–40 y 20–60. Sus duraciones suman 80 minutos, pero abarcan 60 minutos corridos. Si la aceptación se registra al minuto 75, el intervalo completo es 75, no 80 ni 60. Los 15 minutos finales sin tarea registrada no prueban inactividad: falta explicar ese tramo. La suma de duraciones tampoco equivale a personas-hora sin identificar quién trabajó y cómo.
Un punto de datos posterior al incidente no debe producir una antigüedad negativa ni un resultado artificialmente favorable: es una referencia incompatible con este modelo de punto previo y necesita revisión. En una bitácora con fechas reales, conserva fecha y zona horaria; aquí los minutos relativos evitan asumir que todas las marcas pertenecen al mismo día.
Prueba rápida de lectura de una propuesta
«Restauramos en 40 minutos» podría describir únicamente la tercera fase del caso. El intervalo completo observado fue 85. Pide las otras cuatro duraciones y comprueba que el punto de inicio y la aceptación coincidan con tu objetivo.
Un reloj favorable no evalúa por sí mismo la antigüedad de datos, integridad, seguridad, licencias o capacidad. Mantén cada criterio separado en el acta.
Qué pedir al proveedor y quién debe responder
La guía de pruebas de recuperación de AWS advierte sobre rutas poco ejercitadas, capacidad insuficiente y cambios de configuración. Por eso el calendario debe responder al riesgo, cambios y alcance contratado. No hay una frecuencia trimestral ni un plazo de treinta días adecuado para todos los proyectos.
- Proveedor de infraestructura: componentes que puede recuperar, capacidad reservada o disponible, dependencias, límites y evidencias de su tramo.
- Administrador del motor: punto consistente recuperable, secuencia admitida, controles de integridad y referencias de la prueba.
- Responsable del ERP: versiones, módulos, documentos e integraciones; resultado de las operaciones de negocio.
- Coordinador del incidente: decisión de activar, comunicaciones, autorizaciones y registro de tiempos. Debe existir suplente cuando el titular no esté disponible.
- Dueño del proceso: objetivos aceptables y autorización de retomar el alcance real. Un proveedor no debería aceptar por sí solo pérdidas de datos en nombre del negocio.
Si una sola empresa cubre varios roles, deja escrito cuáles. Si participan varias, define quién coordina y cómo escala. Una lista de teléfonos sin dueño del incidente puede consumir el margen temporal antes de empezar a restaurar.
Contrato y presupuesto que reflejen el trabajo
Compara mantenimiento de la ruta de recuperación, capacidad de contingencia, conservación de copias, licencias aplicables, ensayos, atención durante incidentes y retorno posterior. Aclara qué incluye cada cuota, qué genera cargos y qué cambios requieren recotización. Un crédito por SLA no devuelve transacciones ausentes ni acredita una recuperación; revisa qué mide ese SLA y sus condiciones.
Un socio experimentado puede aportar coordinación, revisión de alertas y práctica de ensayos. La reducción de horas internas o errores debe comprobarse, no se presupone por contratarlo. El valor debe describirse como trabajo concreto y evidencia, no como «cero caídas». Si tu equipo tiene capacidad y practica una ruta aceptada, puede mantenerla internamente o contratar sólo una revisión independiente. No siempre hace falta otra plataforma o una segunda réplica.
Si necesitas resolver dónde almacenar copias, la guía de VPS para respaldos trata ese componente. Si el proyecto es un traslado planificado y no un incidente, consulta la preparación del ERP antes de migrar. Ninguno de los dos sustituye el ensayo completo del servicio.
Ficha de aceptación cumplimentada y plantilla reutilizable
- Escenario
- Interrupción simulada del servicio de pedidos; datos y dependencias sintéticos, entorno separado.
- Objetivos del caso
- 90 minutos hasta aceptación funcional del ensayo y punto no anterior a 30 minutos respecto de la interrupción.
- Primera evidencia
- 85 minutos; punto 40 minutos anterior. P-100 y documento recuperados; P-101 ausente. Rechazo del plan completo para esos objetivos.
- Acción y dueño
- Proveedor y coordinador corrigen supervisión de tarea y escalación a titular/suplente. Responsable del ERP valida referencias y pendientes.
- Segunda evidencia
- Ensayo posterior con nuevo conjunto:80 minutos, punto 20 minutos anterior y operación verificada. No restaura retrospectivamente el punto faltante del primer ensayo.
- Aceptación
- Limitada al escenario y versiones probados; revisar al cambiar carga, dependencia o diseño. No autorización automática de conmutar producción.
Abrir ficha para tu prueba de recuperación
- Proceso, escenario, componentes incluidos y exclusiones:
- Objetivos, inicio/fin del reloj y momento de referencia de datos:
- Versiones, configuración, volumen y dependencias probadas:
- Quién autoriza, ejecuta, valida y acepta, con suplentes:
- Punto recuperable comprobado, fecha y zona horaria:
- Cinco fases con inicio/fin, duración y solapamientos:
- Operaciones esperadas y resultados obtenidos:
- Documentos e integraciones conciliados; pendientes explícitos:
- Defectos, responsable, corrección y evidencia del reensayo:
- Alcance de aceptación, restricciones y evento que obliga a revisarla:
No incluyas contraseñas, tokens ni bases reales en la ficha compartida para una primera consulta.
IA para revisar la bitácora, no para declarar recuperado el ERP
La IA puede ordenar notas, proponer campos faltantes y detectar contradicciones que una persona verificará. Úsala con eventos sintéticos o una versión autorizada y depurada. No necesita recibir la base del ERP ni credenciales para ayudarte a revisar una cronología.
Entrada sintética: «Interrupción 14:00; recuperación técnica 14:20–15:00; aceptación 15:25; punto recuperable 13:20. Objetivos 90 y 30 minutos. Separa evidencias, intervalos y preguntas, sin asumir que servidor en línea significa negocio recuperado».
Salida ilustrativa, no respuesta obtenida de una prueba real: «El intervalo completo es 85 minutos; el tramo técnico 40. El punto retrocede 40 minutos. Falta confirmar qué se validó y si hubo dependencias excluidas». La persona responsable comprueba horas y alcance contra la bitácora. Si el modelo propone aprobar todo porque 85 es menor que 90, debe rechazarlo: omitió el criterio de datos.
Comprueba la aritmética con una herramienta determinista. Una cronología generada puede omitir esperas o inventar eventos. No permitas que una sugerencia de IA active conmutaciones, borre copias o reenvíe transacciones sin el procedimiento autorizado. La revisión y aceptación siguen en manos de las personas responsables.
La evidencia útil termina en una decisión verificable
Antes de contratar, pide un escenario, su bitácora y la aceptación de un proceso de negocio. Revisa tiempo y datos por separado. Si falta una dependencia, solicita que quede pendiente en vez de convertirla en una promesa general.
Si necesitas contrastar el alcance de infraestructura y coordinación, puedes consultar a Cobalt Blue Web con la ficha depurada. Pide que se identifique lo que puede asumir y lo que corresponde al fabricante, a tu equipo u otro especialista. La meta es una ruta comprobada y mantenible, no una etiqueta de «DR incluido».
Revisión integral de fuentes y ampliación editorial: 29 de octubre de 2026, UTC. NIST SP 800-34 Rev.1 es una referencia de 2010, no una edición de 2026. Ejemplos hipotéticos; el laboratorio no aprueba recuperaciones reales.