ERP caído: guía para recuperar la operación sin improvisar
Actualizado el 26 de octubre de 2026 · Guía para empresas en México
Si tu ERP se cayó, recuperar la operación no empieza por encender otro servidor. Primero hay que distinguir un fallo operativo de un incidente de seguridad, proteger datos y evidencia, comprobar una copia recuperable y validar los procesos de negocio antes de reabrir. Esta guía ayuda al responsable de TI y al dueño del proceso a ordenar esas decisiones; las intervenciones técnicas corresponden a personal autorizado y al procedimiento del ERP.
¿Se puede levantar en horas? A veces, pero no puede prometerse sin conocer la causa, el respaldo utilizable, las versiones y las dependencias. Una máquina encendida o una pantalla de acceso no acreditan recuperación. Si no hay copia comprobada, el plazo y la pérdida de datos siguen siendo desconocidos.
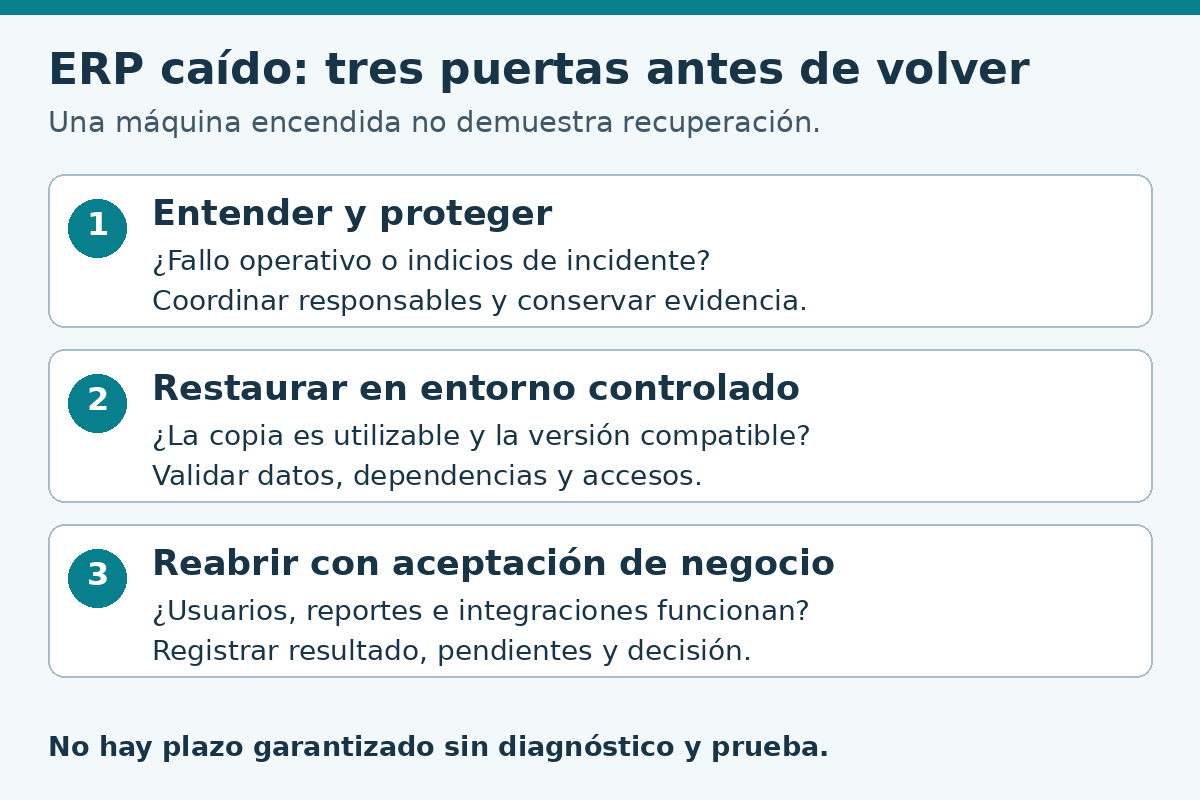
1. Delimita el incidente sin agravar el daño
Designa una persona para coordinar, una para ejecutar los cambios autorizados y una del negocio para aceptar la recuperación. Puede haber una misma persona en más de un papel, pero debe quedar claro quién decide. Abre una bitácora con zona horaria, primer síntoma, último funcionamiento conocido, usuarios afectados y cambios recientes. Evita que varios proveedores prueben soluciones simultáneas sin registrar lo que hacen.
La guía de gestión de incidentes de Microsoft trata la coordinación, las responsabilidades y la documentación como parte de la respuesta, no como trámites posteriores. Usa el canal de soporte ya contratado; un formulario comercial no sustituye un canal de incidentes.
| Observación | Comprobación inicial | Qué no hacer por reflejo |
|---|---|---|
| Falla una sede o un usuario | Comparar alcance: conexión, identidad y acceso autorizado desde otro punto conocido. | Restaurar toda la base o migrar el servidor sin probar que el fallo es global. |
| Falló después de un cambio | Relacionar hora, cambio y registros; consultar al responsable de aplicación y base de datos. | Revertir versiones sin verificar compatibilidad del esquema y un plan de reversión aprobado. |
| Errores de disco, base o capacidad | Conservar registros y revisar el estado del almacenamiento y de las copias con el especialista. | Borrar archivos, sobrescribir la única copia o repetir reinicios como diagnóstico. |
| Cifrado inesperado o accesos sospechosos | Activar respuesta de seguridad y coordinar aislamiento y preservación de evidencia. | Reconectar un respaldo al entorno comprometido o formatear antes de evaluar la evidencia. |
Si hay indicios de ransomware, cambia la prioridad
La recuperación debe coordinarse con contención e investigación, no dejar la seguridad para después. El Centro Canadiense de Ciberseguridad recomienda aislar los dispositivos afectados y conservar evidencia; advierte que apagarlos después de aislarlos puede perjudicar el análisis. El equipo autorizado debe decidir cómo hacerlo según el entorno. Antes de reconectar, hay que abordar la vía de entrada y evaluar las copias. No desactives MFA, antivirus o controles de red para “hacerlo funcionar”.
2. Comprueba el respaldo y elige una ruta defendible
Un archivo reciente no es necesariamente una copia utilizable. Para cada punto de recuperación candidato, registra:
- Qué momento representa: fecha, hora y zona horaria de los datos recuperables, no solo cuándo terminó de copiarse el archivo.
- Qué contiene: base, adjuntos, configuración y componentes requeridos; identifica qué queda fuera y cómo se recupera.
- Qué necesita: claves de descifrado disponibles por un canal seguro, versiones compatibles, licencias y permisos. No pegues secretos en la bitácora.
- Qué evidencia tiene: resultado de una restauración real en un destino controlado y comprobaciones del motor y de la aplicación.
- Qué riesgo conserva: corrupción, alcance incompleto o posible compromiso anterior a la copia. La más nueva puede no ser la elegible.
Por ejemplo, en SQL Server, RESTORE VERIFYONLY comprueba que el respaldo esté completo y sea legible, pero no lo restaura ni valida la estructura de sus datos. Un resultado correcto no demuestra que el ERP pueda operar. Tampoco trates una instantánea de máquina como respaldo consistente de la aplicación sin confirmar cómo fue creada y probarla.
El RPO expresa cuánta pérdida de datos, medida en tiempo, acepta el negocio; el RTO, cuánto tiempo acepta para recuperar la operación. Son objetivos, no resultados garantizados. La guía de recuperación ante desastres de Microsoft relaciona estos objetivos con el impacto del negocio y la necesidad de ensayar la recuperación. Para preparar el acuerdo, consulta también qué exigir a un proveedor de recuperación del ERP.
| Ruta | Cuándo considerarla | Condición y límite |
|---|---|---|
| Reparación acotada | Causa identificada, entorno confiable y cambio reversible. | Registrar el cambio y su reversión. No sirve para ocultar corrupción o compromiso sin resolver. |
| Restauración en paralelo | Existe copia elegible y conviene probar sin sobrescribir el origen. | Destino aislado de las operaciones reales, capacidad y versiones comprobadas. Requiere controlar el cambio de destino. |
| Reconstrucción controlada | El entorno no es confiable o el equipo de seguridad así lo determina. | Preservar evidencia y recuperar componentes evaluados. Crear otra VM no elimina por sí solo el incidente. |
Si no hay respaldo válido: detén los intentos que puedan sobrescribir la única información y escala a especialistas en el motor o almacenamiento. Registra que la recuperación es incierta. No vendas una migración cloud como sustituto de los datos que faltan. Para prevención posterior, revisa cómo separar cifrado, copias y recuperación del ERP.
3. Prueba el negocio antes de abrir a todos
Levanta un mapa sencillo de dependencias: identidad y roles, motor de base de datos, aplicación, almacenamiento, colas, acceso remoto y servicios externos. Incluye impresión, timbrado, correo, pagos o interfaces solo si tu operación los utiliza. El equipo técnico define el orden compatible con ese ERP; no existe un orden universal que sustituya su documentación.
La prueba no debe disparar operaciones reales por accidente. Usa entornos de prueba de los servicios externos cuando estén disponibles y autorizados. Si no existen, acuerda cómo aislar salidas y cómo realizar una validación controlada sin duplicar facturas, cargos o notificaciones. No reenvíes todas las colas pendientes a ciegas.
- Accesos: un usuario representativo entra con su rol; otro sin permiso no obtiene acceso adicional.
- Lectura: localiza registros conocidos y comprueba su fecha, adjuntos y relaciones relevantes.
- Escritura: ejecuta una transacción de prueba autorizada, confirma que persiste y que su limpieza o reversión está prevista.
- Reportes: compara un corte conocido de saldos, inventario u otro control del negocio. Investiga diferencias; no basta con que el reporte abra.
- Integraciones: comprueba destino, autenticación y tratamiento de pendientes, incluidos duplicados y reintentos.
- Aceptación: registra quién probó qué, el resultado, lo pendiente y quién autoriza reabrir.
Cambiar de servidor requiere un corte controlado
Si cambia DNS, IP o cadena de conexión, verifica el destino desde los puntos reales de acceso y los certificados aplicables. No supongas que todos los clientes cambiarán simultáneamente. Evita que el servidor anterior y el recuperado acepten escrituras independientes: el responsable técnico debe coordinar el corte, las colas y el plan de reversión. Conservar el origen no significa dejarlo atendiendo producción.
Reabre de forma controlada, observa los procesos críticos y registra la hora de aceptación del negocio. Si algo falla, usa el criterio de reversión acordado; no alternes destinos sin reconciliar cambios. El retorno posterior a la infraestructura habitual es otra intervención y necesita su propia validación.
Ejemplo: el ERP abre, pero todavía faltan movimientos
Ejemplo hipotético; no representa un cliente, medición ni plazo de servicio. La caída ocurre a las 10:05 y la última copia comprobada representa datos de las 09:40, en la misma zona horaria. El negocio había definido un RPO de 15 minutos.
Cálculo: 10:05 − 09:40 = 25 minutos de intervalo potencialmente no cubierto. Son 10 minutos más que el objetivo de 15. Esto no demuestra que se hayan perdido 25 minutos de transacciones: hay que investigar qué movimientos ocurrieron y si existen registros recuperables adicionales.
Decisión: que la aplicación abra en pruebas no basta para autorizar producción. El responsable debe identificar movimientos faltantes, evaluar su reconstrucción con evidencia y aceptar expresamente cualquier pérdida residual. Si se encuentra otro punto recuperable confiable, la elección puede cambiar. Si la copia estuviera comprometida, el cálculo de tiempo no la volvería apta.
Ficha reutilizable para coordinar sin perder información
Copia esta ficha a tu registro interno y complétala sin contraseñas, claves ni datos personales innecesarios. No es un formulario de envío.
Abrir ficha de recuperación y comunicación
- Identificador del incidente, fecha y zona horaria:
- Coordinador, ejecutor autorizado y responsable del negocio:
- Procesos y usuarios afectados; primer síntoma y última operación conocida:
- Indicios de seguridad; evidencia preservada y responsable:
- Ruta elegida, razón y aprobación del cambio:
- Copia elegida: momento de datos, componentes, ubicación controlada y prueba realizada:
- RTO/RPO acordados; diferencias conocidas y datos todavía inciertos:
- Pruebas de acceso, datos, escritura, reportes e integraciones; resultado y responsable:
- Criterio de apertura, reversión y tratamiento de movimientos pendientes:
- Próxima actualización del estado: hora acordada y canal:
- Hora real de aceptación, restricciones pendientes y autorización:
Mensaje de estado sugerido: “Afectados: [procesos]. Verificado: [hechos]. Pendiente: [prueba o dependencia]. Siguiente acción: [responsable y acción]. Próxima actualización: [hora]. Estimación de recuperación: [sustentada o aún no disponible]”.
Al cerrar, diferencia causa confirmada de hipótesis, revisa alertas y conserva la bitácora. Programa una prueba de restauración que incluya al negocio. Si el problema fue capacidad o licenciamiento, corrígelo con mediciones y requisitos verificados; comprar recursos a ciegas no es análisis de causa.
IA: ayuda para ordenar el incidente, no permiso para restaurar
Los asistentes actuales pueden ayudar a resumir registros autorizados, organizar una cronología y preparar preguntas para el proveedor. Su utilidad depende de los datos disponibles: pueden omitir un evento o proponer una explicación incorrecta. Contrasta cada conclusión con registros originales y con el especialista del ERP.
Antes de compartir información, revisa las reglas de tu organización y el tratamiento de datos del servicio. Elimina secretos y datos de clientes, reduce el alcance y usa solo herramientas autorizadas. Puedes pedir una lista de hechos, hipótesis y preguntas a partir de una cronología anonimizada; no delegues la decisión de pérdida aceptable, la reconexión de un sistema comprometido ni la ejecución de comandos de restauración. La aprobación y la comprobación siguen siendo humanas.
¿Lo resuelves internamente o necesitas apoyo?
Si tu equipo tiene el procedimiento, los permisos, una copia comprobada y capacidad para validar el negocio, puede conducir la recuperación sin contratar una migración. Si falta alguno, define el alcance del apoyo: el fabricante o implementador del ERP valida la aplicación; el administrador de base de datos, la recuperación del motor; infraestructura, el destino; seguridad, un posible compromiso. Aclara quién coordina esas fronteras.
Para evaluar infraestructura y un plan de recuperación, puedes contactar a Cobalt Blue Web indicando ERP y versión, alcance del fallo y estado comprobado de los respaldos, sin adjuntar secretos. Solicita por escrito responsabilidades, horario, canal de escalamiento y exclusiones. Este contacto no implica atención inmediata, un SLA ni recuperación garantizada. Si ya hay un incidente abierto, prioriza el canal contratado.