Tomar la decisión ERP en cloud vs local no solo depende de la cuota mensual o de la inversión inicial. En realidad, el TCO se define por gastos que no suelen aparecer en la primera cotización: licencias por núcleo, latencia entre sedes, pruebas de recuperación, almacenamiento de respaldos y costo de horas caídas. Por lo tanto, conviene desglosar cada rubro con detalle y, además, exigirlo por contrato.
1) Latencia y experiencia de usuario: el costo que todo mundo subestima
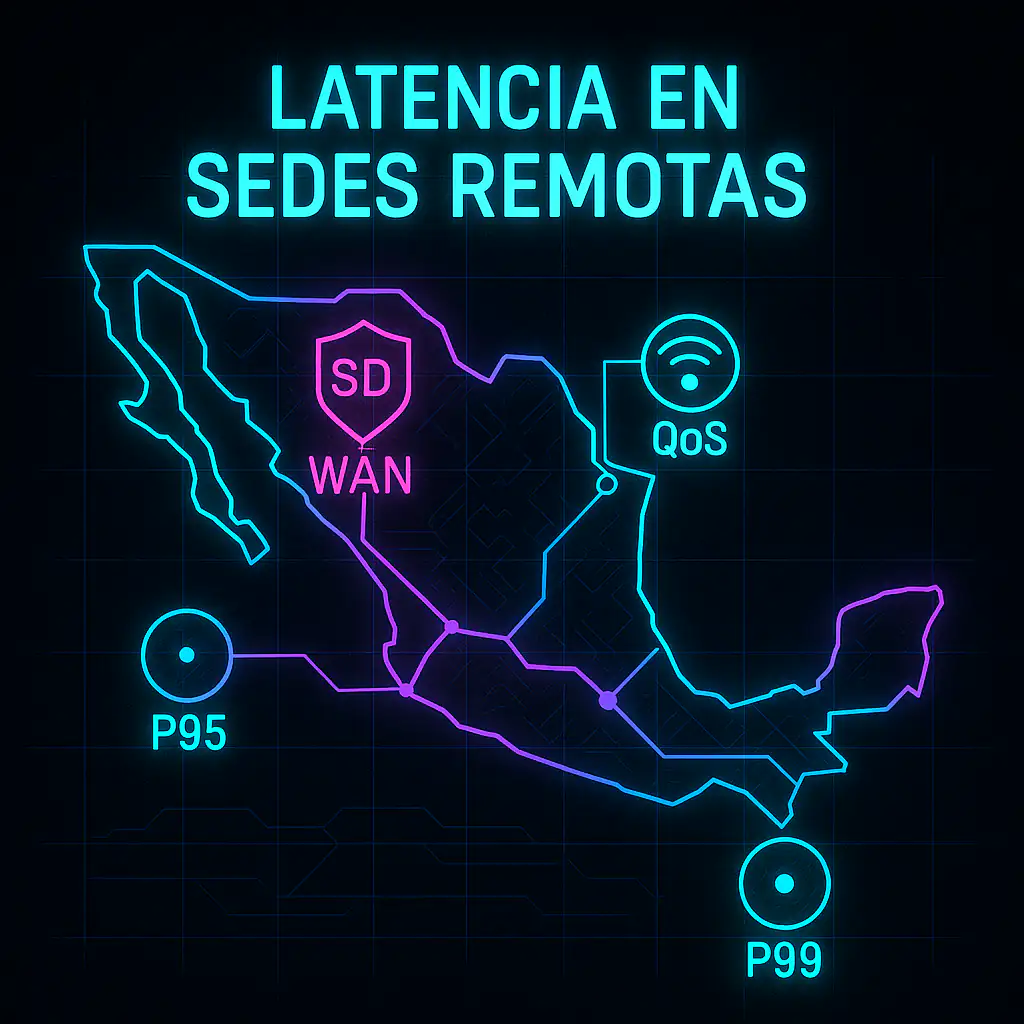
Para empezar, si tu empresa tiene sucursales o colaboradores remotos, la latencia se traduce en segundos perdidos por operación. Con un ERP en cloud vs local, la diferencia práctica es dónde vive la aplicación y cómo viajan los paquetes. En la nube, puedes acercar la aplicación a los usuarios con SD-WAN, balanceo y QoS; en local, dependes de tus enlaces de salida y de la calidad del backhaul hacia Internet. Además, la variabilidad del jitter dispara errores de captura y reintentos.
Así mismo, conviene instrumentar un plan para evitar latencia en ERP desde oficinas remotas con pruebas P95/P99, DNS local y perfiles RDP/VDI ajustados. Aquí tienes una guía práctica que puedes seguir paso a paso: Cómo evitar latencia en ERP al trabajar desde oficinas remotas.
Si usas clientes Windows publicados y quieres validar rutas, escritorios y codecs antes de decidir, solicita una evaluación técnica desde esta página de referencia: Servidores en la nube para aplicaciones Windows de escritorio ERP.
2) “Licencia incluida” vs “licencia propia”
A continuación, el licenciamiento cambia tu ecuación. En cloud administrado, es común que el proveedor ofrezca SPLA o suscripción mensual “incluida”; en on-premise, generalmente compras licencias perpetuas o anuales y asumes su administración. No obstante, cuando comparas ERP en cloud vs local, debes pedir una matriz de licencias con versión, métrica (núcleo, usuario, TB) y compatibilidad en la arquitectura propuesta. Si tus licencias son BYOL, confirma que sean elegibles en nube y que el conteo de vCPU/vCore sea válido.
Además, valida la coherencia legal y técnica con este recurso sobre servidor cloud con licencias correctas, ya que evita bloqueos y auditorías: Servidor Cloud con Licencias Correctas.
3) Almacenamiento: la letra chiquita que impacta mes a mes
El almacenamiento en nube se cobra por GB/mes, por IOPS y, a veces, por operaciones. En local, compras discos, cabinas y controladoras, aunque, posteriormente, pagarás mantenimiento y reemplazos. Por consiguiente, al comparar ERP en cloud vs local, pide el perfil de I/O de tu base de datos (IOPS y latencia P95) y define retenciones: diaria, semanal y mensual con cifrado. Para dimensionar sin sorpresas, revisa esta guía de servidores de almacenamiento de datos en la nube 2025: Almacenamiento de datos en la nube.
4) Respaldo y Disaster Recovery: RTO/RPO cuestan dinero
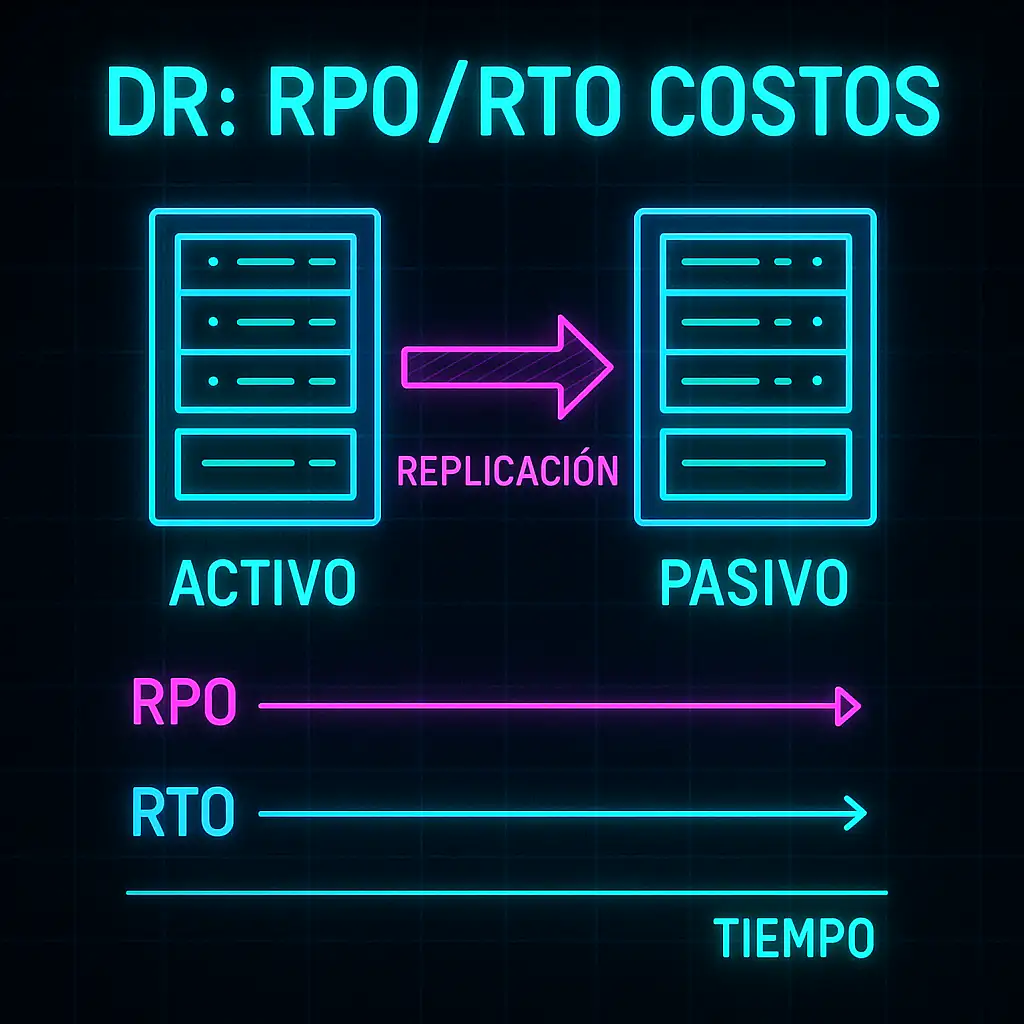
En la nube es más sencillo replicar entre zonas o regiones; en local, necesitarás un sitio alterno y enlaces dedicados. Por eso, el costo real depende del RTO (tiempo máximo caído) y RPO (datos máximos perdidos). Además, exige pruebas de restauración calendarizadas y un plan de conmutación. Esta guía explica qué pedir y cómo verificarlo por contrato: ERP con Disaster Recovery: qué debes pedir a tu proveedor.
¿Deseas un escenario con RPO≤15 min y RTO≤60 min listo para pruebas? Pide una propuesta guiada con alta disponibilidad administrada aquí: Servidores nube VPS para empresas.
5) Seguridad: costo útil o fricción cara
La seguridad agrega inspección, licencias y operación. Sin embargo, si se diseña bien, reduce costos por incidentes. En la nube, puedes activar WAF, EDR y cifrado en reposo por servicio; en local, deberás dimensionar appliances, renovar firmas y mantener parches. Por lo tanto, cotiza ambos lados con el mismo nivel de protección: MFA, PAM, registros de auditoría y planes anti-ransomware. Además, evita pagar doble inspección cuando ya usas TLS de extremo a extremo.
6) Operación y soporte: quién responde a las 3 a. m.
Con ERP en cloud vs local, la pregunta es simple: ¿quién atiende el incidente, en qué idioma y con qué tiempos de primera respuesta? En on-premise, el equipo interno suele ser el primer respondiente; en nube administrada, el proveedor ofrece 24/7 y escalamiento. No obstante, lo importante es que el SLA incluya métricas útiles y créditos por incumplimiento. Pide reportes mensuales con latencia, uso de CPU/RAM, IOPS y errores de aplicación.
Si prefieres arrancar en un VPS administrado para pilotos con monitoreo y reportes, solicita un entorno aquí: Servidores Virtuales Cloud VPS.
7) Costos de salida y bloqueo (egress, licencias y datos)
En modelos cloud, el egress (salida de datos) puede aparecer como un costo oculto, sobre todo si tu ERP exporta reportes pesados o si replicarás a otra región. En local, el costo es el ancho de banda de tus enlaces. Adicionalmente, considera la portabilidad de licencias y los formatos de respaldo para no quedar atado a un único proveedor. Por consiguiente, exige cláusulas de salida: exportación de BD, logs e imágenes en formatos abiertos, además de limpieza segura posterior.
CapEx vs OpEx y el costo del tiempo: ERP en cloud vs local
En on-premise asumes CapEx (hardware, licencias, site, energía); en cloud cambias a OpEx predecible con escalado fino. Sin embargo, el factor crítico es el tiempo: compras, aprobaciones, instalación y puesta en marcha frente a horas de despliegue en la nube. Por eso, calcula el valor de llegar antes: menos meses perdidos equivalen a ROI más rápido.
Escalabilidad y picos de fin de mes: ERP en cloud vs local
Durante cierres contables o temporadas altas, el ERP sufre. En local, el “sobredimensionamiento” es caro y subutilizado el resto del año; en nube, puedes elevar vCPU/IOPS por días y bajar después. De hecho, resulta clave separar log y datos en NVMe, habilitar cachés de lectura y revisar índices antes de los picos. Si cierras cada mes con tensión, esta guía te ayuda a prepararte: Servidor para ERP en cierres de mes.
ERP en cloud vs local: Checklist de comparación “manzana con manzana”
Para que tu comparativa ERP en cloud vs local sea honesta, exige:
-
Matriz de licencias por versión, núcleo/usuario y compatibilidad.
-
RTO/RPO con pruebas de restauración trimestrales.
-
Perfil de I/O de la base (IOPS, latencia P95) y retenciones de backup.
-
Plan de seguridad (MFA, EDR, WAF, cifrado) y costos asociados.
-
Monitoreo 24/7, métricas de aplicación y SLA con créditos reales.
-
Egress estimado y costos de salida de datos.
-
Cláusulas de portabilidad y formatos abiertos para backups.
-
Cronograma de despliegue y responsabilidades por fase.
ERP en cloud vs local: ¿Cuándo conviene cada modelo?
-
Cloud administrado: cuando hay múltiples sedes, demanda variable, necesidad de DR interzonas, tiempos de arranque cortos y equipo interno limitado.
-
Local (on-premise): cuando ya posees un site moderno, cuentas con personal 24/7, cargas estables y regulaciones que obligan a datos en sitio; aun así, considera un DR en nube para contingencias.
¿Quieres comparar propuestas con números cerrados, pruebas y tiempos reales de despliegue? Pide tu cotización con escenarios cloud y local y recibe acompañamiento técnico en español: Servicios para empresas en la nube.
Si el ERP se siente lento en una oficina remota, primero identifica qué operación tarda y en qué tramo se acumula la espera. Comprar más Internet o ampliar el servidor sin esa evidencia puede dejar intacto el problema.
Esta guía propone un diagnóstico por sede, usuario y tarea. No requiere desactivar protecciones ni cambiar la red a ciegas. El objetivo es llegar al equipo de soporte con una comparación reproducible y decidir qué merece probarse.
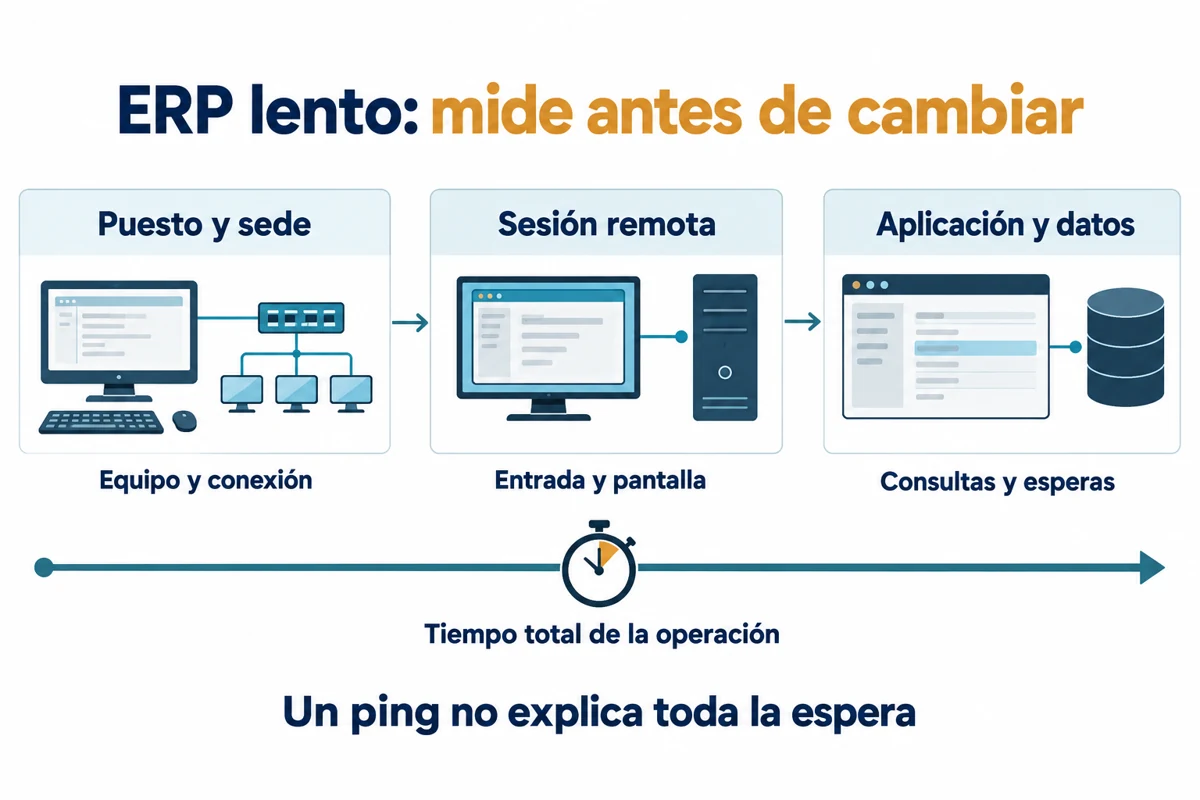
“Está lento” puede describir problemas distintos
Antes de medir, acuerda el inicio y el final de una acción: desde pulsar “Consultar” hasta ver los resultados, desde confirmar “Guardar” hasta recibir confirmación, o desde teclear hasta ver el carácter. No mezcles esos tiempos en una sola cifra.
| Síntoma observado | Primera comparación útil | Qué todavía no puedes concluir |
|---|---|---|
| El tecleo o la pantalla responde tarde | Mismo usuario y tarea en otro puesto autorizado; comparar conexión, equipo y sesión. | Que el motor de base de datos es lento o que falta capacidad al servidor. |
| La pantalla responde, pero guardar tarda | Misma operación de prueba y horario en otra sede; comprobar resultado antes de repetir. | Que todo se explica por el ping o por el ancho de banda. |
| Un informe tarda en todas las sedes | Mismos filtros y volumen; contrastar con tiempos de aplicación, consultas y dependencias. | Que cambiar el enlace de una oficina resolverá el informe. |
| Solo una persona tiene el problema | Perfil, permisos, datos consultados, equipo y sesión frente a un control comparable. | Que el resto del sistema está bien en cualquier circunstancia. |
| Solo una oficina falla en ciertas horas | Mediciones simultáneas entre sedes y actividad local de ese periodo. | Que el proveedor de Internet es culpable sin más evidencia. |
Si una operación de escritura queda sin confirmación, no hagas clic repetidamente: podrías duplicarla. Comprueba el estado con el procedimiento del ERP y usa datos de prueba autorizados para reproducir. Una investigación no debe introducir un problema contable o de inventario.
Dibuja la arquitectura antes de escoger métricas
- ERP por escritorio remoto: el puesto transmite entrada y recibe pantalla; aplicación y datos pueden estar cerca entre sí o no.
- Cliente instalado en cada oficina: el cliente puede intercambiar múltiples solicitudes con un servicio remoto. Importan las dependencias y el soporte del fabricante para esa topología.
- ERP web: intervienen navegador, servicio web, autenticación, API y datos. Un tiempo de carga puede incluir recursos e integraciones diferentes.
Escribe dónde corre cada componente y qué destino estás midiendo. Probar un sitio público cualquiera no mide necesariamente el trayecto del ERP. Si usas Access, la guía específica de arquitectura de Access explica por qué compartir su archivo por WAN no equivale a ejecutar la aplicación cerca de sus datos.
Mide la experiencia y utiliza la red como evidencia complementaria
La métrica principal debe ser una tarea que importe al negocio. Acompáñala de contexto para que soporte pueda relacionarla con sus registros. Una captura que dice “CPU 20%” tomada diez minutos después no explica una espera anterior.
- Define una operación segura. Misma consulta, filtros, conjunto de prueba y resultado esperado. Evita carga artificial en producción sin autorización.
- Registra horario y zona. Comprueba que los relojes de los sistemas que correlacionarás sean coherentes.
- Repite de forma controlada. Anota cada duración y si es la primera ejecución o una repetición; la caché puede alterar el resultado.
- Haz una comparación contemporánea. Otra sede o puesto autorizado con la misma operación y carga semejante es mejor control que un recuerdo de la semana pasada.
- Separa hechos de hipótesis. “La sede A tardó 12 segundos” es un dato; “es el router” necesita una prueba adicional.
Qué dice cada medida y dónde termina su alcance
RTT es tiempo de ida y vuelta al destino que responde. Ayuda a describir el trayecto, no el tiempo completo de una consulta. La pérdida y variación temporal también pueden importar, pero el método, periodo y destino deben quedar registrados. La ausencia de respuesta a ICMP no demuestra por sí sola que la aplicación esté caída.
Un trazado de ruta permite ver los saltos que responden. Microsoft explica que algunos equipos no contestan a paquetes con TTL agotado en su documentación de TRACERT. Por tanto, un asterisco o un salto aislado con respuesta tardía no bastan para atribuir la lentitud del ERP a ese punto. Contrasta el destino final y los datos de la aplicación.
Ancho de banda y latencia no son sinónimos. La guía de red de Microsoft para sesiones remotas relaciona necesidades de ancho de banda con carga, resolución y frecuencia de actualización. Sus recomendaciones tienen condiciones de pérdida y escenario; no deben convertirse en “tantos Mbps por cualquier usuario de ERP”. Prueba las tareas y pantallas que realmente usarás.
Para un entorno RDS compatible, el contador User Input Delay mide cuánto espera la entrada en la cola antes de que la aplicación la recoja, y reporta el máximo del intervalo. No es el RTT ni el retardo completo que ve la persona. Puede ayudar a separar una cola de procesamiento de otros tramos, con interpretación del administrador.
Si el motor es SQL Server, la metodología oficial para consultas lentas distingue ejecución y esperas. Duración, CPU, lecturas y esperas orientan el análisis de la consulta concreta. No deduzcas automáticamente “falta CPU” porque el informe tarda ni “falta disco” porque hay una espera; el tipo de espera y el contexto importan.
Mediana, percentiles y muestras: evita cifras con falsa precisión
Para una primera bitácora pequeña, conserva todos los tiempos, el mínimo, máximo y mediana. Describe cuántas observaciones tomaste y durante cuánto tiempo. No presentes un P99 calculado con tres intentos como diagnóstico fiable de la experiencia de una oficina.
Si más adelante comparas P95 o P99, fija el método de cálculo, la población y el periodo. No mezcles apertura, guardado e informes, ni agregues sedes con comportamientos distintos sin mostrarlas por separado. Un promedio general puede ocultar a la oficina que sufre.
Bitácora para copiar al ticket de soporte
Completa una ficha por operación y periodo. No incluyas contraseñas, identificadores fiscales, datos de clientes ni documentos productivos. Usa códigos internos anónimos que el equipo autorizado pueda relacionar por un canal seguro.
Ficha de observación y comparación
- Sede y puesto de prueba: ______
- Fecha, intervalo y zona horaria: ______
- ERP, versión y modalidad de acceso: ______
- Operación exacta, inicio y final del cronómetro: ______
- Datos de prueba, filtros y resultado esperado: ______
- Duraciones individuales y número de muestras: ______
- Primera ejecución o repetición; usuarios simultáneos: ______
- Equipo, conexión y destino medido: ______
- RTT/pérdida/variación, herramienta y periodo si se midieron: ______
- Control comparable en otra sede o puesto: ______
- Cambios recientes conocidos, sin atribuir causalidad: ______
- Registro o error exacto anonimizado: ______
- Resultado confirmado de la operación y siguiente prueba: ______
Este formato suele ahorrar más tiempo que enviar solamente una captura de una prueba de velocidad. También permite detectar qué dato falta, en lugar de abrir discusiones entre proveedores sin una referencia común.
Caso hipotético: dos oficinas y un informe lento
Ejemplo didáctico, no resultado de un cliente. Dos sedes ejecutan el mismo informe de prueba con filtros equivalentes dentro del mismo periodo. Se anota que la aplicación está en una sesión remota. Los valores siguientes son inventados para mostrar cómo razonar, no objetivos recomendados.
| Observación | Oficina A | Oficina B |
|---|---|---|
| Duraciones de tres ejecuciones comparables | 11.8, 12.2 y 12.0 segundos | 11.7, 12.1 y 12.2 segundos |
| Mediana de esa muestra pequeña | 12.0 segundos | 12.1 segundos |
| RTT observado al mismo destino autorizado | 25 ms | 85 ms |
| Entrada de texto y navegación simple | Sin demora visible durante el ensayo | Sin demora visible durante el ensayo |
El informe tarda casi lo mismo aunque el RTT observado sea distinto. Eso no demuestra que la red nunca afecte, pero hace poco convincente comprar un enlace más rápido como primera respuesta a este síntoma. La siguiente comprobación es correlacionar el informe con los tiempos de aplicación y motor, manteniendo constantes los filtros.
Supón que soporte encuentra una espera repetida en la consulta durante esos intervalos. Esa coincidencia orienta una hipótesis; todavía debe identificar su causa y probar una corrección controlada. No basta con que la gráfica del servidor “se vea alta”.
Ahora imagina un segundo síntoma: solo en B el tecleo se retrasa a cierta hora, mientras el informe conserva sus tiempos. Se abre una investigación distinta de puesto, sesión y trayecto de B. Un problema puede coexistir con otro; arreglar la consulta no acredita haber arreglado la sede.
A quién escalar y con qué evidencia
| Patrón que investigar | Evidencia mínima útil | Equipo que debe participar |
|---|---|---|
| Un puesto frente a otros comparables | Misma tarea, usuario o perfil autorizado, horario, recursos y resultado del control. | Soporte de puesto y aplicación; no cambiar permisos para forzar la prueba. |
| Una sede frente a otras | Periodo coincidente, destino real, datos de trayecto y operación, actividad local. | Red de la sede y proveedor del acceso, con administrador del entorno remoto. |
| Entrada o pantalla de varias sesiones | Usuarios afectados, anfitrión de sesión, intervalo, carga y contadores pertinentes. | Administrador de sesiones y plataforma. |
| Una operación lenta en todas las sedes | Pasos, filtros, duración, consulta o traza autorizada y dependencias externas. | Soporte del ERP y responsable del motor o integración. |
| Demora tras un cambio conocido | Hora y alcance del cambio, referencia anterior y prueba de retorno si está autorizada. | Responsable del cambio y equipos afectados; coincidencia temporal no es prueba suficiente. |
Solicita que cada equipo responda sobre su tramo con el mismo intervalo. “Nuestro servicio funciona” no cierra la investigación si nadie ha comparado la operación completa. Tampoco corresponde culpar a otro proveedor sin evidencia reproducible.
Cambios solo con hipótesis, autorización y retorno
Una prueba bien planteada dice qué se espera mejorar y qué observación la refutaría. Por ejemplo: “Si la saturación del enlace de la sede es relevante, la operación y las medidas del trayecto deben mejorar de forma repetible en un periodo controlado con esa carga ausente”. La alternativa debe ser segura, aprobada y comparable, no una interrupción improvisada de tareas ajenas.
- Escribe la hipótesis y la métrica de éxito de la tarea, junto con límites de error y efectos que no deben empeorar.
- Registra configuración inicial y responsable. Elige piloto o ventana autorizada.
- Cambia una variable cuando sea viable; si cambian varias, documenta que no podrás atribuir el efecto a una sola.
- Repite la comparación con carga y datos similares, incluyendo primera ejecución y repeticiones.
- Verifica funcionalidad, seguridad y operaciones relacionadas. Si no mejora o aparece un perjuicio, aplica el retorno acordado.
- Conserva los resultados y observa un periodo representativo antes de declarar resuelto el problema.
No desactives inspección, antivirus, controles de acceso ni cifrado para “acelerar” el ERP. Que un tráfico esté cifrado no hace innecesarios los controles. Tampoco publiques RDP o la base de datos en Internet como atajo. Cualquier cambio de seguridad requiere evaluación y autorización específicas.
QoS, SD-WAN, codecs, almacenamiento más rápido o ampliar recursos pueden ser opciones en un diseño concreto, no recetas universales. DNS y TTL tampoco son aceleradores generales de consultas ya establecidas. Exige que la propuesta relacione el cambio con evidencia del tramo afectado y con requisitos del fabricante.
IA para ordenar evidencia, no para tocar la red sola
Una IA puede agrupar una bitácora anonimizada por sede y tarea, identificar campos ausentes y proponer preguntas para soporte. Pídele separar “observado”, “hipótesis” y “prueba pendiente”, y comprobar los cálculos con los datos originales.
No entregues credenciales, trazas con datos personales ni información interna a servicios no aprobados. No aceptes cambios de firewall, registro, políticas o base de datos generados automáticamente sin revisión técnica. Un resumen convincente sigue sin ser una medición.
El valor del soporte está en cerrar la investigación
Un socio experimentado puede coordinar proveedor de Internet, plataforma y ERP, conservar la línea base y verificar que la mejora se mantiene. Eso puede ahorrar horas del equipo y evitar compras por ensayo y error. No equivale a garantizar cero latencia ni a prometer que cualquier sistema se corregirá en unas horas.
Si evalúas Cobalt Blue Web u otro proveedor, pide un alcance claro: quién mide, qué accesos necesita, qué entrega, qué cambios están incluidos y quién valida el resultado. Compara el coste total del diagnóstico y la atención, no solo la mensualidad del servidor.
¿Un servidor más cercano siempre hará más rápido el ERP?
Puede reducir una parte del trayecto, pero no elimina una consulta ineficiente, un bloqueo ni una integración lenta. Compara la tarea completa antes y después en un piloto autorizado.
¿Cuándo puedo decir que quedó resuelto?
Cuando el síntoma definido mejora conforme al criterio acordado, en condiciones representativas y sin romper otras funciones. Documenta qué se probó y qué quedó fuera; una sola ejecución rápida no demuestra estabilidad general.
Empieza por una sola tarea importante: completa su bitácora, añade un control comparable y entrega ambos al soporte. Tendrás una base útil para decidir el siguiente paso, con nosotros o con el proveedor que elijas.
Para contratar recuperación ante desastres de un ERP, pide una prueba que termine con una operación válida del negocio, no sólo con un servidor encendido. Debe mostrar cuánto duró la recuperación, hasta qué punto llegaron los datos, qué dependencias se comprobaron y quién puede autorizar volver a operar.
Disaster Recovery, o DR, reúne capacidades y procedimientos para recuperar el servicio ante un escenario definido. No garantiza por sí solo ausencia de interrupciones o pérdidas. Esta guía te ayuda a evaluar al proveedor mediante un caso resuelto, una línea temporal y una ficha de aceptación. Se centra en un incidente y su ensayo, no en el corte de una migración planificada.
Acordar objetivos antes de comprar una arquitectura
RTO es el objetivo de tiempo para recuperar el servicio definido. RPO expresa cuánto puede retroceder el punto de recuperación de los datos respecto del momento de referencia acordado. Son objetivos del negocio; los tiempos y puntos obtenidos durante una prueba son evidencia observada. No conviene llamar «RTO garantizado» al mejor ensayo del proveedor.
Define dónde empieza y termina el reloj. En el caso de esta guía empieza con la interrupción simulada y termina con la aceptación funcional limitada del ejercicio. Si una propuesta mide sólo desde que recibe el ticket hasta que inicia una restauración, está midiendo otro intervalo. Tampoco el tiempo de primera respuesta del soporte equivale al tiempo hasta que el usuario vuelve a trabajar.
Para cada proceso, indica quién acepta los resultados y con qué comprobación: consultar un saldo no es lo mismo que registrar una operación sin duplicarla. La guía de contingencia NIST SP 800-34 Rev.1 actualizada relaciona prioridades de recuperación con el análisis de las operaciones. Es una referencia de planificación, no una certificación de tu instalación ni una receta universal para empresas mexicanas.
- Objetivo temporal: proceso incluido, inicio del reloj, punto de aceptación y tiempo acordado.
- Objetivo de datos: conjuntos incluidos, instante de referencia y antigüedad máxima aceptable del punto recuperable.
- Integridad: transacciones, documentos y dependencias que deben concordar, además de poder abrir la aplicación.
- Responsabilidad: quién declara el incidente, ejecuta la recuperación, valida el negocio y autoriza el siguiente paso.
Réplicas, respaldo y failover responden a problemas distintos
Una réplica puede ayudar a continuar ante la falla de un componente, pero también puede reproducir cambios no deseados. Un respaldo permite recuperar un estado conservado, aunque restaurarlo, reconstruir accesos y validar el ERP consuma tiempo. Un diseño necesita explicar qué escenarios cubre: caída de servidor, pérdida de sitio, error lógico, corrupción o cuenta comprometida no son el mismo evento.
La guía de opciones de recuperación en AWS distingue estrategias de respaldo/restauración, capacidad de reserva y múltiples sitios. También señala la necesidad de recuperar configuración e infraestructura, no sólo datos. Son opciones que se evalúan para una carga, no una tabla que permita deducir automáticamente la arquitectura a partir de dos números.
En SQL Server, la documentación de modos de failover de grupos de disponibilidad condiciona la conmutación sin pérdida al modo y estado de sincronización correspondientes; la conmutación forzada puede perder datos. Aun con una base correctamente recuperada, el ERP puede depender de identidad, archivos, red y servicios externos. «Síncrono» no certifica cero pérdida del negocio completo.
Ni activo/activo significa recuperación inmediata de cualquier incidente, ni activo/pasivo tiene un tiempo fijo. Pide la secuencia real, capacidad disponible, dependencias y evidencia. Si una credencial necesaria sólo está accesible en el sitio afectado, un segundo servidor puede quedarse esperando la misma dependencia.
Caso resuelto: el reloj cumple, pero el plan todavía no
Todo este caso es hipotético. Empresa, tiempos, documentos y resultados son inventados para explicar la evaluación; no representan pruebas de clientes ni promesas de un proveedor. Se ensaya un ERP con datos sintéticos en un entorno separado. No se ejecuta un failover real ni se alteran sistemas productivos.
El proceso incluido es registrar pedidos y consultar su estado. El objetivo temporal del ejercicio es 90 minutos desde la interrupción simulada hasta la aceptación funcional del conjunto recuperado. El objetivo de datos permite retroceder como máximo 30 minutos. Se acuerda probar aplicación, base, documentos asociados y acceso de un usuario autorizado. Los pagos externos quedan sin ejecutar durante el ensayo; su conciliación se revisa con referencias sintéticas.
Primera prueba: dos resultados que no deben confundirse
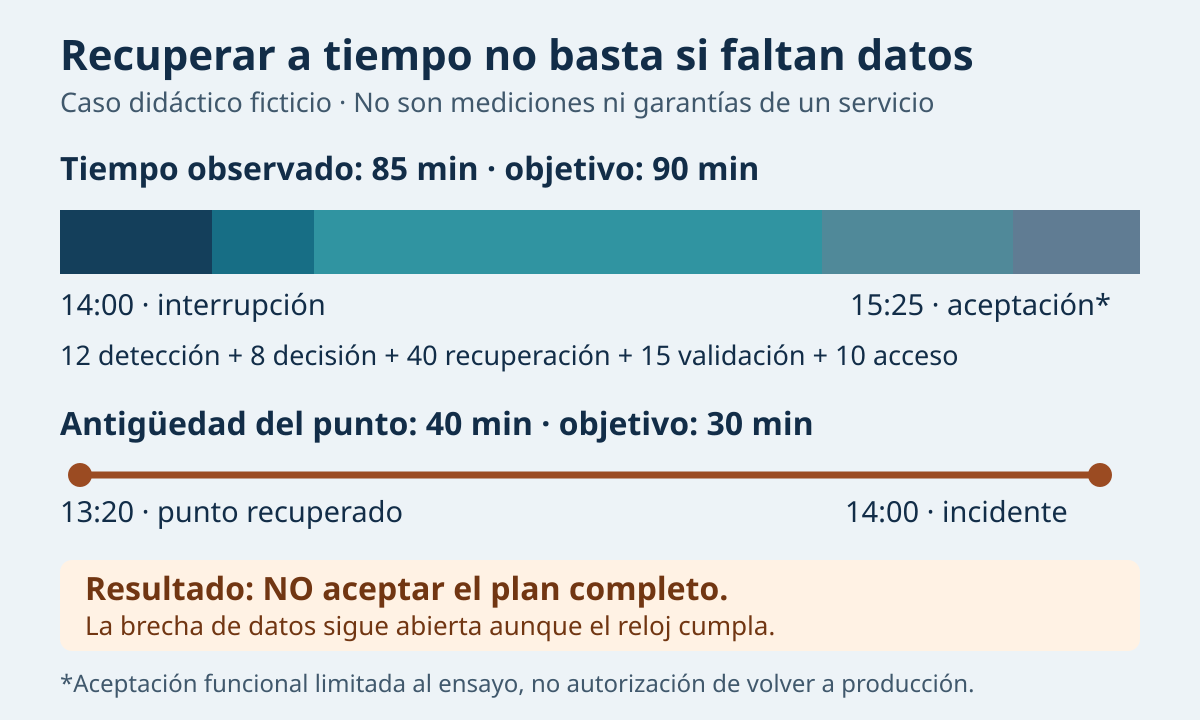
La interrupción simulada ocurre a las 14:00, UTC−06. El último punto consistente y recuperable comprobado corresponde a las 13:20. La bitácora presenta cinco fases consecutivas, sin solapamientos:
- 14:00–14:12, detección: transcurren 12 minutos hasta identificar la interrupción en el escenario.
- 14:12–14:20, evaluación y autorización: el coordinador valida el alcance del ejercicio y autoriza la ruta prevista;8 minutos.
- 14:20–15:00, recuperación técnica: se recuperan los componentes definidos en el entorno de prueba;40 minutos.
- 15:00–15:15, validación funcional: el responsable comprueba referencias, totales y documentos del punto recuperado;15 minutos.
- 15:15–15:25, acceso y aceptación del alcance probado: el usuario autorizado abre, registra una operación sintética y confirma su resultado;10 minutos.
Tiempo observado:12+8+40+15+10=85 minutos. Está cinco minutos dentro del objetivo de 90 para este ensayo. Antigüedad del punto recuperado:14:00−13:20=40 minutos. Excede por diez el objetivo de 30. No se debe convertir un resultado temporal favorable en aprobación de todo el plan.
Qué demuestra la validación y qué deja abierto
La operación sintética P-100, anterior a las 13:20, conserva su importe y documento asociado en el conjunto recuperado. P-101, registrada después de ese punto en la historia del ejercicio, no aparece. No se inventa que la diferencia está resuelta ni se reenvía un pago sólo porque el ERP ya abre. El responsable compara las referencias de operaciones posteriores con la bitácora externa sintética para identificar qué requiere conciliación.
Decisión de la primera prueba: no aceptar el plan completo para esos objetivos. Se reconoce que la ruta funcional del conjunto recuperado tardó 85 minutos; sigue abierta la brecha de datos y su conciliación. Esa aceptación funcional limitada no autoriza volver a producción, ni implica que sea seguro retomar operaciones reales con información incompleta.
Corrección y segundo ensayo: evidencia nueva, no magia retrospectiva
El proveedor debe explicar por qué el punto utilizable quedó en 13:20: frecuencia prevista no alcanzada, copia incompleta, atraso de réplica, validación fallida u otra causa demostrada. En el supuesto del caso, una tarea había fallado y nadie había escalado su alerta. Se corrige el procedimiento de supervisión y se asignan titular y suplente. No se cambia a una arquitectura costosa sin comprobar primero esa causa.
En un ensayo posterior, con un conjunto nuevo de datos sintéticos, se comprueba un punto consistente 20 minutos anterior a la nueva interrupción. Las fases duran 10,5,40,15 y 10 minutos:80 en total. El responsable verifica las referencias esperadas de ese nuevo punto y documenta las operaciones posteriores que quedarían fuera. La primera pérdida simulada no se recupera retroactivamente por haber corregido la tarea.
Decisión del segundo ensayo: se acepta la ruta para el escenario, volumen, versiones y criterios probados, con 80 minutos frente a 90 y 20 de antigüedad frente a 30. Se conserva el alcance y el registro de pendientes ajenos al ensayo. No se garantiza que todos los incidentes futuros tendrán el mismo resultado ni se declara cubierta una dependencia que no se probó.
Qué haría cambiar la decisión
- Identidad o conexión del usuario no funcionan: el reloj no termina cuando el motor queda en línea; el proceso todavía no está disponible dentro del alcance acordado.
- Se sospecha corrupción o compromiso: el punto más reciente puede no ser apropiado. La recuperación necesita revisión de seguridad y coherencia; no se prescribe restaurar inmediatamente sobre producción.
- El volumen, versión o integración cambia: se revisa la evidencia afectada y se repite el ensayo correspondiente. No se conserva una aceptación antigua como si cubriera el nuevo escenario.
- Hay operaciones externas posteriores al punto: se concilian antes de reenviar. Restaurar una base no revierte automáticamente un cobro o un despacho efectuado fuera del ERP.
Compara tu bitácora sin confundir datos faltantes con cero
Para fases consecutivas, tiempo observado = detección + evaluación/autorización + recuperación técnica + validación funcional + acceso/aceptación. Después resta el total al objetivo temporal. En el primer ensayo:90−85=5 minutos disponibles; en el segundo:90−80=10. Un valor negativo indica cuánto se excedió el objetivo.
Esta fórmula es una ayuda de revisión, no una calculadora que ejecute una recuperación desde la página. Si falta una duración, conserva el campo pendiente y no emitas un total definitivo. Cero sólo es válido si esa fase realmente no añadió tiempo y se documenta por qué. Si dos trabajos se solaparon, utiliza la cronología de inicio a aceptación, sin sumar dos veces los mismos minutos.
Prueba rápida de lectura de una propuesta
«Restauramos en 40 minutos» podría describir únicamente la tercera fase del caso. El intervalo completo observado fue 85. Pide las otras cuatro duraciones y comprueba que el punto de inicio y la aceptación coincidan con tu objetivo.
Un reloj favorable no evalúa por sí mismo la antigüedad de datos, integridad, seguridad, licencias o capacidad. Mantén cada criterio separado en el acta.
Qué pedir al proveedor y quién debe responder
La guía de pruebas de recuperación de AWS advierte sobre rutas poco ejercitadas, capacidad insuficiente y cambios de configuración. Por eso el calendario debe responder al riesgo, cambios y alcance contratado. No hay una frecuencia trimestral ni un plazo de treinta días adecuado para todos los proyectos.
- Proveedor de infraestructura: componentes que puede recuperar, capacidad reservada o disponible, dependencias, límites y evidencias de su tramo.
- Administrador del motor: punto consistente recuperable, secuencia admitida, controles de integridad y referencias de la prueba.
- Responsable del ERP: versiones, módulos, documentos e integraciones; resultado de las operaciones de negocio.
- Coordinador del incidente: decisión de activar, comunicaciones, autorizaciones y registro de tiempos. Debe existir suplente cuando el titular no esté disponible.
- Dueño del proceso: objetivos aceptables y autorización de retomar el alcance real. Un proveedor no debería aceptar por sí solo pérdidas de datos en nombre del negocio.
Si una sola empresa cubre varios roles, deja escrito cuáles. Si participan varias, define quién coordina y cómo escala. Una lista de teléfonos sin dueño del incidente puede consumir el margen temporal antes de empezar a restaurar.
Contrato y presupuesto que reflejen el trabajo
Compara mantenimiento de la ruta de recuperación, capacidad de contingencia, conservación de copias, licencias aplicables, ensayos, atención durante incidentes y retorno posterior. Aclara qué incluye cada cuota, qué genera cargos y qué cambios requieren recotización. Un crédito por SLA no devuelve transacciones ausentes ni acredita una recuperación; revisa qué mide ese SLA y sus condiciones.
Un socio experimentado puede aportar coordinación, revisión de alertas y práctica de ensayos, reduciendo horas internas y errores de ejecución. El valor debe describirse como trabajo concreto y evidencia, no como «cero caídas». Si tu equipo tiene capacidad y practica una ruta aceptada, puede mantenerla internamente o contratar sólo una revisión independiente. No siempre hace falta otra plataforma o una segunda réplica.
Si necesitas resolver dónde almacenar copias, la guía de VPS para respaldos trata ese componente. Si el proyecto es un traslado planificado y no un incidente, consulta la preparación del ERP antes de migrar. Ninguno de los dos sustituye el ensayo completo del servicio.
Ficha de aceptación cumplimentada y plantilla reutilizable
- Escenario
- Interrupción simulada del servicio de pedidos; datos y dependencias sintéticos, entorno separado.
- Objetivos del caso
- 90 minutos hasta aceptación funcional del ensayo y punto no anterior a 30 minutos respecto de la interrupción.
- Primera evidencia
- 85 minutos; punto 40 minutos anterior. P-100 y documento recuperados; P-101 ausente. Rechazo del plan completo para esos objetivos.
- Acción y dueño
- Proveedor y coordinador corrigen supervisión de tarea y escalación a titular/suplente. Responsable del ERP valida referencias y pendientes.
- Segunda evidencia
- Ensayo posterior con nuevo conjunto:80 minutos, punto 20 minutos anterior y operación verificada. No restaura retrospectivamente el punto faltante del primer ensayo.
- Aceptación
- Limitada al escenario y versiones probados; revisar al cambiar carga, dependencia o diseño. No autorización automática de conmutar producción.
Abrir ficha para tu prueba de recuperación
- Proceso, escenario, componentes incluidos y exclusiones:
- Objetivos, inicio/fin del reloj y momento de referencia de datos:
- Versiones, configuración, volumen y dependencias probadas:
- Quién autoriza, ejecuta, valida y acepta, con suplentes:
- Punto recuperable comprobado, fecha y zona horaria:
- Cinco fases con inicio/fin, duración y solapamientos:
- Operaciones esperadas y resultados obtenidos:
- Documentos e integraciones conciliados; pendientes explícitos:
- Defectos, responsable, corrección y evidencia del reensayo:
- Alcance de aceptación, restricciones y evento que obliga a revisarla:
No incluyas contraseñas, tokens ni bases reales en la ficha compartida para una primera consulta.
IA para revisar la bitácora, no para declarar recuperado el ERP
La IA puede ordenar notas, proponer campos faltantes y detectar contradicciones que una persona verificará. Úsala con eventos sintéticos o una versión autorizada y depurada. No necesita recibir la base del ERP ni credenciales para ayudarte a revisar una cronología.
Entrada sintética: «Interrupción 14:00; recuperación técnica 14:20–15:00; aceptación 15:25; punto recuperable 13:20. Objetivos 90 y 30 minutos. Separa evidencias, intervalos y preguntas, sin asumir que servidor en línea significa negocio recuperado».
Salida ilustrativa, no respuesta obtenida de una prueba real: «El intervalo completo es 85 minutos; el tramo técnico 40. El punto retrocede 40 minutos. Falta confirmar qué se validó y si hubo dependencias excluidas». La persona responsable comprueba horas y alcance contra la bitácora. Si el modelo propone aprobar todo porque 85 es menor que 90, debe rechazarlo: omitió el criterio de datos.
Comprueba la aritmética con una herramienta determinista. Una cronología generada puede omitir esperas o inventar eventos. No permitas que una sugerencia de IA active conmutaciones, borre copias o reenvíe transacciones sin el procedimiento autorizado. La revisión y aceptación siguen en manos de las personas responsables.
La evidencia útil termina en una decisión verificable
Antes de contratar, pide un escenario, su bitácora y la aceptación de un proceso de negocio. Revisa tiempo y datos por separado. Si falta una dependencia, solicita que quede pendiente en vez de convertirla en una promesa general.
Si necesitas contrastar el alcance de infraestructura y coordinación, puedes consultar a Cobalt Blue Web con la ficha depurada. Pide que se identifique lo que puede asumir y lo que corresponde al fabricante, a tu equipo u otro especialista. La meta es una ruta comprobada y mantenible, no una etiqueta de «DR incluido».
Contratar un servidor cloud con licencias correctas empieza por un expediente de derechos, no por una pantalla que diga «activado». La propuesta debe identificar qué productos se usarán, bajo qué modalidad, en qué infraestructura y con qué usuarios o dispositivos. Después se comprueba que esos derechos correspondan al despliegue y al contrato concretos.
La idea útil es sencilla: conserva un inventario, una matriz de asignación y evidencia contractual. Lo que requiere cuidado son los detalles. Una licencia comprada para un escenario no debe suponerse válida para cualquier nube, una suscripción no incluye necesariamente todos los servicios de soporte y una factura no describe por sí sola todos los derechos de uso. Esta guía organiza las preguntas; no emite un dictamen jurídico ni sustituye las condiciones del fabricante.
Resultado que buscas: una propuesta en la que cada producto tenga una modalidad documentada y una persona responsable. Si una fila sigue sin aclararse, registra el pendiente y no lo conviertas en un «incluido» implícito. En el expediente trabajado verás una incompatibilidad de versión que impide aceptar la configuración inicial y cómo se cierra sin confundir una promesa con evidencia.
Consulta por tema: tres comprobaciones · modalidades · matriz de licencias · crecimiento y salida.
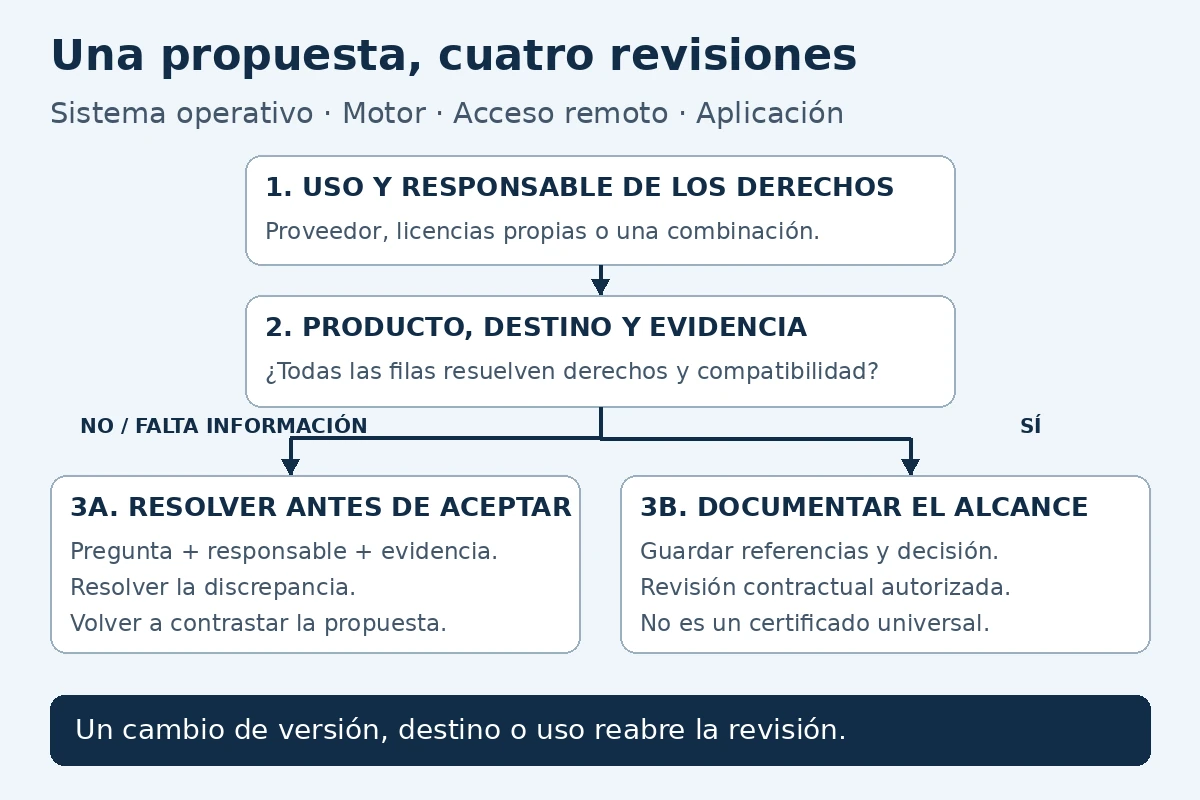
El flujo en texto: identifica cada producto y quién aporta sus derechos; contrasta uso, destino y evidencia. Si falta información o existe una discrepancia, no aceptes esa configuración: asigna responsable, obtén respuesta y repite la revisión. Si las filas se resuelven, conserva el alcance y las referencias revisadas. Un cambio posterior de versión, destino o uso vuelve a abrir las filas afectadas.
1. Separa derecho, activación y compatibilidad
El derecho de uso surge de las condiciones aplicables al producto y a su adquisición o servicio contratado. Debe contrastarse con el uso previsto. La activación es un mecanismo técnico que puede formar parte del producto; observar que funciona no resuelve todas las preguntas contractuales. La compatibilidad requiere comprobar versiones y funciones del sistema: disponer de derechos no demuestra que una integración vaya a funcionar.
Las condiciones generales de software de Microsoft separan derechos de uso y medidas técnicas de activación. Escribe las tres conclusiones por separado. Por ejemplo: «documentación pendiente del despliegue alojado», «estado técnico por verificar» y «versión admitida por el fabricante de la aplicación». Eso resulta más claro que marcar todo como aprobado porque el programa abrió una vez.
En productos Microsoft, los Product Terms permiten consultar derechos y modelos de licencia por producto, programa y publicación. La propia página indica que debe seleccionarse el programa y que la aplicación de actualizaciones depende del acuerdo del cliente. No copies la primera ficha que aparezca como si fuera el contrato de todas las empresas.
2. Haz el inventario por producto y función
Empieza por el sistema operativo, el motor de base de datos y la aplicación de negocio. Añade componentes que suelen quedar fuera de una cotización inicial: acceso remoto, módulos adicionales, herramientas de respaldo, agentes y productos de administración. Incluye también entornos de prueba o contingencia que existirán realmente, sin asumir que se cubren igual que producción.
Para cada elemento, distingue lo que ya tiene la empresa de lo que aportaría el proveedor. Indica quién custodia la evidencia y quién puede resolver una duda con el fabricante o distribuidor. No hace falta publicar claves, números de serie ni documentos completos en la matriz que circula para comparar ofertas: usa referencias a un repositorio interno autorizado.
- Producto exacto: nombre, edición y versión; no sólo «Windows», «SQL» o «ERP».
- Uso previsto: producción, prueba, acceso de usuarios, servicio alojado u otra función documentada.
- Destino: proveedor, tipo de entorno y referencia de VM o host según corresponda.
- Métrica: la definida por los términos aplicables, sin convertir usuarios concurrentes en usuarios autorizados automáticamente.
- Responsabilidad: quién contrata, asigna, revisa renovaciones y conserva evidencia.
La capacidad técnica se estudia por separado. Reducir recursos para que una cifra parezca más barata puede perjudicar el funcionamiento y no necesariamente cambiar la métrica contractual como esperas. No hay un porcentaje universal de holgura de CPU o memoria que determine si una licencia es correcta.
3. Compara modalidades sin asumir portabilidad
Los nombres comerciales ayudan a orientar la conversación, pero el derecho concreto depende del producto y del acuerdo. Pide al oferente que identifique la modalidad y sus límites con evidencia, no que sólo escriba «licencias incluidas» al final de la propuesta.
Licencias aportadas por el proveedor
Pregunta qué producto, edición y uso cubre la cuota, quién es el licenciatario y qué ocurre al terminar el servicio. En Microsoft SPLA, el proveedor obtiene derechos para ofrecer determinados servicios de software; la guía oficial identifica al proveedor, no al usuario final, como licenciatario en ese escenario. No equivale a que el cliente reciba una licencia perpetua transferible.
La guía oficial de SPLA remite a los SPUR para derechos por producto y establece condiciones del programa. Tampoco debe presentarse como un permiso para alojar cualquier producto en cualquier nube: el proveedor debe confirmar la elegibilidad del despliegue y de los terceros que participan.
Licencias propias de la empresa, o BYOL
BYOL describe que pretendes aportar derechos existentes; no demuestra que sean elegibles para el destino. Comprueba producto, programa, modalidad de adquisición, condiciones de externalización y requisitos adicionales que correspondan. La orientación oficial de Microsoft sobre outsourcing distingue escenarios y proveedores, así como opciones específicas de movilidad y virtualización. No todos se aplican a todas las licencias.
Una respuesta útil identifica el supuesto que se está usando y la evidencia pendiente. «Ya pagamos el software» o «el servidor es dedicado» no deberían cerrar la revisión sin examinar los términos aplicables.
Suscripción directa o combinación de esquemas
Documenta duración, renovación, cambio de cantidad y derechos al terminar. No presupongas descuento, soporte técnico completo o actualización a cualquier versión por el hecho de pagar una suscripción. Si combinas productos del proveedor con licencias propias, cada fila necesita su propia evidencia; no basta una etiqueta general para todo el servidor.
Qué pedir según la ruta elegida
- Todo lo aporta el proveedor: solicita un anexo por producto, su modalidad y los límites de uso. Si la respuesta es sólo «licencias originales», todavía faltan alcance y responsabilidad.
- La empresa aporta licencias: primero identifica el producto y acuerdo; después contrasta su elegibilidad con el destino exacto. No empieces por instalar para ver si activa.
- Hay una mezcla: une ambos expedientes y comprueba las dependencias. Por ejemplo, que la versión del host aportado sea compatible con el acceso remoto que pretende aportar la empresa. Una fila válida por separado puede no servir en la combinación propuesta.
La salida de este recorrido es una lista de evidencias y decisiones pendientes, no un resultado automático de cumplimiento. La distinción entre externalización y movilidad está desarrollada en la guía de outsourcing de Microsoft; los términos concretos siguen dependiendo del producto y programa.
El acceso remoto merece una comprobación específica. Microsoft distingue CAL por usuario o dispositivo y SAL en escenarios de proveedor. Evita traducir «diez sesiones simultáneas» a «diez licencias» sin verificar el modelo. Tampoco asumas que una licencia de acceso de cualquier versión sirve para cualquier host: revisa la compatibilidad de versiones de RDS CAL documentada por Microsoft. La cantidad y la compatibilidad deben validarse para la modalidad real.
4. Usa una matriz que deje visibles los pendientes
La matriz no es un certificado. Sirve para enlazar uso, condiciones y evidencia, y para que un responsable resuelva discrepancias antes de contratar. Repite esta ficha por producto y modalidad; si un mismo producto tiene usos diferentes, separa las filas en lugar de esconderlos en una nota.
Abrir ficha de derechos y asignación
- Producto, edición y versión: ___
- Función y entorno de uso: ___
- Titular o licenciatario y modalidad contratada: ___
- Proveedor y destino VM/host, mediante referencia interna: ___
- Métrica aplicable y cantidad justificada: ___
- Usuarios, dispositivos u otros elementos cubiertos, según el modelo: ___
- Programa, documento de términos y publicación consultados: ___
- Evidencia de adquisición o inclusión en servicio, mediante referencia: ___
- Renovación, vigencia y responsable de seguimiento: ___
- Condiciones relevantes para pruebas, contingencia o traslado: ___
- Estado: comprobado, pendiente o no aplicable con justificación: ___
- Pregunta pendiente, destinatario y fecha de resolución: ___
Expediente trabajado: una propuesta mezclada que todavía no puede aceptarse
Ejemplo completamente hipotético, no cliente ni validación real. Una empresa quiere alojar un ERP, un motor SQL Server comercial y acceso remoto para doce personas que trabajan en dos turnos. Su propuesta inicial indica Windows Server 2025 aportado por el proveedor; la empresa pretende usar derechos propios del motor y doce RDS CAL 2022 por usuario. El ERP tiene una suscripción separada. Los datos son entradas del ejercicio, no una recomendación de arquitectura ni una cuenta universal de licencias.
La responsable interna reúne contratos y coordina respuestas; el proveedor identifica su oferta; el fabricante o canal competente aclara las condiciones que le corresponden. Que sólo seis personas se conecten a la vez no transforma automáticamente las doce identidades en seis licencias: la métrica debe corresponder al modelo contratado. Microsoft explica la diferencia entre RDS CAL por usuario y por dispositivo; aquí el supuesto elegido es por usuario, no concurrencia.
Fila 1. Sistema operativo aportado por el proveedor
- Entrada: cotización que dice «Windows Server 2025 incluido», sin identificar todavía edición, modalidad ni condiciones de salida.
- Pregunta y responsable: el proveedor debe precisar esos elementos y confirmar el escenario alojado y sus obligaciones.
- Evidencia solicitada: anexo identificable de la oferta, que conecte producto y despliegue con la modalidad aplicable. No se pide compartir claves en una hoja pública.
- Resultado inicial: pendiente documental. Que la máquina esté activada no reemplaza el anexo. Si se usa SPLA, los derechos del proveedor y los SPUR deben revisarse en su contexto, como explica la guía oficial del programa.
Fila 2. Motor SQL Server aportado por la empresa
- Entrada: existe una factura antigua, pero falta confirmar edición, versión, programa, métrica y derechos para ese destino.
- Pregunta y responsable: la persona que custodia las licencias debe localizar el acuerdo y obtener la aclaración de elegibilidad con el canal competente; el proveedor aporta la identidad y características del alojamiento necesarias para contrastarlo.
- Evidencia solicitada: referencia del acuerdo, producto y derechos aplicables; cálculo de cantidad según esa métrica, no según una cifra improvisada de memoria o sesiones.
- Resultado inicial: no se acepta la suposición BYOL. La documentación de externalización diferencia opciones que no son intercambiables. No elegimos un modelo de SQL Server en este ejercicio porque las entradas todavía no lo justifican.
Fila 3. Acceso remoto con discrepancia decisiva
- Entrada: RDS CAL 2022 por usuario frente a un host Windows Server 2025.
- Comprobación: la matriz oficial de compatibilidad indica que las CAL 2022 no habilitan acceso a un host 2025. Disponer de doce no corrige esa diferencia de versión.
- Resultado inicial: la configuración propuesta no se acepta en esos términos. Hay que revisar una alternativa compatible y su modalidad, o una plataforma diferente que también admita el ERP. No se cambia la versión del servidor por intuición.
- Qué cambia la decisión: una propuesta revisada con acceso de versión compatible y derechos aplicables documentados, no una prueba de inicio de sesión. Si el servicio pasa a una modalidad del proveedor, se vuelve a comprobar esa modalidad; no se llama CAL a cualquier acceso contratado.
Fila 4. ERP con suscripción independiente
- Entrada: suscripción de la aplicación, pero sin confirmación de uso alojado, componentes requeridos ni compatibilidad de la versión propuesta.
- Pregunta y responsable: el fabricante o responsable contractual del ERP debe confirmar derechos y condiciones; el equipo técnico revisa por separado la matriz de compatibilidad y funciones necesarias.
- Evidencia solicitada: contrato o términos de la aplicación, documentación de versión e identificación de módulos cubiertos.
- Resultado inicial: pendiente. No se atribuyen reglas de Microsoft a una aplicación de otro fabricante ni se da por hecho que la cuota del ERP cubra Windows, SQL Server y acceso remoto.
Decisión de la primera revisión: no aceptar la propuesta tal como está. Hay una discrepancia objetiva de versión en RDS y tres filas con información que falta. «Cuatro productos instalados» no equivale a «cuatro productos documentados». Un pendiente documental no prueba por sí solo un uso ilegal; sí impide concluir que el expediente está completo.
Cómo cerraría el mismo ejercicio: el proveedor entrega un anexo revisado del sistema operativo; la revisión de SQL Server concluye que no puede darse por acreditado el BYOL con lo disponible y se solicita otra modalidad documentada en la oferta; la propuesta conserva el host 2025 y sustituye las CAL 2022 por CAL 2025, con cantidad, elegibilidad y derechos documentados para el escenario concreto; el fabricante del ERP confirma el escenario y versión. La responsable interna registra las referencias y verifica que la nueva cotización corresponde a esas cuatro decisiones. En el caso ficticio, ése sería el punto para aceptar el alcance documentado, sujeto a la revisión contractual autorizada, no para emitir un certificado universal.
Contraprueba: si sólo se cambia la versión de las CAL y SQL Server continúa sin modalidad acreditada, se cierra la discrepancia de versión de la fila 3, pero la decisión conjunta sigue pendiente. Si, por el contrario, el proveedor propone un host 2022, la matriz RDS deja de mostrar esa incompatibilidad concreta; todavía se deben comprobar los demás derechos y que el ERP admita ese host. Ninguno de los dos cambios aprueba automáticamente las otras filas.
Qué obligaría a abrir el expediente otra vez: cambiar el destino del alojamiento, agregar un entorno, alterar los usuarios o la métrica aplicable, renovar bajo condiciones distintas o instalar una versión no contemplada. Conserva la versión aceptada de la propuesta; no la sobrescribas con una lista sin fecha que impida reconstruir la decisión.
La plantilla no envía datos ni valida licencias automáticamente. Conserva documentos y claves por los canales internos autorizados; las personas que comparan propuestas no siempre necesitan acceso a todos los secretos o datos contractuales.
5. Revisa crecimiento, migración y salida
Una matriz correcta hoy puede quedar incompleta después de un cambio. Antes de ampliar, pregunta qué sucede si aumentan recursos, usuarios o dispositivos; si se mueve una VM; si aparece un entorno adicional; o si cambia el proveedor que aloja el servicio. No todas las métricas siguen el mismo evento y no todas las reasignaciones tienen las mismas condiciones.
Incluye la salida del servicio. Aclara qué datos y configuraciones pueden recuperarse, qué derechos dejan de estar disponibles y qué tendría que contratarse para operar en el siguiente destino. La exportación de una máquina o de una copia de datos no debe confundirse con la transferencia de todas las licencias que hacían posible usarla.
También distingue una renovación comercial de una actualización técnica. Tener derechos para una versión no significa que la aplicación la soporte; continuar con una versión antigua puede plantear otras preguntas de soporte. El plan necesita responsables de ambas verificaciones.
6. Pide evidencia y servicio con alcance claro
Una propuesta comparable desglosa infraestructura, licencias y administración. Debe identificar qué está incluido, cómo se calcula, qué se renueva y qué queda pendiente. Las condiciones de soporte, parches y mantenimiento se pactan expresamente: el licenciamiento correcto no hace que los parches se instalen solos ni garantiza una respuesta del fabricante en un tiempo determinado.
Compara una VM sola con un servicio, no dos cifras incompletas
Antes de elegir, iguala el alcance: mismos productos y modalidad válida, condiciones del alojamiento, responsabilidades y tratamiento de cambios. Si una propuesta deja por resolver SQL Server o acceso remoto, su importe no es todavía comparable con una oferta que sí los incluye. Agrega esos costes comprobados o mantén la comparación como incompleta; no rellenes el hueco con cero.
Ejemplo de coste hipotético, no tarifa ni ahorro medido: después de igualar infraestructura y licencias, un servicio de administración cuesta 900 MXN mensuales más e incluye el inventario, seguimiento de renovaciones y coordinación de cambios descritos. Si valoras el trabajo interno en 300 MXN por hora, 900 ÷ 300 = 3 horas mensuales. Ése es el tiempo que tendría que ahorrar para compensar por sí solo la diferencia en este modelo simple. Con una hora evitada, el valor sería 300 MXN; con cuatro, 1,200 MXN. No se ha demostrado que el servicio ahorre esas horas.
Usa importes sobre la misma base de impuestos y periodicidad, y añade costes iniciales cuando existan. No conviertas menor carga administrativa en una garantía de uptime ni asignes a una interrupción evitada un valor inventado. Si los derechos y servicios no son equivalentes, primero resuelve la diferencia de alcance y luego calcula.
Si tu equipo ya mantiene el inventario, tiene acceso al fabricante o canal competente y puede revisar cambios y renovaciones, quizá no necesites contratar administración adicional. También puedes pedir una revisión puntual, trabajar con otro proveedor o, si la aplicación lo permite y satisface tu necesidad, comparar su modalidad SaaS. Esta última no elimina toda responsabilidad: cambia qué administra cada parte y debe contrastarse con sus condiciones.
Para separar las licencias de la capacidad y del alcance operativo, consulta la comparación de dedicado y VPS para escritorio remoto. No uses esa comparación como una regla de licenciamiento.
El acompañamiento experto puede justificar un coste mayor cuando reduce horas de inventario, coordina preguntas con los responsables y mantiene el expediente actualizado. Compara ese trabajo concreto frente a una oferta que sólo entrega una VM. No compres una promesa genérica de quedar protegido frente a cualquier auditoría.
Puedes pedir a Cobalt Blue Web u otro proveedor una propuesta que explique licencias y responsabilidades para tu escenario. Solicita confirmación escrita de lo que pueden revisar y de las dudas que requieren al fabricante o a un asesor especializado. Para iniciar esa conversación, comparte productos, versiones, modalidad que aporta cada parte y la pregunta pendiente. No envíes claves, credenciales ni contratos completos por un formulario general.
7. Usa IA para revisar coherencia, no para inventar derechos
Una herramienta de IA puede ayudar a detectar filas incompletas, comparar descripciones depuradas o convertir una duda en una pregunta para el proveedor. No le entregues claves, credenciales o acuerdos confidenciales por un canal no aprobado. Trabaja con referencias y ejemplos sintéticos siempre que sea suficiente.
Una instrucción útil sobre datos sintéticos sería: «Compara estas cuatro filas con los documentos que adjunto. Para cada diferencia, cita la sección exacta, separa lo demostrado de lo pendiente y redacta la pregunta que falta responder. Si el documento no permite concluir, escribe “no determinado”. No deduzcas derechos a partir de activación». Revisa después que las citas existan y correspondan al programa y fecha adecuados.
Exige que cualquier conclusión señale el producto, programa, documento y supuesto en que se basa. Una respuesta sin esos elementos puede sonar precisa y seguir siendo inaplicable. La decisión final debe apoyarse en los términos correspondientes y en la revisión de las personas autorizadas, no en una afirmación automática de cumplimiento.
Velocidad, continuidad y ventas en un mismo movimiento
CRM en Cloud para equipos remotos no es solo una opción cómoda; es la vía más rápida para habilitar ventas distribuidas, soporte al cliente y dirección comercial con tiempos de aprovisionamiento mínimos. Además, al ejecutarlo en un entorno administrado con alta disponibilidad y respaldo, podrás estandarizar procesos, reducir errores y, sobre todo, mejorar la visibilidad del pipeline en tiempo real. En consecuencia, tus gerentes tomarán decisiones con datos confiables, mientras tus agentes atienden oportunidades sin fricción, incluso durante picos de tráfico.
Por qué CRM en Cloud para equipos remotos acelera el “time-to-value”
Primero, porque evita esperas de compras de hardware y configuraciones extensas. Asimismo, al desplegarse en servidores virtuales optimizados, el CRM queda disponible en cuestión de horas, con usuarios, perfiles y conexiones seguras listos para operar. En segundo lugar, al centralizar leads, tareas y comunicaciones, se reducen cuellos de botella y, por lo tanto, mejora la tasa de conversión. Finalmente, gracias al acceso desde cualquier lugar, la adopción es mayor y la productividad no depende de una oficina física.
Componentes críticos: latencia, seguridad y continuidad
Para que la experiencia sea realmente “express”, conviene revisar tres pilares:
-
Baja latencia: cuanto menor sea, más fluida será la navegación, el guardado de notas y la edición de oportunidades. Además, disminuye el abandono de usuarios.
-
Seguridad y cumplimiento: autenticación robusta, cifrado en tránsito y en reposo, segmentación de redes y políticas de acceso por rol.
-
Continuidad operativa: respaldos automáticos, restauración validada y alta disponibilidad para tolerar fallos.
Por cierto, si ya administras nómina u otros sistemas en la nube, puedes alinear políticas y calendarios de mantenimiento para evitar choques de ventanas. Como referencia, revisa servidores cloud para nóminas y mejores prácticas relacionadas aquí: https://servidoresparasistemas.mx/servidores-cloud-para-nominas-evita-multas/
Arquitectura recomendada para CRM en Cloud para equipos remotos
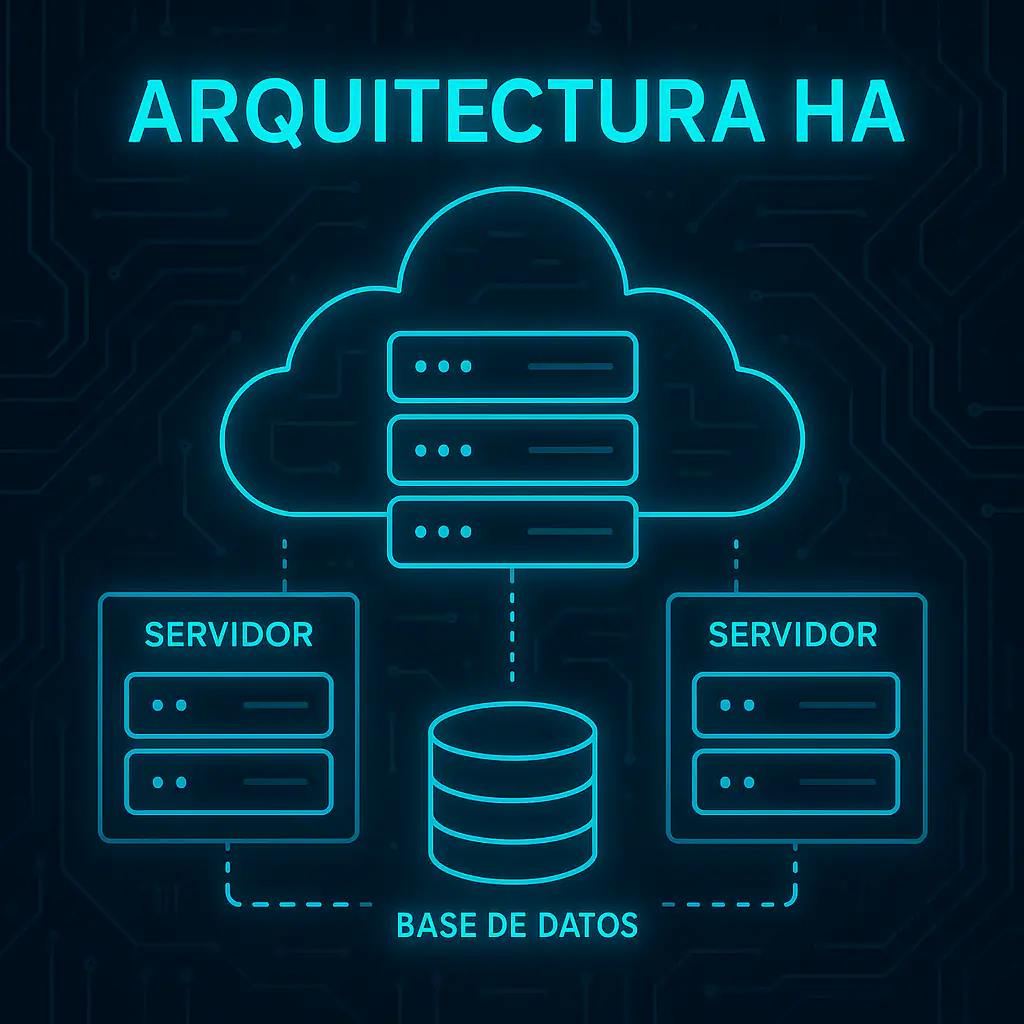
Aunque cada CRM varía, una arquitectura viable suele incluir:
-
VPS o clúster de VPS para aplicación y base de datos con aislamiento de recursos.
-
Balanceador (si aplica) para distribuir carga y facilitar escalamiento horizontal.
-
Almacenamiento optimizado para IOPS consistentes, ya que, de lo contrario, se resentirá el rendimiento de reportes.
-
Capa de seguridad con firewall administrado, listas de control y reglas de acceso por IP/rol.
-
Copias de seguridad diarias y retención por política; además, pruebas de restauración periódicas.
Si tu CRM integra marketing automation o telefonía, conviene planear picos de CPU y RAM en campañas y cierres mensuales. Así, evitarás degradación del servicio.
Dimensionamiento práctico (y cómo no quedarse corto)
Para 10–25 usuarios concurrentes con actividades mixtas (registro de leads, llamadas, tareas y dashboards), empieza con un VPS de 4–8 vCPU y 8–16 GB de RAM, discos NVMe y 1 Gbps. Sin embargo, si ejecutas reportes pesados, considera separar la base de datos en una instancia dedicada. De esta manera, mantendrás la aplicación ágil mientras procesas analítica. Adicionalmente, prepara “burst capacity” para cierres de trimestre.
Si ya operas otras cargas críticas (ecommerce, ERP), evalúa consolidar o separar “noisy neighbors”, porque un mal reparto de recursos afecta a todos. Para casos con CRM + sitios transaccionales, aquí tienes una guía sobre servidores de web hosting para bases de datos: https://servidoresparasistemas.mx/servidores-de-web-hosting-para-bases-de-datos/
Seguridad avanzada sin fricción para el usuario final
Aunque incrementar barreras de acceso suele percibirse incómodo, un diseño correcto minimiza fricciones:
-
Autenticación multifactor (MFA) con llaves o apps móviles.
-
Cifrado TLS en tránsito y cifrado de volúmenes en reposo.
-
Roles mínimos necesarios: ventas, soporte, dirección; además, permisos temporales para consultores.
-
Registros y auditoría: trazabilidad de cambios, descargas y exportaciones.
-
Backups verificados: no basta con hacerlos; hay que restaurar de forma controlada para validar integridad.
Así, se previene pérdida de datos, se cumple con auditorías y se evitan sanciones.
Integraciones: del correo a la analítica ejecutiva
Para que CRM en Cloud para equipos remotos rinda al máximo, integra:
-
Correo y calendarios: registro automático de interacciones; por lo tanto, menos tareas manuales.
-
Telefonía/VoIP: click-to-call y grabaciones asociadas a la oportunidad.
-
Facturación y BI: desde tableros de margen por vendedor hasta alertas de churn.
-
Formularios web: leads directos al CRM con reglas de asignación y SLA.
Con integraciones bien resueltas, el CRM deja de ser una lista de pendientes y se convierte en el sistema nervioso de la operación comercial.
Implementación express: checklist de 10 pasos
Para pasar de cero a productivo en horas, utiliza este flujo:
-
Definir alcance (usuarios, permisos, pipelines).
-
Seleccionar infraestructura (VPS administrado, HA opcional).
-
Endurecer seguridad (MFA, roles, restricciones IP).
-
Instalar CRM y dependencias (cuidar versiones y compatibilidad).
-
Configurar dominios y TLS.
-
Cargar catálogos (etapas, productos, razones de pérdida).
-
Integrar correo/calendario.
-
Crear tableros ejecutivos.
-
Probar respaldos y restauración.
-
Capacitar y lanzar con guías abreviadas.
De esta manera, reduces resistencia al cambio y aceleras la adopción.
Rendimiento: cómo sostener la velocidad a medida que creces
A medida que suben los usuarios y registros, conviene:
-
Monitoreo de CPU, RAM, I/O, latencia y errores de aplicación.
-
Índices y mantenimiento en la base de datos para evitar “table scans” costosos.
-
Purga/archivado de adjuntos pesados y registros obsoletos.
-
Escalamiento vertical/horizontal planificado, especialmente en cierres de trimestre.
Además, instrumenta alertas proactivas para prevenir incidentes en horas crítica.
Alta disponibilidad: cuándo vale la pena
Si tu operación no puede detenerse, una configuración activo-pasivo o multi-zona reduce el impacto de fallas. Sin embargo, al evaluar costos, compáralos con pérdida potencial de ventas por minuto de caída. A menudo, un esquema con réplicas y failover automatizado justifica la inversión.
Casos de uso típicos de CRM en Cloud para equipos remotos
-
Fuerzas de ventas distribuidas con metas semanales y territorios.
-
Soporte y Customer Success con colas, SLAs y playbooks.
-
Canales y partners que requieren acceso segmentado y reporteo unificado.
-
Field service que documenta visitas, evidencias y seguimientos desde móvil.
En todos, la nube elimina barreras geográficas y mejora consistencia operativa.
Métricas que importan: CRM en Cloud para equipos remotos
Para dirigir con foco, prioriza:
-
Lead Velocity Rate (LVR) y tasa de conversión por etapa.
-
Tiempo de respuesta al primer contacto.
-
Valor de oportunidad por vendedor/territorio.
-
Churn de clientes y expansión (upsell/cross-sell).
-
Tiempo promedio de cierre y cumplimiento de SLA.
Así, podrás corregir a tiempo y asignar recursos donde más impacto generan.
Roadmap de madurez: de básico a avanzado
-
Fase 1: consolidar datos, definir pipeline y roles.
-
Fase 2: automatizar tareas, SLA y plantillas.
-
Fase 3: analítica avanzada, pronósticos y playbooks por segmento.
-
Fase 4: orquestación con marketing, ERP y finanzas.
Con este recorrido, el CRM evoluciona de una libreta digital a un motor de crecimiento.
CRM en Cloud para equipos remotos
-
Si buscas una implementación express con soporte experto, pide una propuesta en Cobalt Blue Web
-
Para elegir el tamaño correcto de tu VPS administrado para CRM, revisa planes y especificaciones
-
Cuando necesites ajustes finos de seguridad y alta disponibilidad, conversa con un arquitecto de soluciones.
-
¿Listo para lanzar tu CRM en Cloud para equipos remotos en horas? Solicita el plan adecuado aquí: Cobalt Blue Web
Un proceso de nómina exige exactitud y continuidad. Por esa razón, Servidores Cloud para Nóminas resultan críticos cuando hay calendarios inflexibles, cálculos sensibles y timbrado CFDI. Asimismo, al manejar datos personales, percepciones y deducciones, la seguridad debe ser estricta. Por lo tanto, si dimensionas mal CPU, RAM o IOPS, o si los respaldos no son consistentes, terminarás con errores de pago, recálculos y, peor aún, multas. A continuación, verás cómo elegir, configurar y operar una plataforma de nómina en la nube sin tropiezos.
Por qué Servidores Cloud para Nóminas evitan multas
Primero, porque estabilizan rendimiento en periodos pico (quincenas, cierres y aguinaldos). Además, al separar roles (base de datos, aplicación, escritorios) y al utilizar NVMe con IOPS garantizadas, disminuyen los tiempos de consulta y el riesgo de bloqueos. Igualmente, al incluir RPO/RTO explícitos, aseguran restauraciones rápidas si algo falla antes del timbrado. Finalmente, al contar con soporte 24/7, evitan que una alerta nocturna se convierta en un incidente masivo a la mañana siguiente.
Lectura de contexto interno: si alguna vez intentaste operar nóminas en planes mínimos, sabrás que qué ERP no funciona en VPS de 5 USD te explica, con números, por qué el “ahorro” sale caro en cierres.
Para dimensionar desde hoy y evitar retrasos de pago, revisa estos planes de servidores virtuales cloud VPS y elige perfiles con NVMe e IOPS garantizadas.
Requisitos técnicos base para nómina sin cuellos de botella
Aunque cada motor cambia, para 20–60 empleados con cálculos, incidencias y timbrado concurrente, conviene iniciar con:
-
CPU: 6–8 vCPU dedicadas (evita “burstable”).
-
RAM: 16–32 GB, según el motor y el tamaño de catálogos.
-
Almacenamiento: NVMe con IOPS garantizadas; separa SO / datos / respaldos.
-
Red: IP fija y QoS para RDP/HTTPS; evita pérdida y jitter en corte de nómina.
-
Seguridad: MFA, listas por IP y TLS actualizado.
-
Backups: RPO de 15–60 min en días de nómina; RTO ≤ 2 h.
Si tu nómina convive con inventarios o POS, los picos combinados pueden afectar. Por eso, además de separar volúmenes, conviene aislar cargas. En ese sentido, explora servidores para inventario y logística y opciones para sistemas de punto de venta para evitar contención.
Seguridad y respaldo doble en Servidores Cloud para Nóminas
El cumplimiento no solo depende del cálculo correcto; también exige trazabilidad. Por ello:
-
Cifrado en tránsito (TLS 1.2/1.3) y en reposo (volúmenes cifrados con rotación de llaves).
-
MFA obligatorio en paneles, RDP y VPN.
-
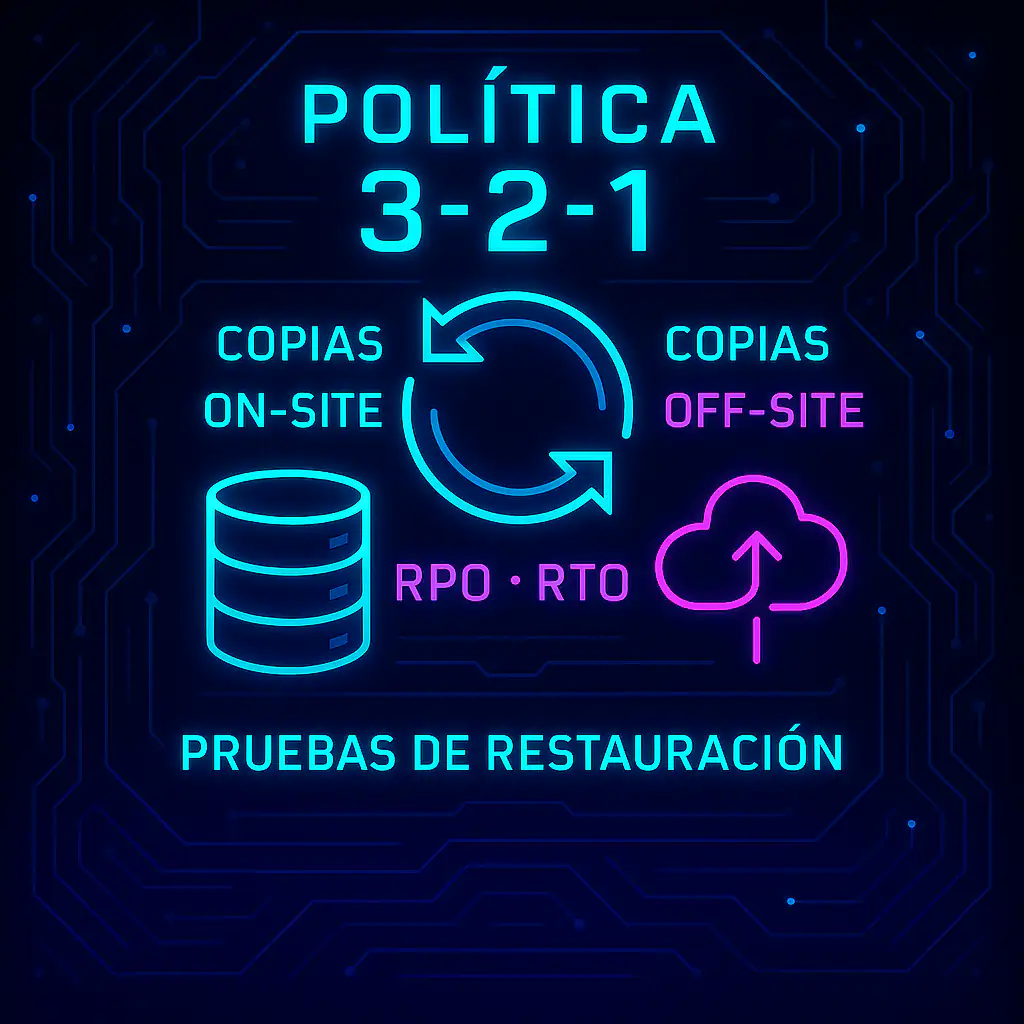
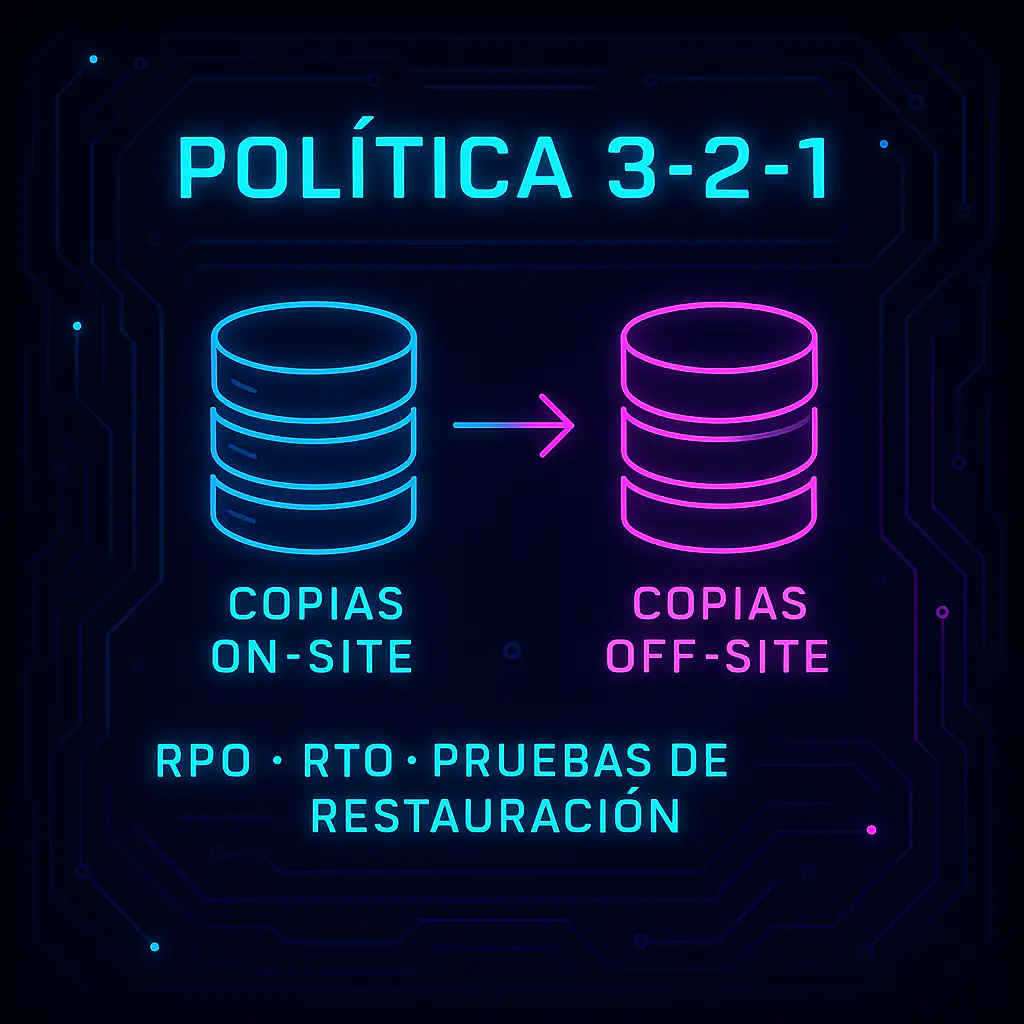
Respaldos doble con verificación: política 3-2-1, restauraciones de muestra y smoke tests (login, cálculo de prueba, timbrado ficticio).
-
Retención de respaldos y XML conforme a política fiscal.
-
Bitácoras firmadas de cambios y accesos.
Si además manejas carteras o recordatorios de pago, conviene revisar servidores optimizados para sistemas de cobranza para equilibrar tráfico y procesos de nómina sin interferencias.
Si prefieres una evaluación técnica y una guía de endurecimiento (MFA, WAF, segmentación), solicita servicios de nube para empresas y obtén un plan de seguridad aplicado a nómina.
Arquitectura recomendada: capas y desempeño
Para no colapsar en quincenas:
-
Separación de roles: VM de base de datos y VM de aplicación/escritorios.
-
Almacenamiento dedicado: volúmenes NVMe independientes para datos activos y para respaldos.
-
Segmentación de red: listas de control por IP; evita todo-a-todos.
-
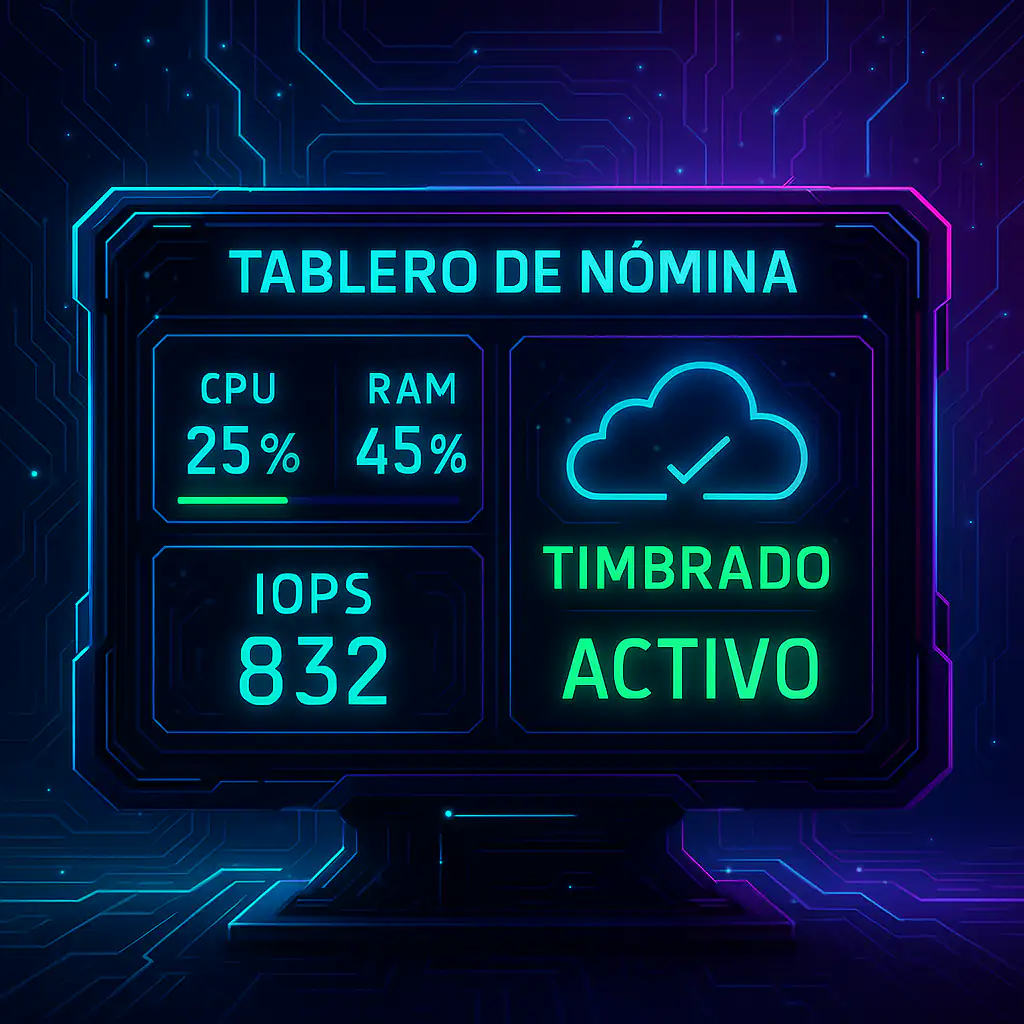
Monitorización proactiva: CPU por vCPU, memoria libre (>25%), latencia <5 ms, longitud de cola e IOPS por volumen.
-
Ventanas de mantenimiento: parches y actualizaciones fuera del calendario de pago.
Además, si convives con plataformas educativas o intranets, no mezcles cargas intensivas de archivos en la misma instancia; para eso existen VPS para Moodle o repositorios separados.
Plan operativo para la quincena y el cierre
-
D -7 a D -3: validar inventario de incidencias y ausencias; depurar catálogos.
-
D -2: congelar versiones y ejecutar respaldo punto en el tiempo.
-
D -1: pruebas con lote de muestra; verificación de timbrado ficticio.
-
D 0 (día de pago): monitoreo reforzado, tabla de umbrales y canal prioritario con soporte.
-
D +1: validación de recibos, dispersión y conciliación; respaldo post-proceso.
Con este calendario, reduces improvisaciones y, en consecuencia, disminuyes la probabilidad de error humano.
Recuperación: si algo falla, que no te tome por sorpresa
Incluso con buenas prácticas, los incidentes ocurren. Por eso, documenta un runbook de recuperación:
-
Declarar incidente y abrir bitácora.
-
Determinar alcance (servicio, base, red o licenciamiento).
-
Elegir restauración a punto en el tiempo compatible con tu RPO.
-
Validar con smoke tests y abrir gradualmente.
-
Comunicar a RR. HH. y Finanzas cada avance con tiempos reales.
Cuando el problema es crítico (corrupción, caída total), aplica el protocolo de recuperación urgente que proponemos en ERP en la Nube Urgente: levántalo en horas y evita perder una nómina completa.
Tiempos, licencias y auditoría
La nómina involucra licencias del ERP, de la base de datos y, a veces, de timbrado. En consecuencia, registra versiones, fechas, números de serie y períodos de vigencia. Además, conserva evidencia de cada pago y de cada corrección, y sincroniza XML y acuses. Así, ante una auditoría, demostrarás trazabilidad y control.
Checklist de contratación de Servidores Cloud para Nóminas
-
Perfil de CPU/RAM acorde al número de empleados y complejidad de incidencias.
-
NVMe con IOPS garantizadas y latencia medida.
-
Respaldos doble con restauración de muestra aprobada.
-
RPO/RTO escritos y probados.
-
MFA, listas por IP y TLS al día.
-
SLA de soporte con primera respuesta y escalamiento.
-
Monitoreo con alertas por CPU, IOPS, espacio y caducidad de certificados.
-
Bitácora de cambios y evidencias para auditoría.
Si cumples esta lista, tus probabilidades de multa por error de cálculo, timbrado tardío o falta de evidencia se reducen drásticamente.
Con Servidores Cloud para Nóminas dimensionados y asegurados, tus quincenas dejan de ser una ruleta. Debido a la mezcla de NVMe, RPO/RTO, cifrado, MFA y soporte real, el proceso gana estabilidad, y, además, Finanzas obtiene visibilidad y trazabilidad. Finalmente, con un checklist claro y un plan de recuperación probado, cumplirás con nómina a la primera y sin sanciones.
¿Necesitas que un ingeniero te acompañe en la ventana de pago? Contáctanos aquí y agenda guardia técnica con métricas y reporte final.
¿Listo para cerrar la próxima quincena sin sobresaltos? Elige tu plan en servidores virtuales cloud VPS y solicita acompañamiento de implementación 24/7.
Empecemos por lo esencial: ERP no funciona en VPS de 5 USD no significa que seas “exigente”; significa que ese plan es insuficiente por diseño. De hecho, dichos VPS suelen ser instancias compartidas con CPU “burstable”, poca RAM, discos lentos y sin acuerdos de servicio reales. Además, normalmente carecen de licencias de Windows Server y de SQL Server, elementos indispensables para muchos ERPs de escritorio. Por lo tanto, aun cuando “arranque”, el sistema se volverá inestable, especialmente durante cierres de mes, auditorías o timbrado masivo.
ERPs que no funcionan (o no funcionan bien) en un VPS de 5 USD
1) ERPs de escritorio Windows con SQL Server (CONTPAQi, Aspel SAE, Microsip, SAP B1 on-prem)
En este grupo, el cuello de botella aparece por todos lados: CPU insuficiente para consultas, RAM escasa para cachés, y, sobre todo, IOPS muy bajas cuando el motor de base de datos escribe y lee simultáneamente. Asimismo, el propio RDP añade consumo. En consecuencia, un plan de 5 USD colapsa con 5–10 usuarios concurrentes.
2) ERPs híbridos con conectores, impresoras y add-ons locales
Aunque el core pueda ser ligero, los conectores (bancos, timbrado, BI, impresoras remotas) disparan latencia y picos de E/S. Por eso, si la infraestructura no garantiza NVMe y ancho de banda estable, tendrás bloqueos, timeouts y archivos en uso permanente.
3) Suites didácticas o académicas con bases crecientes
Cuando el ERP convive con plataformas de capacitación, repositorios o intranets, el tráfico y los adjuntos crecen. Entonces, un VPS barato se queda sin disco, sin IOPS y sin respaldo verificado; por ende, cualquier incidente se vuelve pérdida real.
Si te interesa una visión de seguridad para tu entorno, revisa ERP seguro en la nube: cifrado + respaldos doble y estandariza prácticas mínimas.
Por qué un VPS de 5 USD no alcanza (aunque “levante” el servicio)
CPU y contención. Estos planes suelen asignar vCPU compartidas con throttle; cuando un vecino consume, tu ERP se arrastra.
RAM y swapping. Con 1–2 GB, el sistema vive intercambiando a disco; por eso, cualquier consulta pesada se multiplica en tiempos.
Disco e IOPS. Frecuentemente es almacenamiento SATA compartido; sin NVMe ni IOPS garantizadas, la cola de E/S crece y la base se bloquea.
Red y latencia. La salida puede ser medida; con RDP, impresoras y timbrado, la experiencia se degrada.
Licenciamiento. Windows/SQL no vienen incluidos; por lo tanto, terminas en escenarios ilegales o mal soportados.
Backups y RTO/RPO. “Incluye copias” no significa restauración validada; sin pruebas, el RTO es impredecible.
Seguridad. Sin WAF, MFA y segmentación, solo basta un descuido para exponer credenciales o puertos.
CTA 1 (integrado): si operas aplicaciones Windows de escritorio y deseas estabilidad real, revisa estas soluciones en la nube para apps de escritorio ERP y compáralas con tus picos de uso.
Señales de que tu ERP está subdimensionado
-
Reportes tardan >60 s en horario pico.
-
Usuarios reciben “tiempo de espera agotado” al grabar pólizas.
-
Sesiones RDP se desconectan sin razón aparente.
-
El servidor usa >75% de CPU sostenido y <25% de RAM libre.
-
La latencia de disco supera 5 ms y la longitud de cola crece.
Cuando aparezcan dos o más señales, no te pelees con el ERP: el problema es la infraestructura.
Dimensionamiento práctico: desde “mínimo viable” hasta cierre de mes
Para 10–20 usuarios en ERPs Windows con SQL Server:
-
CPU: 6–8 vCPU dedicadas.
-
RAM: 24–32 GB.
-
Disco: NVMe con IOPS garantizadas (volúmenes separados para SO, datos y backups).
-
Red: IP fija y QoS para RDP/HTTPS.
-
Seguridad: MFA, listas por IP, WAF si expones servicios web.
-
Backups: RPO 1 h, retención 14–30 días y restauración trimestral validada.
Para 30–50 usuarios y cierres exigentes:
-
CPU: 8–12 vCPU.
-
RAM: 32–48 GB.
-
Almacenamiento: NVMe 1–2 TB + réplica en otra zona.
-
Arquitectura: separar base de datos y escritorios en VMs distintas; considerar HA.
CTA 2 (integrado): si buscas alternativas administradas con monitoreo y respuesta 24/7, compara servicios de nube y VPS para empresas en México y pide sizing por carga real.
Casos típicos donde “sí o sí” fallará el VPS de 5 USD
ERP no funciona en VPS de 5 USD con RDP + impresión remota
Los drivers de impresión, PDFs y plantillas de reporte generan picos; con CPU compartida, las sesiones se congelan. Además, cualquier spooler mal configurado dispara el consumo.
ERP no funciona en VPS de 5 USD con SQL y anexos
Adjuntos y registros crecen; sin NVMe, la base “se frena”. Asimismo, el mantenimiento (reíndices, compactaciones) no se ejecuta por falta de ventana o por miedo a tirar el servicio.
ERP no funciona en VPS de 5 USD con conectores fiscales
Timbrado y consultas simultáneas dependen de latencia y certificados; con red medida y CPU burstable, los timeouts son inevitables.
¿Y si tu ERP es web o usa base MySQL/PostgreSQL?
A veces, un ERP web con MySQL en contenedor bien afinado parece correr en 1–2 GB de RAM. Sin embargo, en cuanto sube el tráfico, aparecen swaps, paradas del contenedor y retardo en queries. Además, si el VPS de 5 USD no ofrece disco NVMe, la mejora percibida es mínima. Por eso, incluso en escenarios web, conviene partir de 4 vCPU, 8–16 GB RAM y almacenamiento rápido.
Arquitecturas recomendadas según escenario
-
Monolítico mínimo viable: una VM con roles separados por volúmenes; útil para pilotos cortos.
-
Dos capas: base de datos aislada + VM de aplicación/escritorios; reduce contención y mejora IOPS útiles.
-
HA/DR básico: réplica en otra zona + cutover DNS; ideal para negocios que no pueden detener facturación.
Mientras avanzas, también conviene revisar plataformas satélite. Si tu ERP convive con e-commerce o contenidos, un hosting especializado ayuda: mira VPS para WordPress de alto rendimiento y evita que picos web afecten al ERP.
ERP no funciona en VPS de 5 USD: Seguridad y cumplimiento: mínimos no negociables
-
MFA en accesos de administración y RDP.
-
Segmentación por VLAN o SG; nada de todo-a-todos.
-
TLS actualizado y certificados monitorizados.
-
WAF delante de servicios HTTP(S).
-
Backups 3-2-1 con restauración validada y registro firmado.
Si tu entorno incluye aulas virtuales o expedientes, refuerza políticas: consulta VPS para Moodle y define retención. Igualmente, si manejas fuerza de ventas o atención con CRM, revisa VPS para CRM para aislar cargas y garantizar latencia estable.
ERP no funciona en VPS de 5 USD: ¿Cuándo un VPS barato puede servir?
Para laboratorios, demos efímeros o ambientes de desarrollo individual sin datos sensibles. Aun así, establece límites: no uses información real, no expongas puertos públicos y no prometas SLA al negocio. Para cualquier otra cosa, sal de 5 USD cuanto antes.
Cómo migrar desde un VPS de 5 USD sin cortar la operación: ERP no funciona en VPS de 5 USD
-
Levanta una infraestructura espejo dimensionada (NVMe, vCPU dedicadas, RAM holgada).
-
Restaura copias consistentes y ejecuta smoke tests (login, reporte, timbrado).
-
Ajusta drivers de impresión y perfiles RDP.
-
Haz cutover DNS/IP en ventana baja y monitorea errores 4xx/5xx.
-
Documenta tiempos reales de RTO y afina alertas (CPU, IOPS, disco libre).
CTA 3 (integrado): si necesitas acompañamiento de guardia para el cambio, contáctanos para programar una ventana con ingeniero y evita sorpresas.
ERP no funciona en VPS de 5 USD: barato sale caro
Insistir en un plan de 5 USD para producción no es ahorro, es riesgo acumulado. Porque, además de las caídas, perderás horas en soporte, reprocesos y clientes molestos. En cambio, con dimensionamiento correcto, NVMe, RPO/RTO claros y seguridad activa, tu ERP responderá como esperas incluso en cierres de mes. Finalmente, si ya mediste tus picos y quieres aterrizar una propuesta ejecutiva con métricas y calendario, da el siguiente paso.
CTA 4 (final): elige hoy una plataforma estable con planes dimensionados y soporte real en servidores virtuales cloud VPS y olvídate del cuello de botella de los 5 USD.
Un ERP seguro en la nube no se logra con una sola configuración; se construye con capas. Por eso, necesitas cifrado en tránsito y en reposo, respaldos doble con verificación, monitoreo proactivo y procedimientos de recuperación ensayados. Además, conviene medir desempeño e incorporar controles de acceso que impidan cambios no autorizados. Así, garantizarás continuidad operativa y, al mismo tiempo, reducirás el riesgo de pérdida de datos o de paros en momentos críticos.
Por qué tu negocio necesita un ERP seguro en la nube
Primero, porque el ERP concentra datos sensibles: clientes, facturas, inventarios, bancos y políticas de acceso. Por lo tanto, cualquier falla, fuga o corrupción impacta ingresos y cumplimiento. Asimismo, la nube facilita escalar, pero expone superficies nuevas: credenciales, redes públicas y servicios anexos. En consecuencia, una estrategia de seguridad debe abarcar arquitectura, procesos y personas, no solo firewalls. Además, conviene alinear esta estrategia con un calendario de cierres, auditorías y mantenimientos, para que nada quede al azar.
Lectura base recomendada: si aún evalúas tu madurez, revisa Cómo saber si tu ERP está listo para migrar a cloud y confirma compatibilidades, dependencias y ventanas.
Cifrado: en tránsito y en reposo para un ERP seguro en la nube
El cifrado protege tu información en dos momentos. Por un lado, en tránsito (TLS actualizado) entre usuarios, escritorios remotos, APIs y servicios externos. Por otro, en reposo (volúmenes cifrados y claves rotadas) dentro del almacenamiento. Además, resulta prudente aislar llaves en un servicio de KMS y rotarlas según política. Igualmente, conviene obligar MFA a administradores y a cuentas con privilegios; así, disminuyes el éxito de ataques por credenciales filtradas.
Reglas rápidas de cifrado aplicadas
-
TLS 1.2/1.3 con suites recomendadas.
-
Certificados renovados automáticamente y supervisados.
-
Volúmenes cifrados con rotación de claves.
-
MFA en paneles, VPN y escritorios remotos.
-
Registros de acceso firmados y conservados por política.
Respaldos doble: 3-2-1 con verificación automatizada
Aunque “tener backup” suena suficiente, no lo es. En realidad, un ERP seguro en la nube opera con respaldos doble y verificación periódica. Por eso, aplica la regla 3-2-1: tres copias, en dos medios distintos y una off-site. Además, automatiza pruebas de restauración (smoke tests) para asegurar que el archivo abre, la base monta y el ERP arranca. Asimismo, define RPO (frecuencia de copia) y RTO (tiempo de retorno) por proceso crítico; no todos los módulos necesitan el mismo objetivo.
-
RPO recomendado: 15–60 minutos para módulos de facturación y ventas; 1–4 horas para históricos.
-
RTO recomendado: 1–4 horas para operación diaria; ≤1 hora para puntos de venta o timbrado.
Si tienes repositorios auxiliares (expedientes, evidencias, actas o contratos), evalúa su tratamiento. En proyectos legales o educativos, los volúmenes de documentos crecen rápido; por ello, consulta Servidor para sistemas jurídicos o VPS para Moodle y planifica retención y archivado.
Arquitectura práctica: segmentación, NVMe e IOPS garantizadas
La seguridad convive con el rendimiento. En consecuencia, separa roles: una instancia para base de datos, otra para aplicación/escritorios y, si procede, un salto administrativo endurecido. Asimismo, utiliza NVMe para datos transaccionales y mide IOPS y latencia; de otro modo, los cuellos de E/S disparan tiempos de espera y tickets. Además, segmenta redes por función y limita accesos por listas IP. Mientras tanto, coloca un WAF delante de cualquier servicio expuesto y registra todo en una bitácora central.
Monitoreo y alertas que previenen incidentes
Sin monitoreo no hay ERP seguro en la nube. Por lo tanto, observa:
-
CPU por vCPU y ready time.
-
RAM utilizada vs. en caché.
-
Latencia e IOPS por volumen.
-
RTT de RDP/HTTPS y pérdidas.
-
Errores de aplicación y eventos de seguridad.
Además, configura umbrales y alertas con severidades. Así podrás escalar recursos antes de un cierre de mes y, asimismo, abrir incidentes proactivos.
Para acelerar decisiones y recibir acompañamiento experto, revisa las soluciones en la nube para aplicaciones Windows de escritorio ERP y pide una evaluación técnica de sizing y seguridad.
Gobierno de cambios: ventanas, reversión y evidencia
Cada parche requiere plan y evidencia. En consecuencia, define:
-
Ventanas fuera de horario.
-
Respaldo punto en el tiempo previo.
-
Lista de paquetes y orden de aplicación.
-
Plan de reversión si falla un paso.
-
Smoke tests posteriores (login, reporte y timbrado).
-
Bitácora firmada con tiempos reales.
Con este método, tu ERP seguro en la nube no dependerá de “héroes” y, además, superará auditorías con facilidad.
Pruebas de recuperación: del papel a la realidad
Las restauraciones solo cuentan si han sido ejecutadas. Por eso, programa simulacros trimestrales: restaura en entorno espejo, ejecuta pruebas y mide RTO. Igualmente, documenta hallazgos y corrige procesos. De esta manera, cada ensayo reduce minutos de incertidumbre durante una crisis real.
Si prefieres delegar ejecución y soporte continuo, consulta servicios de nube y VPS para empresas en México y estandariza guardias con runbooks probados.
Usuarios, accesos y mínimo privilegio
La mayoría de incidentes proviene de configuraciones laxas. Por lo tanto, aplica mínimo privilegio, elimina cuentas genéricas y revisa permisos heredados. Además, obliga MFA en accesos administrativos, registra inicios de sesión y activa alertas por intentos fallidos. Asimismo, capacita a usuarios críticos (contabilidad, facturación, compras); una sesión segura vale más que un firewall mal configurado.
Red y experiencia del usuario
La seguridad debe convivir con fluidez. En consecuencia, ubica tu región cloud cerca de usuarios, ajusta QoS y considera SD-WAN si hay múltiples sedes. Asimismo, valida drivers de impresión, redirecciones y escaneo. De esta forma, el ERP seguro en la nube será también un ERP rápido.
ERP seguro en la nube: Integraciones y datos externos
El ERP dialoga con bancos, timbrado, portales y BI. Por eso, crea conectores con certificados actualizados, limita orígenes por IP, cifra secretos y rota claves. Además, separa datos fríos en almacenamiento económico; así, el respaldo diario será más ligero y, al mismo tiempo, tu RTO disminuirá.
ERP seguro en la nube: Plan de adopción por etapas
Para aterrizar la estrategia, ejecuta en tres fases:
-
Asegurar lo esencial. Cifrado, MFA, segmentación, respaldos doble y monitoreo.
-
Optimizar el desempeño. NVMe, separación de roles, alertas por IOPS y latencia.
-
Probar y documentar. Restauraciones, ventana de parches, evidencia y mejora continua.
Si ya decidiste externalizar la operación, elige un plan administrado en VPS para empresas y delega parches, copias y respuesta a incidentes sin distraer a tu equipo.
Enlaces internos que complementan la puesta a punto: ERP seguro en la nube
Para completar el cuadro, te conviene revisar materiales del propio sitio. Por ejemplo, confirma alistamiento con ERP listo para migrar a cloud; asimismo, si manejas expedientes legales o académicos, consulta Servidor para sistemas jurídicos y VPS para Moodle para definir retenciones, archivado y seguridad de repositorios.
ERP seguro en la nube
En síntesis, un ERP seguro en la nube se basa en cifrado bien implementado, respaldos doble con restauraciones validadas, MFA obligatorio, segmentación efectiva y monitoreo constante. Además, se sostiene con gobierno de cambios, métricas claras y simulacros periódicos. Con este enfoque, tu operación será predecible incluso en picos, auditorías y cierres. Finalmente, si necesitas una guía práctica para convertir estas políticas en acciones calendarizadas, agenda una revisión con un ingeniero desde este formulario de contacto y aterriza un plan de seguridad a tu medida.
Tu ERP está listo para migrar cuando las personas responsables pueden demostrar que el destino cumple los criterios acordados y que saben qué hacer si una condición crítica falla. Que el servidor encienda, permita iniciar sesión o muestre una gráfica favorable no basta para autorizar el cambio de operación.
La decisión de continuar, o GO, debe basarse en evidencia del sistema concreto. La decisión de detenerse, o NO-GO, también es un resultado válido: evita convertir un pendiente conocido en una interrupción de negocio. Esta guía organiza las puertas de aceptación, el momento del corte y los límites del retorno. No es una receta para ejecutar cambios de red, timbrado, seguridad o bases de datos.
La salida de esta guía es un acta de decisión, no una fecha prometida. En el ensayo trabajado una exportación incorrecta detiene el corte; al corregirla, el equipo puede reconsiderarlo. En el segundo escenario, tres pedidos nuevos cambian por completo la posibilidad de volver al origen. Ambos casos son ficticios y sirven para aprender a justificar una decisión propia.
Revisa el punto que necesitas: dependencias · criterios de aceptación · registro GO/NO-GO · plan de retorno.
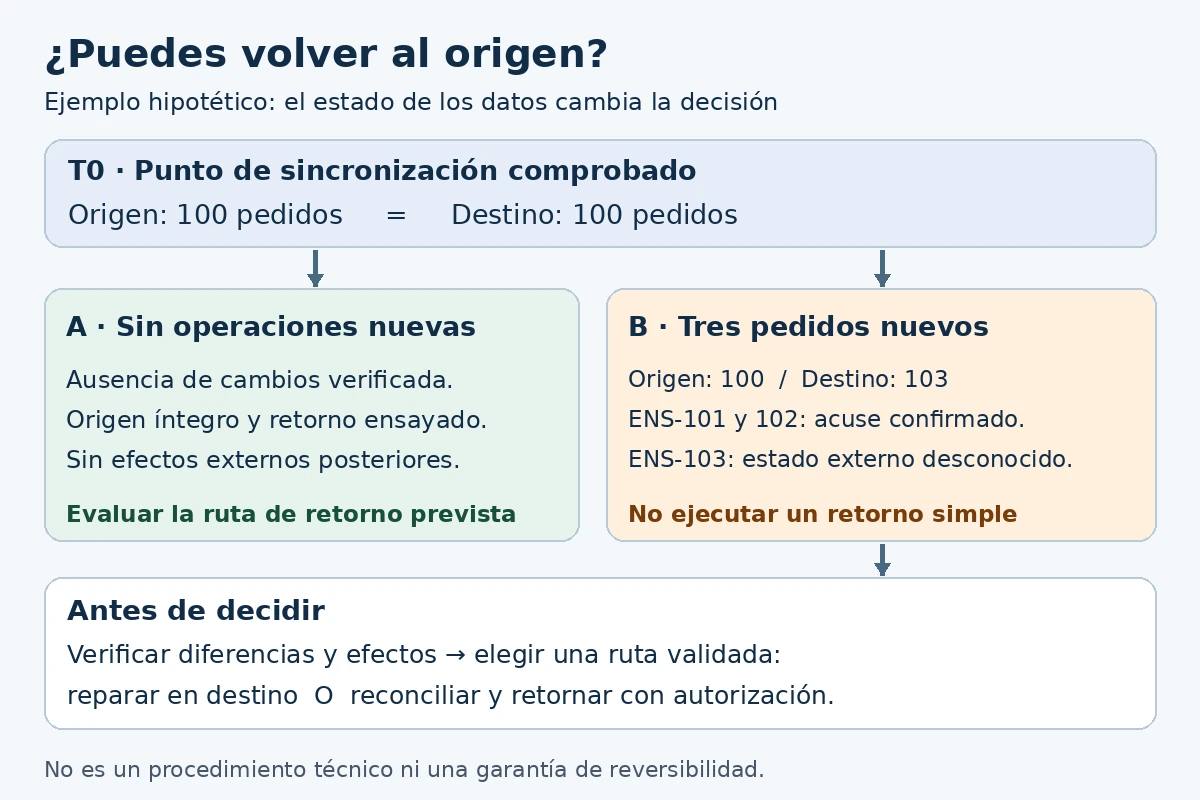
Equivalente textual del diagrama: en T0, origen y destino tienen 100 pedidos comprobados. Si no existen cambios posteriores y el origen sigue validado, se puede evaluar la ruta de retorno ensayada. Si el destino recibe tres pedidos más, hay 103 allí y sólo 100 en origen; además, un acuse externo puede quedar desconocido. Primero se verifican operaciones y efectos; después se decide reparar en destino o reconciliar y retornar. Cambiar el acceso no resuelve esa diferencia.
1. Mapea el proceso completo, no sólo el servidor
Primero delimita el cambio. Mover el mismo ERP a otro alojamiento no es lo mismo que cambiar de producto, de versión o de modelo a SaaS. Una sustitución puede requerir conversión de datos, rediseño de procesos y formación adicional. Esta guía se concentra en decidir un corte de operación; no presupone que todos esos proyectos tengan el mismo procedimiento.
Conserva un inventario de versión del ERP, motor de base de datos, complementos y conectores. Añade archivos compartidos, tareas programadas, dispositivos y servicios externos que intervienen en los procesos críticos. La lista debe explicar qué depende de qué y quién puede validar cada parte.
Una integración puede funcionar fuera del horario del piloto y fallar cuando se ejecuta un cierre. Una impresión puede verse bien en PDF y no salir por el dispositivo que necesita la operación. El mapa de dependencias convierte estas posibilidades en verificaciones concretas, sin afirmar que ocurrirán en todos los proyectos.
- Proceso: qué necesita completar el usuario, desde el inicio hasta la confirmación final.
- Dependencias: aplicación, datos, conectores, archivos, dispositivos y terceros implicados.
- Responsable: quién valida el resultado de negocio y quién atiende la parte técnica.
- Evidencia: qué prueba autorizada demostrará que funciona.
- Consecuencia: si el fallo impide el corte o puede quedar como pendiente aceptado expresamente.
Revisa soporte y derechos de uso para la combinación de versiones y el destino. No conviertas el éxito de una instalación de prueba en una declaración general de compatibilidad. Cuando el fabricante del ERP o del motor exige un procedimiento específico, ése debe formar parte del plan técnico.
2. Acuerda aceptación antes de ejecutar el piloto
Los criterios deben indicar operación, entorno, datos de prueba, carga representativa y resultado esperado. Define también cómo se medirá y quién tendrá autoridad para aceptarlo. Un umbral de CPU, memoria o latencia copiado de otra empresa no sustituye los requisitos de tu proceso.
Compara tiempos de tareas equivalentes y conserva errores y resultados, no sólo promedios. La duración del piloto depende de lo que necesites observar: procesos diarios, cierres, integraciones programadas o situaciones de excepción. Un número fijo de días no garantiza que se haya cubierto un ciclo relevante.
La disponibilidad observada en un piloto tampoco demuestra por sí sola un nivel de servicio futuro. Documenta la ventana y sus limitaciones. Si no se ensayó un proceso importante, clasifícalo como pendiente; no lo presentes como aprobado porque otros procesos se ejecutaron sin errores.
La guía de planificación de migración de Microsoft plantea criterios de retorno, responsables y decisiones de preparación. Su ámbito es Azure: aquí se usa como referencia de planificación, no como una arquitectura obligatoria ni una garantía aplicable a cualquier proveedor.
3. Registra una decisión por dependencia crítica
Una puerta de aceptación es una condición que debe resolverse antes de avanzar. Es útil cuando tiene evidencia, responsable y consecuencia definidos. Evita una lista de casillas en la que «revisado» pueda significar tanto «funciona» como «alguien recibió un correo».
Abrir registro de puerta de aceptación
- Proceso o dependencia que se valida: ___
- Condición exacta para aprobar: ___
- Entorno, versión y datos ficticios del ensayo: ___
- Evidencia y fecha de observación: ___
- Responsable técnico y responsable de negocio: ___
- Resultado: aprobado, pendiente o fallido: ___
- ¿Impide el corte? Motivo acordado: ___
- Acción pendiente, responsable y nueva verificación: ___
- Persona que autoriza continuar o detenerse: ___
- Limitaciones y riesgo aceptado expresamente, si corresponde: ___
Usa una ficha por condición crítica y conserva una decisión consolidada. La plantilla no envía información ni ejecuta pruebas desde esta página. No incluyas datos reales de clientes, credenciales o comprobantes sensibles para ilustrar el expediente.
Ensayo trabajado: por qué tres pruebas aprobadas no autorizan el corte
Escenario hipotético completo, no cliente ni prueba de rendimiento real. Una empresa traslada el mismo ERP a un alojamiento distinto. El proyecto contempla aplicación, base de datos, archivos de exportación y un receptor externo de pedidos. El fabricante ya confirmó para el ejercicio que la combinación propuesta es compatible; esa confirmación no prueba las personalizaciones. Las pruebas usan cuentas y pedidos sintéticos, una réplica autorizada y un receptor de prueba, nunca pedidos, cobros o documentos fiscales de producción.
El proceso crítico es crear un pedido interno, exportarlo con su almacén y comprobar el acuse del receptor. Negocio exige conservar identificador, almacén, artículo y cantidad; una exportación sin almacén impide saber dónde debe atenderse. El responsable funcional valida significado y resultados, el técnico verifica aplicación y transferencia, y el responsable del receptor confirma la recepción. Una persona designada por el negocio autoriza el corte; no se delega esa decisión a quien sólo observa que el servidor responde.
| Puerta | Evidencia ficticia observada | Resultado y dueño |
|---|---|---|
| Acceso y función permitida | El usuario de prueba completa su tarea; otro rol no obtiene una función que no le corresponde. | Aprobado para estos roles. Responsable funcional y técnico. |
| Pedido guardado correctamente | ENS-041 conserva almacén B02, artículo PRUEBA-A y cantidad 7 al consultarse de nuevo. | Aprobado para este caso. Responsable funcional. |
| Exportación y recepción completas | El archivo contiene ENS-041 y cantidad 7, pero omite B02; el receptor lo rechaza. | Fallido y bloqueante. Integración y responsable del receptor. |
| Reporte de control | El ERP muestra el pedido y sus campos esperados; el reporte local no demuestra recepción externa. | Aprobado sólo en el ERP. Responsable funcional. |
Decisión registrada: NO-GO. El proceso de negocio no termina en guardar el pedido: necesita recepción externa correcta. La prueba de acceso no compensa el rechazo de la integración. No se cambia el requisito después del fallo para que la hoja quede verde ni se compra más CPU sin una causa que lo justifique.
Corrección y reensayo, todavía ficticios: el equipo autorizado identifica un mapeo de exportación que omitía el almacén en la configuración del ensayo. Lo corrige en ese entorno y repite casos de B01 y B02. El receptor de prueba acepta ambos con identificador, almacén, artículo y cantidad correctos. También se vuelven a comprobar consulta y reporte porque el cambio afectó la ruta del pedido. Se guarda la revisión del mapeo y la evidencia asociada, no sólo una captura de «proceso terminado».
Qué decisión cambia: la puerta de exportación puede pasar a aprobada para los casos reensayados. El GO del proyecto todavía exige que estén resueltas las demás puertas, la validación de carga acordada, el punto de sincronización, los responsables y la contingencia. No se convierte un ensayo funcional con dos pedidos en una prueba de capacidad para todo el negocio.
Qué la volvería a cambiar: si después se modifica el conector, el formato o el receptor, hay que revisar qué evidencia quedó invalidada. Si el receptor sólo confirmó que llegó un archivo, pero no que aceptó sus campos, la puerta sigue pendiente. Si ese proceso no fuera necesario para el corte, sólo una decisión de negocio documentada sobre el alcance y su alternativa permitiría reclasificarlo; no basta llamarlo «detalle menor».
El énfasis en validación del usuario antes de cambiar los destinos coincide con la guía de corte de cargas de Azure. Su alcance es una reubicación en Azure: aquí se toma el principio de aceptación y verificación, no sus pasos de red ni un plazo universal de cierre.
4. Distingue recuperación de frecuencia de copias
RPO expresa la pérdida máxima de datos aceptable medida en tiempo; RTO expresa el tiempo máximo de indisponibilidad aceptable. Son objetivos que el negocio debe definir y la solución debe demostrar que puede atender en el escenario evaluado. La referencia de objetivos de confiabilidad de Microsoft distingue ambos conceptos.
Programar copias cada cierto intervalo no demuestra por sí solo que se cumpla el RPO: importan su finalización, consistencia, disponibilidad y el punto al que realmente se puede recuperar. Del mismo modo, el tiempo de copiar archivos no equivale al tiempo de volver a operar y verificar el ERP.
Para el corte, acuerda qué datos se detienen o sincronizan y cómo se comprobará el punto de partida del destino. Para una contingencia, documenta qué recuperación se ha ensayado y cuáles son sus límites. Si necesitas preparar esa evidencia, consulta la guía de respaldos empresariales; no hace falta repetir aquí toda la política de copias.
Calcula cuándo debes decidir, no sólo cuánto tarda copiar
Ejemplo hipotético de planificación, no tiempos medidos: se acuerda una ventana total de 90 minutos. Para el escenario de retorno sin datos nuevos se presupuestan 25 minutos de retorno, 15 de validación del proceso y 10 de margen. El último momento de decisión previsto sería 90 − 25 − 15 − 10 = 40 minutos desde el inicio. Esperar al minuto 55 deja 35 minutos, menos que los 50 presupuestados.
La relación reutilizable es: momento límite = ventana total − retorno − validación − margen, con todas las cantidades en la misma unidad. Si falta una duración, el resultado es desconocido, no cero; si el resultado es negativo, el plan no cabe en esa ventana. Es un presupuesto que debe contrastarse con ensayos y variabilidad, no prueba de cumplimiento del RTO ni garantía. Si aparecen datos nuevos, hay que reevaluar los tiempos y la ruta: el presupuesto anterior puede dejar de aplicar.
La planificación previa al corte de AWS incluye duración de tareas, responsables, contingencia y tiempo de retorno. Nuestro ejemplo sólo hace visible una decisión de agenda que esos componentes obligan a tomar.
5. Define qué significa volver atrás
El plan de retorno debe distinguir al menos dos momentos: antes de que el destino reciba trabajo nuevo y después de que ya existan cambios reales allí. En el segundo caso, volver a encender el origen puede dejar fuera operaciones recientes o producir divergencias. Un respaldo previo no resuelve automáticamente esa reconciliación.
Identifica el punto a partir del cual una reversión deja de ser simple y requiere un tratamiento específico de datos. No existe un «botón de rollback» universal para una aplicación, sus integraciones y los efectos que ya produjo fuera del servidor. El equipo debe acordar cuándo detener el trabajo, qué estado conservar y quién decidirá entre retorno, reparación o continuidad restringida.
Abrir preguntas del plan de retorno
- ¿Qué evento activa la evaluación de retorno y quién lo comunica?
- ¿Quién puede ordenar detener la operación y quién autoriza la decisión final?
- ¿Cuál es el último estado comprobado del origen y del destino?
- ¿Se han generado datos nuevos o efectos en servicios externos?
- ¿Cómo se identificarán y reconciliarán esas operaciones sin duplicarlas ni omitirlas?
- ¿Qué pasos fueron ensayados en un entorno autorizado y cuáles siguen sin comprobarse?
- ¿Qué tiempo queda para decidir dentro de la ventana disponible?
- ¿Cómo se comunicará la situación a los usuarios y al soporte?
El mismo fallo tiene dos decisiones distintas según los datos nuevos
Continuación hipotética del ensayo, no instrucciones para producción. El equipo prueba dos escenas separadas. En ambas existe un punto de sincronización identificado, T0, con 100 pedidos sintéticos comprobados en origen y destino. La cifra por sí sola no acredita igualdad: se contrastan los identificadores y campos relevantes del conjunto de prueba. El plan ya define quién puede detener la operación, quién decide y quién ejecuta la ruta autorizada.
Escena A: el destino no recibió trabajo nuevo
La validación inicial falla antes de abrir el destino a usuarios o integraciones. Los responsables verifican que no hubo nuevas escrituras ni efectos externos desde T0, que el origen sigue íntegro y que su reapertura fue ensayada. En ese escenario, el retorno previsto puede evaluarse sin tener que incorporar pedidos posteriores al corte. La decisión del ejercicio es no abrir el destino y usar el procedimiento de retorno aprobado, una vez comprobadas sus condiciones.
Si no puedes confirmar la ausencia de cambios, no clasifiques la escena como «sin datos nuevos». Un proceso programado o una integración puede escribir aunque nadie haya iniciado sesión. Y aunque no haya datos nuevos, todavía hay que validar que los usuarios vuelvan al sistema correcto y que el proceso completo funcione.
Escena B: el destino ya recibió tres pedidos
Después de habilitar el destino en el escenario de prueba, aparecen ENS-101, ENS-102 y ENS-103. Los dos primeros tienen acuse externo confirmado; el tercero quedó sin respuesta concluyente cuando falló la integración. El origen permanece en los 100 pedidos de T0. En este momento, «volver al servidor anterior» y «conservar toda la operación» son tareas distintas.
| Operación | Origen / destino | Efecto externo confirmado |
|---|---|---|
| ENS-101 | No está en origen; sí en destino. | Acuse recibido. No repetir a ciegas. |
| ENS-102 | No está en origen; sí en destino. | Acuse recibido. No repetir a ciegas. |
| ENS-103 | No está en origen; sí en destino. | Desconocido. Falta verificar con el receptor. |
Decisión del ejercicio: no ejecutar el retorno simple. El responsable activa la contención prevista para el proceso afectado y conserva el estado necesario para analizarlo, conforme al plan autorizado. El equipo debe determinar el estado de ENS-103 y decidir entre reparar en destino o aplicar una reconciliación y retorno ensayados. Reenviar los tres pedidos sin verificar puede duplicar efectos de ENS-101 y ENS-102; restaurar sólo T0 dejaría los tres fuera de la operación del origen.
Supón que el receptor confirma que ENS-103 también fue aceptado y que sólo se perdió el acuse. Ahora el registro tiene tres efectos externos confirmados, pero el origen sigue sin los tres pedidos. El dato nuevo elimina una incertidumbre; no autoriza borrar ni volver a enviar. En la rama resuelta de este ejercicio ficticio, el fabricante cuenta con un procedimiento validado para recuperar esos estados de confirmación. El equipo lo ensaya y el responsable funcional verifica los tres identificadores, sus campos y sus acuses, sin generar nuevos pedidos en el receptor. Por esa evidencia se elige reparar en destino y repetir la validación del proceso. Si esa ruta no existe, falla la comprobación o queda un efecto desconocido, la decisión cambia: la escena permanece detenida para la reconciliación autorizada. No se inventa una receta de base de datos para conseguir un final feliz.
La documentación de AWS sobre corte y rollback distingue expresamente el retorno sin cambios del retorno con nuevas transacciones. Las técnicas que enumera dependen de la aplicación y la arquitectura; no son autorización para configurar doble escritura ni replicación en cualquier ERP.
Antes del corte real, define para tu aplicación cómo reconocer y resolver estas diferencias, incluyendo estados desconocidos. La tabla sirve para discutir y comprobar el plan; no mueve datos, no identifica automáticamente todas las operaciones y no sustituye el procedimiento aprobado por el fabricante.
La guía de ejecución de migraciones a Azure destaca coordinación, revisión previa y control de cambios durante la transición. No se deben trasladar sus pasos técnicos automáticamente a un ERP diferente. El procedimiento ejecutable necesita ajustarse al motor, la aplicación, el proveedor y las autorizaciones del proyecto.
6. Autoriza el corte con evidencia vigente
Antes de la ventana, revisa que las personas necesarias estén disponibles, que las puertas críticas sigan aprobadas y que no haya cambios posteriores que invaliden el ensayo. Si una versión, integración o condición cambió, decide qué debe volver a comprobarse. Una aprobación antigua no cubre automáticamente un escenario nuevo.
Una regla de decisión que puedes aplicar a tu acta
- ¿Hay una condición crítica fallida o sin evidencia? NO-GO hasta resolverla o cambiar formalmente el alcance con una alternativa aceptada. «No sabemos» no equivale a aprobado.
- ¿Las pruebas corresponden a la versión y configuración que se va a mover? Si no, identifica y repite las afectadas antes de usar sus resultados.
- ¿Está claro el punto de sincronización y qué hacer con datos nuevos? Si no, falta una parte esencial de la contingencia.
- ¿Están disponibles quienes deciden, validan y ejecutan? Una ventana sin ellos no es una ventana preparada.
- ¿Todo lo anterior está resuelto? La persona designada puede valorar el GO documentado, con límites y riesgos residuales explícitos. La lista no lo autoriza por sí sola.
Copiar un acta breve de decisión y contingencia
Proyecto y revisión del plan: ___
Alcance exacto del corte: ___
Puertas críticas y referencias de evidencia: ___
Cambios desde el último ensayo y verificaciones repetidas: ___
Punto de sincronización y cómo se comprobará: ___
Responsable de negocio / técnico / receptor externo: ___
Estado de operaciones nuevas: ausencia verificada / existen / desconocido, con evidencia: ___
Ruta prevista ante fallo y condiciones para usarla: ___
Evento o momento que obliga a reconsiderar la decisión: ___
Decisión GO / NO-GO, razón, autor y fecha: ___
Validación posterior y criterio de cierre: ___
Completa las referencias con identificadores internos, no contraseñas ni datos de clientes. Copia también el registro de diferencias del ejemplo y cambia sus filas por las que correspondan a un ensayo autorizado. La página no guarda ni envía el acta.
El acta de GO/NO-GO debe identificar la versión del plan, los pendientes, la decisión y quién la toma. La aceptación de un riesgo residual debe ser explícita y corresponder a alguien con autoridad. No conviertas el silencio de un área en aprobación ni permitas que una fecha comercial oculte un impedimento técnico conocido.
Tras el cambio autorizado, valida el proceso de negocio completo y la continuidad de las integraciones. Abrir sesión es una comprobación inicial, no el cierre del proyecto. Mantén un periodo de observación definido por los procesos que faltan por recorrer y un canal de escalamiento acordado, sin prometer un horario de atención que no esté contratado.
El cierre debe explicar qué pasó al origen, quién opera el destino y qué pendientes siguen abiertos. Retirar datos o infraestructura requiere el procedimiento y los permisos correspondientes; no es una acción implícita por haber aprobado el piloto.
7. Compra coordinación y criterio, no una fecha prometida
Un acompañamiento experimentado puede justificar un coste mayor si aporta pruebas bien diseñadas, coordinación entre áreas y una decisión de corte respaldada por evidencia. Ese valor se compara con el tiempo interno y las interrupciones que se quieren evitar, sin convertirlo en una garantía de migración sin fallos.
Quizá no necesitas contratar una migración ahora: si el entorno actual cumple los requisitos y no existe una razón de negocio demostrada, puedes mantenerlo y resolver un problema específico. Si tu equipo y el fabricante ya cubren pruebas, coordinación y contingencia, una revisión puntual puede bastar. También cabe comparar otro proveedor o una modalidad distinta de la aplicación, pero sin tratar SaaS como si fuera sólo mover la misma VM.
Puedes consultar con Cobalt Blue Web u otro especialista qué parte del plan puede asumir, qué necesita del fabricante del ERP y qué entregables ofrecerá. Pide responsables, horarios, exclusiones y criterios de aceptación por escrito. El proveedor no debe decidir por sí solo cuánto riesgo de negocio puede aceptar tu empresa. Para una primera conversación comparte versión del ERP, dependencias, proceso crítico y evidencia que falta; no envíes bases de datos, credenciales ni documentos de clientes por un formulario general.
IA útil: revisar contradicciones antes de la reunión de corte
La IA puede ayudar a contrastar un mapa de dependencias y un acta depurados, pero no observa por sí sola el estado del ERP ni acredita una migración. En el ejemplo, una revisión útil detectaría que el acta dice «listo para corte» mientras la exportación está fallida, o que el retorno propuesto no explica los tres pedidos posteriores a T0. La salida esperada es una lista de preguntas y referencias, no un GO automático.
Con documentos sintéticos, puedes pedir: «Para cada puerta marcada aprobada, identifica su evidencia. Separa contradicciones de datos que faltan. Si hay operaciones posteriores al punto de sincronización, enumera qué debe verificarse antes de considerar el retorno. No supongas que una respuesta ausente significa que el receptor rechazó el pedido». Contrasta manualmente cada hallazgo con el acta y el responsable correspondiente.
No transmitas bases, credenciales, datos personales ni documentos confidenciales por canales no aprobados. Un modelo puede omitir una dependencia o inventar una certeza; la revisión documental ayuda a preparar la conversación, no reemplaza pruebas ni responsabilidad humana. No se han medido ahorros ni precisión de una herramienta de IA en los escenarios ficticios de esta guía.
Un servidor para ERP define si tu cierre de mes fluye o colapsa. Por eso, conviene dimensionarlo con datos, validar la arquitectura y asegurar que el soporte responda. Además, los cierres concentran cargas atípicas: reportes largos, timbrado simultáneo, consolidados y comprobaciones de inventario. En consecuencia, si la infraestructura no entrega CPU sostenida, RAM disponible e IOPS bajas, la operación se enlentece y los usuarios sienten que “todo se cayó”.
Checklist rápido para el cierre de mes
Primero, establece un mínimo técnico verificable:
-
CPU sostenida < 70% durante picos de cierre.
-
Memoria libre > 25% al ejecutar reportes.
-
Latencia de disco < 5 ms y IOPS garantizadas.
-
Ancho de banda estable y rutas RDP/HTTPS sin pérdida.
-
RPO/RTO documentados y probados.
-
Backups diarios con retención y restauración validada.
-
MFA en accesos administrativos y segmentación de redes.
Además, si tu ventana de cierre es corta, asegúrate de contar con un runbook de contingencia para restaurar rápido una versión consistente del ERP.
si necesitas dimensionamiento inmediato y opciones administradas, revisa estas soluciones VPS para empresas en México y alinea recursos antes del pico.
Capacidad base del servidor para ERP: CPU, RAM e IOPS

Aunque cada ERP tiene particularidades, para 15–40 usuarios concurrentes conviene iniciar con 8 vCPU, 32 GB RAM y NVMe dedicado con IOPS garantizadas. Asimismo, separa volúmenes: SO, datos, respaldos y, si aplica, logs. Así reduces contención y mejoras tiempos de respuesta en reportes.
Disco NVMe y colas de E/S
Consolidaciones y consultas de inventario son operaciones de lectura/escritura intensiva. Por lo tanto, la mejora más rentable suele estar en el almacenamiento. Activa NVMe, eleva IOPS y vigila la longitud de cola; si crece, la experiencia de usuario caerá aun con mucha CPU libre.
Alta disponibilidad y objetivos RPO/RTO

No siempre necesitas clúster activo/activo; sin embargo, para cierres con facturación continua, la alta disponibilidad entre zonas evita paros prolongados. Define RPO (pérdida aceptable de datos) y RTO (tiempo para volver a operar). Además, agenda pruebas de restauración trimestrales: solo así sabrás que el plan funciona. Si ocurre un incidente, aplica el procedimiento de recuperación de ERP en la nube urgente: levántalo en horas.
Servidor para ERP con escritorios Windows
Muchos ERPs funcionan mejor con escritorios remotos; por eso, valida códecs RDP, impresoras y escáneres. Asimismo, ubica la instancia cerca de tus usuarios para reducir latencia y evita “saltos” innecesarios por VPN mal configuradas.
Si requieres un entorno listo para aplicaciones Windows de escritorio ERP, conoce estas opciones de servidores en la nube y estandariza tu acceso remoto.
Monitoreo y pruebas de estrés
Mientras te acercas al cierre, ejecuta pruebas de carga representativas: genera reportes largos, multiplica sesiones, simula timbrado. Luego, observa:
-
CPU por vCPU y ready time.
-
RAM comprometida vs. en caché.
-
IOPS y latencia por volumen.
-
RDP RTT y pérdidas en la red.
-
Errores de aplicación (tiempos fuera, bloqueos).
Con métricas a la mano, podrás incrementar vCPU o RAM de forma preventiva y, en consecuencia, evitarás improvisaciones a última hora.
Seguridad operativa para el cierre
Durante cierres, crecen los accesos y las prisas; por eso, define políticas estrictas:
-
MFA obligatorio para administradores.
-
Listas de control por IP y bloqueo geográfico cuando aplique.
-
WAF en servicios web y TLS actualizado.
-
Segmentación por VLAN/SG para bases y escritorios.
-
Principio de mínimo privilegio durante la ventana de cierre.
Además, registra cambios en un change log y conserva evidencia de quién accedió, cuándo y desde dónde.
Plan de respaldos y cutover probado
No basta con “tener backups”; necesitas restauraciones validadas y, si migras a infraestructura nueva, un plan de cutover limpio. Define:
-
RPO 1 h (o menor) con retención 14–30 días.
-
Backups consistentes a nivel de aplicación.
-
Copias fuera de la zona para contingencias mayores.
-
Scripts de smoke test post-restauración (login, reporte crítico, impresión).
Asimismo, guarda copias en infraestructura independiente. Si tu ERP convive con bases auxiliares (por ejemplo, Access), revisa estas buenas prácticas para Access en la nube para evitar archivos bloqueados en hora pico.
Arquitectura recomendada por tamaño de operación
| Escenario | CPU y RAM | Almacenamiento | Red/Acceso | Observaciones |
|---|---|---|---|---|
| Pyme (≤20 usuarios) | 6–8 vCPU, 24–32 GB RAM | NVMe 500 GB (datos) + 200 GB (backups) | RDP por IP fija, MFA | Escalar IOPS si los reportes tardan > 60 s |
| Mediana (21–50) | 8–12 vCPU, 32–48 GB RAM | NVMe 1 TB (datos) + 500 GB (backups) | Balanceo RDP, WAF | Separar base y escritorios en VMs distintas |
| Multi-sucursal (51–100) | 12–16 vCPU, 64 GB RAM | NVMe 2 TB + réplica en otra zona | SD-WAN/QoS y HA | Replicación y cutover automatizado |
Cuándo cambiar de VPS a dedicado
Si la cola de E/S sigue alta tras subir IOPS, si las sesiones RDP saturan o si la contención de vCPU es crónica, entonces evalúa migrar. Compara en esta guía de servidor dedicado vs. VPS con escritorio remoto para decidir según picos, licencias y presupuesto. Además, recuerda que el dedicado administrado incluye más control sobre NUMA, afinidad y redes, lo que, en algunos ERPs, marca una diferencia tangible.
Gobierno de cambios y ventanas de mantenimiento
Para no interrumpir el cierre, calendariza parches y actualizaciones fuera de horario productivo. Documenta:
-
Paquetes aplicados y versiones.
-
Respaldos previos y punto de reversión.
-
Resultados de smoke tests.
-
Incidencias y mitigaciones.
Asimismo, comunica con antelación a las áreas contables y financieras qué días y horas habrá ventanas, y mantén un canal de soporte en vivo.
Estándares de servicio y soporte: Servidor para ERP
Un buen proveedor no solo “vende máquinas”; aporta SLA con primera respuesta y tiempos de resolución, acompañamiento en picos y runbooks de incidentes. Pide evidencias: capturas de monitorización, casos resueltos y referencias. Además, solicita acompañamiento durante el cierre y una línea directa con el NOC.
Si necesitas un diagnóstico express o apoyo de guardia para tu cierre, contacta a un ingeniero ahora y agenda una revisión de arquitectura.
Servidor para ERP: Métricas que debes vigilar el último día
-
Tiempo de apertura de reportes clave (< 30 s ideal, < 60 s aceptable).
-
Errores de aplicación por bloqueo o timeout.
-
RDP RTT promedio y picos.
-
Latencia de disco y longitud de cola.
-
Uso de CPU por proceso del ERP y del motor de base de datos.
Entonces, con estas métricas puedes decidir si escalar vertical u horizontalmente antes de que el personal se queje.
Integración con compras y ventas: picos previsibles: Servidor para ERP
Aun cuando contabilidad sufra la mayor carga, compras y ventas también generan picos. Por consiguiente, coordina horarios, secuencia reportes y limita procesos pesados simultáneos. Además, reserva “ventanas silenciosas” para la generación de pólizas y cálculos finales.
Servidor para ERP
Elegir el servidor para ERP adecuado no es un lujo; es un seguro contra cuellos de botella y paros en el momento más crítico del mes. Con capacidad correcta, NVMe garantizado, RPO/RTO probados, MFA y monitoreo, tu cierre será predecible. Finalmente, mantén un plan de escalado y un proveedor que acompañe de verdad.
Si quieres validar tu dimensionamiento y llegar al próximo cierre sin sobresaltos, agenda una llamada con Cobalt Blue Web y obtén un plan a medida.