Proveedor de Email para ERP Empresarial: si el correo se cae, se atrasa o llega a spam, tu ERP puede “seguir prendido”, aunque tu operación pierde confirmaciones, evidencia y seguimiento. Además, cuando el envío de facturas y avisos se vuelve intermitente, aumentan reclamaciones, se duplican reintentos y, por lo tanto, sube el costo administrativo.
Proveedor de Email para ERP Empresarial: qué problema resuelve en operación
Primero, un ERP no envía “correos sueltos”; en cambio, dispara eventos: facturación, estados de cuenta, avisos de inventario, tickets y notificaciones a clientes. Además, esos eventos suelen concentrarse en picos (cierres, cobranza, campañas o cortes internos). Por eso, necesitas un servicio que sostenga volumen, adjuntos y reputación de forma estable, y no solo “un SMTP que responde”.
Asimismo, si el email es parte del flujo de cobro, la palabra clave es trazabilidad: saber qué se envió, qué se entregó, qué rebotó y qué quedó en cola. De hecho, esa evidencia reduce discusiones internas y acelera decisiones.
Proveedor de Email para ERP Empresarial: separa correo humano y correo transaccional
Aunque suene práctico usar el mismo buzón para todo, en realidad mezclar correo humano (ventas, soporte, cobranza) con correo transaccional del ERP suele contaminar reputación. Además, cuando el ERP manda lotes grandes, el patrón se parece a “envío automatizado”, y entonces algunos filtros endurecen reglas para tu dominio completo.
Por lo tanto, conviene separar identidades y rutas: por ejemplo, cuentas humanas con políticas de acceso y, en paralelo, un subdominio o identidad exclusiva para el ERP. Así, si un lote de facturas genera rebotes, no arrastra a “ventas@” a spam. En ese mismo sentido, si ya operas Odoo o Aspel, puedes comparar enfoques con tu implementación anterior en Servicio de Email Empresarial para Sistemas Odoo y, además, ver criterios específicos en Proveedor de Email Empresarial para Aspel.
Proveedor de Email para ERP Empresarial: autenticación SPF/DKIM/DMARC sin suposiciones
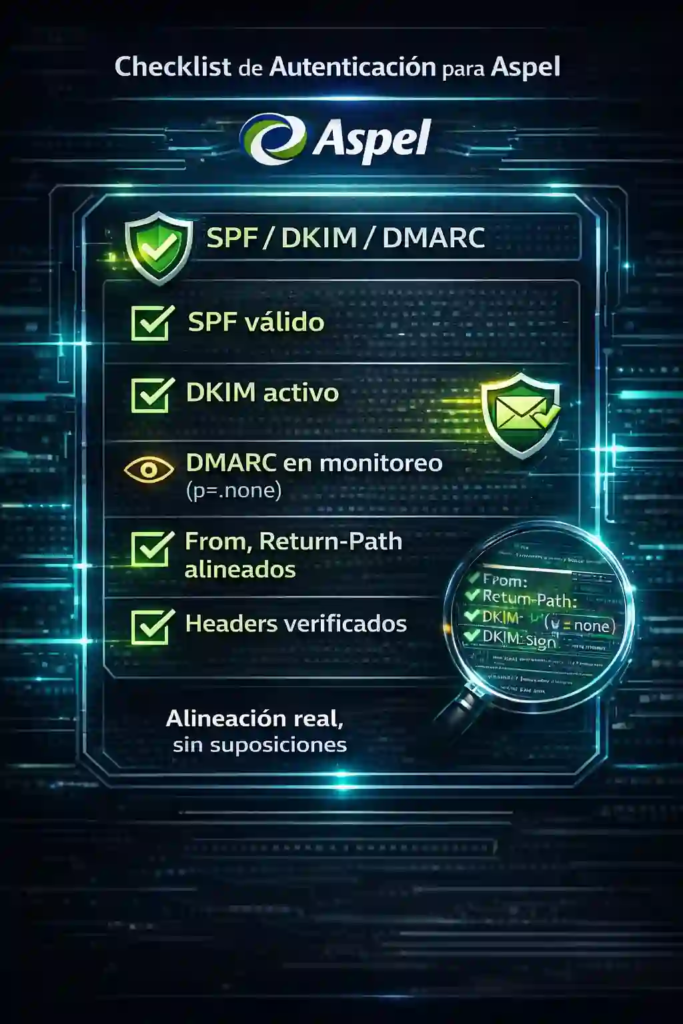
Alineación real, sin suposiciones
Aquí se decide gran parte de la entregabilidad. En otras palabras, no basta con “configurar SPF”; además, necesitas alineación real en headers y control de cambios. Por lo tanto, exige que el proveedor entregue pruebas y verificación, no solo instrucciones genéricas.
SPF: autoriza quién envía por tu dominio. Sin embargo, si agregas includes sin control, puedes exceder límites de consulta y, entonces, fallar validación. DKIM: firma el correo; además, debe ser estable, rotar llaves cuando corresponde y mantener consistencia al migrar infraestructura. DMARC: protege tu identidad y reduce spoofing; sin embargo, debe implementarse por etapas (monitoreo → cuarentena → rechazo) para no bloquear tráfico legítimo.
A la vez, lo que más se rompe en migraciones es la alineación entre From y Return-Path; por eso, hay que verificar headers reales con correos enviados a diferentes destinos.
Proveedor de Email para ERP Empresarial: reputación, rebotes y retrasos medibles
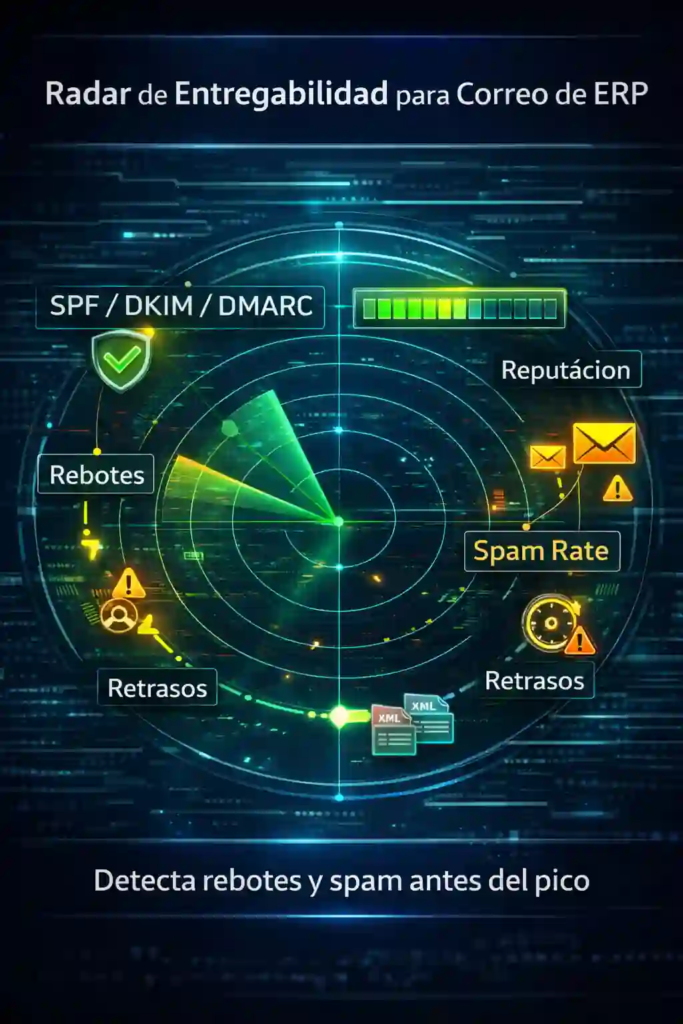
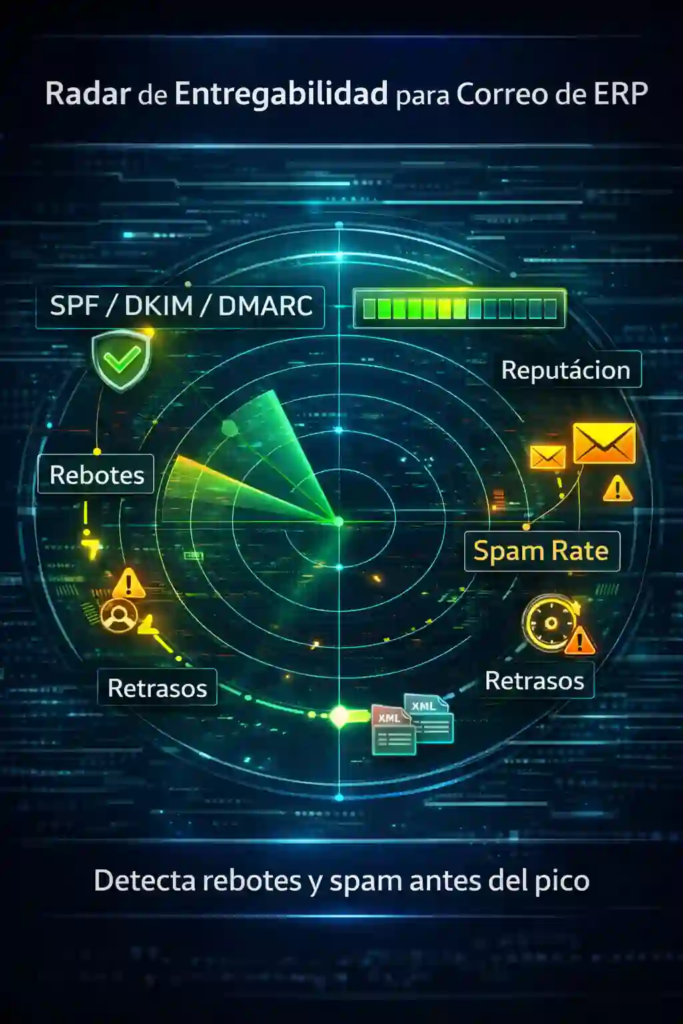
Detecta rebotes y spam antes del pico
Aunque tengas autenticación perfecta, la reputación puede bajar si tu lista está sucia o si envías en ráfagas agresivas. Además, los rebotes no son iguales: no es lo mismo “buzón lleno” que “dominio inexistente” o “bloqueo por política”. Por consiguiente, un proveedor útil clasifica rebotes, identifica tendencias y propone acciones.
Asimismo, el retraso (delay) es un síntoma silencioso: el correo “sale”, aunque llega tarde, y entonces el cliente paga tarde o reclama. Por eso, el servicio debe medir tiempos de entrega, cola y reintentos. En particular, si tu ERP manda adjuntos pesados (XML/PDF), conviene monitorear cuánto aumenta el delay por tamaño y por destino (Gmail, Outlook, dominios corporativos).
Proveedor de Email para ERP Empresarial: colas, rate limit y reintentos sin duplicados
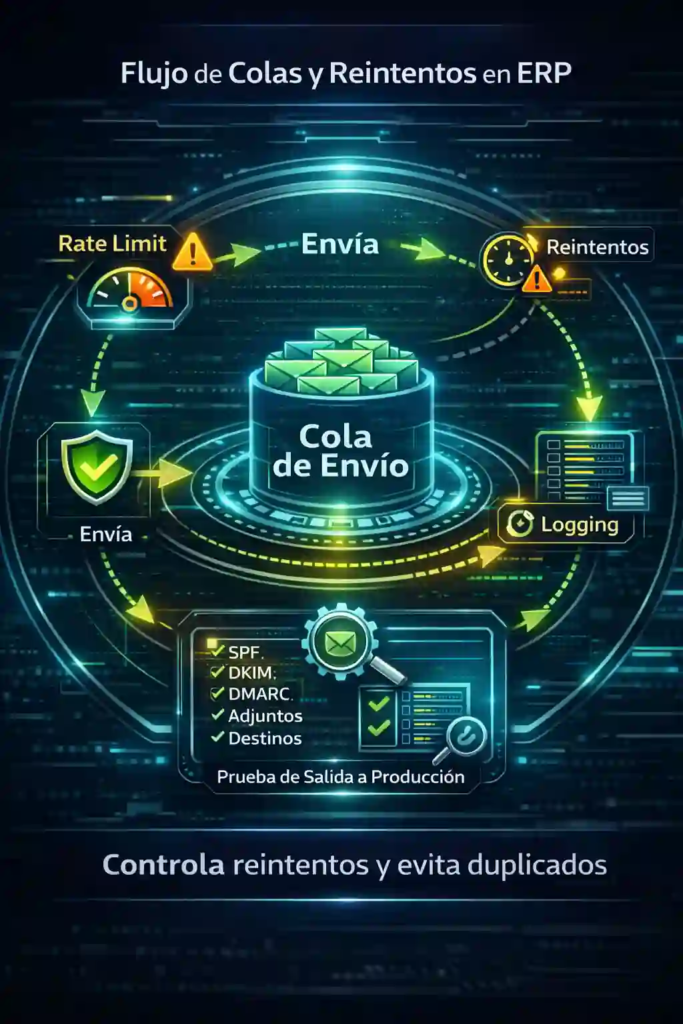
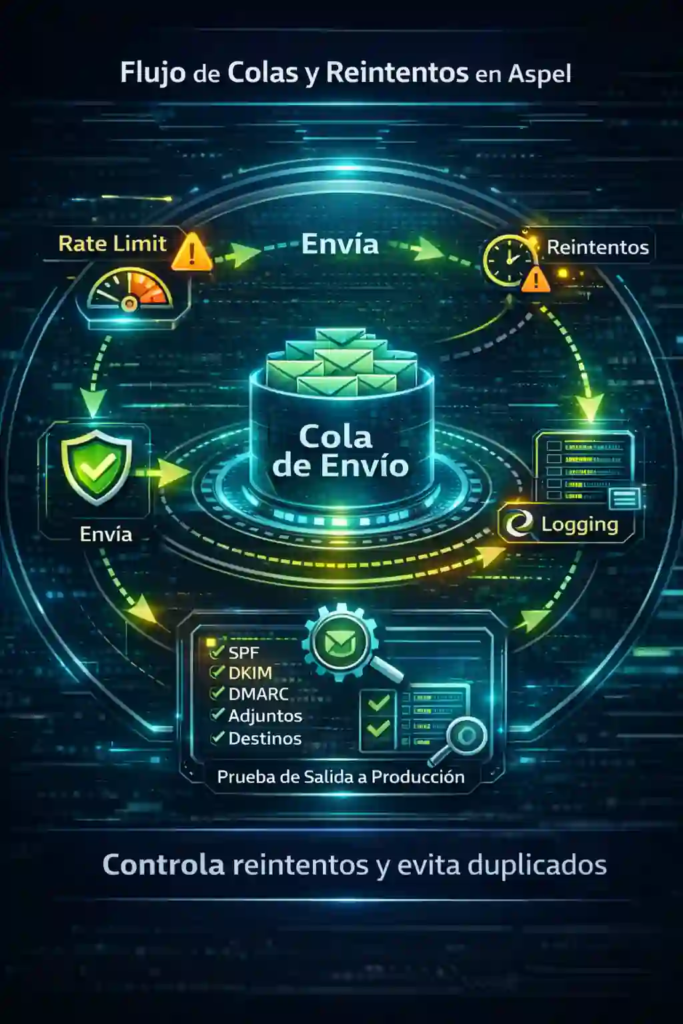
Controla reintentos y evita duplicados
En operación real, siempre habrá destinatarios que fallen temporalmente. Por lo tanto, necesitas colas y reintentos controlados, con reglas claras: cuántos intentos, cada cuánto, y cuándo “marcar como fallido” para que el área administrativa actúe.
Además, los duplicados se vuelven un problema cuando el sistema reintenta “a ciegas” o cuando alguien reenvía manualmente sin revisar bitácoras. Por esa razón, el proveedor debe ofrecer logging por mensaje (Message-ID), correlación de eventos y evidencia de entrega. Así, en lugar de reenviar por intuición, decides por estado: entregado, rebotado, diferido, bloqueado.
Proveedor de Email para ERP Empresarial: adjuntos de facturación y políticas anti-spam
Los adjuntos hacen que el correo sea más “pesado” y más revisado por filtros. Además, si envías el mismo asunto y el mismo cuerpo cientos de veces con PDF/XML, puedes parecer automatización agresiva, incluso si es legítima.
Por lo tanto, conviene controlar:
tamaño máximo por mensaje y compresión razonable,
límites por minuto/hora (rate limit),
plantillas que mantengan claridad, aunque eviten clones exactos,
pruebas de salida a producción con destinos reales.
En consecuencia, reduces bloqueos y evitas que el equipo de cobranza pierda tiempo reconstruyendo evidencia.
Proveedor de Email para ERP Empresarial: soporte con SLA y escalamiento operativo
Si el correo es parte del cobro, el soporte debe ser medible. Además, “responder rápido” no sirve si no hay diagnóstico: necesitas bitácora, estado de incidentes y escalamiento real. Por lo tanto, pide tiempos por severidad, canales formales y un procedimiento para picos.
Asimismo, un buen soporte deja documentación: qué se cambió en DNS, qué se ajustó en rate limit, qué rebotes se depuraron y qué pruebas se ejecutaron. De esta forma, tu operación no depende de una sola persona.
Si quieres aterrizar un alcance con entregables (autenticación, pruebas, monitoreo y documentación), puedes iniciar con una evaluación guiada al contactar con la agencia Cobalt Blue Web y definir una ruta de implementación sin improvisación.
Proveedor de Email para ERP Empresarial: infraestructura del ERP y por qué influye en el correo
Aunque el proveedor de email sea sólido, si tu servidor del ERP está lento, los procesos se atrasan, las colas crecen y los reintentos se disparan. Además, cuando el ERP “se queda pensando”, se rompen ventanas de envío y cambian patrones, lo cual puede afectar reputación.
Por eso, si ya ves síntomas de saturación, conviene estabilizar primero. En particular, esta guía de evitar caídas y lentitud en servidores cloud para sistemas te ayuda a identificar cuellos de botella (CPU, I/O, red, backups sin restore probado) que terminan afectando envío de facturas y notificaciones.
Ahora bien, si tu ERP corre en Windows o requiere compatibilidad específica, vale la pena evaluar una base más controlable, como servidores VPS Windows para sistemas administrativos, para estandarizar colas, logging y monitoreo con mayor margen operativo.
Proveedor de Email para ERP Empresarial: criterios para comparar proveedores sin caer en marketing
Cuando comparas, evita quedarte en “cuántas cuentas incluye”. Mejor, valida evidencia y operación:
autenticación alineada (SPF/DKIM/DMARC) con verificación en headers,
reputación y métricas (rebotes, quejas, spam rate, delays),
colas y reintentos con control y bitácora por mensaje,
soporte con SLA y escalamiento,
pruebas de salida a producción (incluyendo adjuntos y destinos críticos).
Además, si también estás revisando infraestructura general, la guía de proveedores de servidores cloud en México para empresas te ayuda a comparar soporte, continuidad y criterios que, aunque parezcan “infra”, se reflejan directo en operación de correo del ERP.
Si tu prioridad es escalar sin caos (picos de facturación, campañas y cierres), entonces un enfoque práctico es operar sobre servidores virtuales cloud VPS para absorber demanda, separar servicios y mantener telemetría estable.
Seguimiento a tiempo, sin pérdidas
Proveedor de Email para ERP Empresarial: checklist de salida a producción
Antes de “liberar” el envío, conviene ejecutar pruebas que simulen tu operación real, no una demo:
envío con adjuntos a Gmail, Outlook y dominio corporativo,
verificación de logging (Message-ID, estados, tiempos de entrega),
monitoreo inicial con umbrales (rebote alto, delay anormal, bloqueo).
Además, documenta quién autoriza cambios en DNS y quién ejecuta ajustes; así, evitas “arreglos rápidos” que rompen alineación.
FAQ´s: sobre correo para ERP
1) ¿Qué debe tener un correo para ERP para que no caiga en spam? Debe tener autenticación alineada (SPF, DKIM y DMARC), control de reputación y ritmo de envío. Además, conviene monitorear rebotes y retrasos desde el primer día.
2) ¿Por qué el correo del ERP se entrega “tarde” aunque no rebote? Porque puede quedar en cola (por rate limit, saturación del servidor o políticas del destinatario). Por lo tanto, medir delays y cola es tan importante como medir rebotes.
3) ¿Conviene usar el mismo dominio para correo humano y notificaciones del sistema? A menudo no. En cambio, separar identidad o subdominio protege la reputación del correo humano cuando el ERP envía lotes grandes.
4) ¿Qué es la alineación From/Return-Path y por qué importa? Es la coherencia entre el dominio visible y el dominio técnico del envío. Si no alinean, los filtros desconfían, incluso con SPF/DKIM presentes.
5) ¿Cómo evito duplicados cuando hay reintentos? Necesitas colas y reintentos controlados, además de logging por mensaje. Así, no reenvías manualmente sin revisar estado real.
6) ¿Los adjuntos PDF/XML aumentan el riesgo de bloqueo? Sí, sobre todo si son pesados o repetitivos. Por eso, conviene aplicar límites, compresión razonable y pruebas por destino.
7) ¿Qué métricas mínimas debo pedirle al proveedor? Rebotes clasificados, quejas/spam rate, delays, volumen por hora y estados de cola. Además, pide evidencia en bitácoras, no solo “panel bonito”.
8) ¿Cómo sé si mi problema es el proveedor de correo o el servidor del ERP? Si ves lentitud, timeouts o saturación, el ERP puede generar patrones de reintento y cola. Por lo tanto, revisa rendimiento, red y I/O antes de culpar al correo.
9) ¿Qué debo exigir al soporte para un flujo de facturación y cobranza? SLA por severidad, escalamiento real, bitácora y recomendaciones documentadas. Además, pide pruebas de salida a producción y plan de monitoreo.
10) ¿Cuándo conviene migrar a una arquitectura VPS/Cloud? Cuando hay picos recurrentes, cierres con lotes masivos y necesidad de separar servicios. En ese caso, una plataforma con monitoreo y margen reduce incidentes repetitivos.
Para convertir esta evaluación en un plan con responsables, pruebas y monitoreo continuo, lo más eficiente suele ser pedir un diagnóstico con alcance y entregables al contactar con la agencia Cobalt Blue Web.
Proveedor de Email Empresarial para Aspel no significa “tener una bandeja bonita”; más bien, significa asegurar que el sistema envíe CFDI, avisos y confirmaciones con trazabilidad, entregabilidad y soporte. Además, cuando el correo falla, la operación no se detiene de inmediato, aunque sí se vuelve ciega: no hay confirmaciones, no hay seguimiento y, por lo tanto, aumentan reclamaciones y reprocesos.
Qué debe resolver un proveedor de correo para Aspel en el día a día
Primero, Aspel se usa para ventas, contabilidad y procesos administrativos donde el correo es el canal natural de salida: envío de facturas, estados de cuenta, recordatorios y notificaciones. Además, los picos existen, sobre todo en cierres, cobranza y periodos de alta facturación. Por eso, un proveedor serio no se mide por “si envía un correo de prueba”, sino por cómo sostiene volumen, adjuntos y reputación sin degradarse.
Asimismo, es clave que el servicio deje evidencia: registros de entrega, rebotes clasificados y tiempos de cola. En consecuencia, el área administrativa puede distinguir entre “se envió” y “se entregó”, y entonces toma decisiones con datos, no con suposiciones.
Separación operativa: correo humano vs correo transaccional del sistema
En segundo lugar, conviene separar lo que envían las personas (ventas, cobranza, soporte) de lo que envía el sistema (notificaciones automáticas, CFDI, avisos). De hecho, mezclar ambos mundos en un mismo buzón suele contaminar reputación: si una campaña o un lote masivo dispara quejas o rebotes, también se afecta el correo humano.
Por lo tanto, un buen diseño usa identidades y rutas distintas: por ejemplo, un subdominio de envío para el sistema y el dominio principal para cuentas humanas. Además, esa separación simplifica políticas de autenticación, límites y monitoreo. Así, si mañana hay un pico de facturación, no arrastras al equipo completo a spam.
Autenticación y reputación: la base técnica que define la bandeja de entrada
Detecta rebotes y spam antes del pico
Ahora bien, la mayoría de los problemas de entregabilidad no aparecen “por azar”; más bien, aparecen por autenticación incompleta o desalineada. Por eso, el Proveedor de Email Empresarial para Aspel debe incluir un alcance claro de DNS, alineación y verificación, no solo “te ayudamos con SPF”.
SPF con permisos mínimos y control de cambios
En primer lugar, SPF autoriza quién puede enviar por tu dominio. Sin embargo, cuando se agregan includes sin control, se exceden límites de consultas y, entonces, el registro deja de validar. Por lo tanto, la regla práctica es: permisos mínimos, inventario de orígenes y un procedimiento para cambios, especialmente si hay múltiples herramientas enviando (ERP, CRM, formularios, etc.).
DKIM estable: firma consistente y rotación de llaves
Además, DKIM debe firmar los correos con llaves controladas por la organización. Asimismo, la firma debe ser consistente y rotar cuando corresponde, sin “romper” el envío. En consecuencia, si se migra infraestructura o se cambia relay, la firma sigue alineada y la reputación no se reinicia sin necesidad.
DMARC por etapas: monitoreo, ajuste y endurecimiento
De manera complementaria, DMARC se implementa por etapas: primero en monitoreo para observar reportes, después en cuarentena, y finalmente en rechazo cuando el tráfico está limpio. Así, reduces spoofing y, al mismo tiempo, evitas bloquear correos legítimos por una mala alineación de From/Return-Path.
Adjuntos CFDI: XML/PDF, tamaños y patrones que disparan filtros
Además, en Aspel el envío de CFDI suele incluir XML y PDF. Por lo tanto, el servicio debe contemplar políticas de adjuntos: tamaños máximos, compresión razonable, y límites por mensaje. Asimismo, los filtros aprenden patrones; en consecuencia, si se envían cientos de correos idénticos con adjuntos similares en pocos minutos, se eleva el riesgo de bloqueo o spam.
Por eso, conviene implementar rate limit y ventanas de envío para lotes, además de plantillas con variación mínima (por ejemplo, asuntos consistentes, aunque no clones exactos) y encabezados correctamente firmados. En otras palabras, se trata de enviar “como operación”, no “como campaña”.
Colas, reintentos y trazabilidad: control sin duplicados
En un escenario real, algunos destinatarios van a rebotar, y algunos servidores van a retrasar entregas. Por lo tanto, necesitas colas y reintentos controlados, no reenvíos manuales a ciegas. Además, cuando hay reintentos sin control, aparecen duplicados, quejas y, por consiguiente, mala reputación.
Aquí es donde el Proveedor de Email Empresarial para Aspel debe ofrecer, como mínimo, logging por mensaje, códigos de rebote interpretados y tiempos de entrega promedio. Asimismo, debe existir un procedimiento para “picos”: qué pasa cuando el volumen sube 5x, cómo se cola y cuándo se escala.
Integración típica en Windows: puertos, TLS y credenciales de aplicación
Seguimiento a tiempo, sin pérdidas
En muchas implementaciones, Aspel corre en Windows o en un entorno mixto con recursos compartidos. Por ello, la integración debe considerar conectividad saliente, puertos (587/465 según el caso), y TLS activo. Además, es preferible usar credenciales de aplicación o relay controlado, en lugar de la contraseña de un usuario humano, porque así reduces exposición y facilitas auditoría.
Asimismo, conviene validar desde el servidor: resolución DNS, ruteo, latencia y disponibilidad del relay. De hecho, problemas de red o saturación del servidor disparan reintentos y, por lo tanto, cambian el patrón de envío, lo cual afecta reputación. Si estás buscando una base estable para este tipo de integración, puedes implementar un servidor VPS Windows para Aspel y, además, estandarizar la salida SMTP con trazabilidad.
Soporte con SLA: lo que debes exigir y cómo medirlo
Aunque la configuración sea correcta, la operación cambia: hay picos, hay listas que envejecen, y hay destinatarios con políticas agresivas. Por eso, no basta con “soporte por WhatsApp”; en cambio, necesitas SLA por severidad, escalamiento y bitácora. Además, un buen soporte no solo apaga fuegos; también propone ajustes: rotación de DKIM, revisión de rebotes, y pruebas de destinos.
En este punto, el Proveedor de Email Empresarial para Aspel se evalúa con preguntas simples: ¿cuánto tarda en responder a un incidente crítico?, ¿qué evidencia entrega?, ¿qué recomendaciones deja documentadas? Si quieres aterrizar un alcance con responsables y entregables, una vía directa es contactar con la agencia Cobalt Blue Web para definir implementación, monitoreo y mejora continua con criterios medibles.
Infraestructura y rendimiento: cuando el servidor lento empeora la entregabilidad
Alineación real, sin suposiciones
Además, el correo no vive aislado del servidor. Por ejemplo, si el servidor que hospeda Aspel se satura, se atrasan procesos, se rompen ventanas de envío y se disparan reintentos. En consecuencia, el correo puede “salir”, aunque llegue tarde o llegue duplicado. Por eso, si ya viste síntomas de intermitencia, conviene atacar estabilidad antes de culpar al correo.
Asimismo, cuando la infraestructura es el cuello de botella, el Proveedor de Email Empresarial para Aspel termina “pagando el costo” en reputación, aunque el problema original sea CPU, disco o red. Por lo tanto, conviene diseñar capacidad con margen, y además habilitar monitoreo de cola, latencia y errores.
Checklist de contratación: señales de un servicio que sí aguanta operación
Primero, valida autenticación completa con alineación real (SPF, DKIM y DMARC verificados en headers). Después, exige monitoreo de rebotes y retrasos, no solo “estadísticas bonitas”. Además, pide control de colas, rate limit y reintentos. Asimismo, revisa políticas de adjuntos y límites por hora. Finalmente, define SLA, escalamiento y documentación.
Además, al negociar con el Proveedor de Email Empresarial para Aspel, solicita desde el inicio la evidencia de pruebas (headers, rebotes y tiempos de cola) para que la operación pueda auditarse sin depender de “lo que se cree que pasó”.
Bajo este enfoque, el Proveedor de Email Empresarial para Aspel deja de ser una compra “por precio” y se vuelve una decisión de continuidad: menos reprocesos, menos reclamaciones y más trazabilidad.
Seguimiento a tiempo, sin pérdidas
Preguntas frecuentes: sobre correo para Aspel
¿Qué es lo primero que debo configurar para que Aspel no caiga en spam? Primero, autentica con SPF/DKIM/DMARC y valida alineación en headers. Además, controla volumen y evita lotes masivos sin rate limit.
¿Conviene separar el dominio del sistema y el dominio de cuentas humanas? Sí. De hecho, separar subdominio de envíos transaccionales protege reputación del correo humano y simplifica políticas.
¿Qué problemas generan más rebotes en facturación por correo? Por lo general, listas desactualizadas, buzones llenos y dominios con políticas estrictas. Además, adjuntos pesados y picos de envío elevan rebotes.
¿Cómo evito duplicados cuando el sistema reintenta? Configura colas y reintentos con control, y registra cada intento con su código. Asimismo, evita reenvíos manuales sin revisar logs.
¿Qué debo pedirle al soporte para no quedarme “a ciegas”? Pide bitácora, tiempos de respuesta por severidad y reportes de rebotes/retrasos. Además, exige recomendaciones documentadas, no solo mensajes.
¿Influye el rendimiento del servidor donde corre Aspel? Sí. Cuando el servidor está lento, se atrasan procesos y se alteran patrones de envío; por lo tanto, puede deteriorarse la entregabilidad.
¿Puedo enviar CFDI con XML/PDF sin bloqueos? Sí, aunque debes controlar tamaños, ritmo de envío y autenticación. Además, prueba con destinos críticos y monitorea spam rate.
¿Qué significa “alineación” de From y Return-Path? Significa que el dominio visible y el dominio técnico (envelope) coinciden con la identidad autenticada, lo cual mejora confianza del receptor.
¿Cuándo sé que ya necesito un servicio más profesional? Cuando hay picos de facturación, retrasos, rebotes recurrentes, o dependencia fuerte del correo para cobranza y confirmaciones.
¿Qué incluye un Proveedor de Email Empresarial para Aspel cuando trabaja bien? Incluye autenticación alineada, control de colas y reintentos, monitoreo de reputación, políticas de adjuntos, soporte con SLA y documentación operativa.
Además, si quieres convertir esto en un proyecto con alcance, pruebas de salida a producción y monitoreo continuo, el Proveedor de Email Empresarial para Aspel se vuelve mucho más confiable cuando se implementa con evidencias, no con suposiciones. Por lo tanto, el siguiente paso lógico es contactar con la agencia Cobalt Blue Web y aterrizar tu caso con un plan operativo de correo y sistemas.
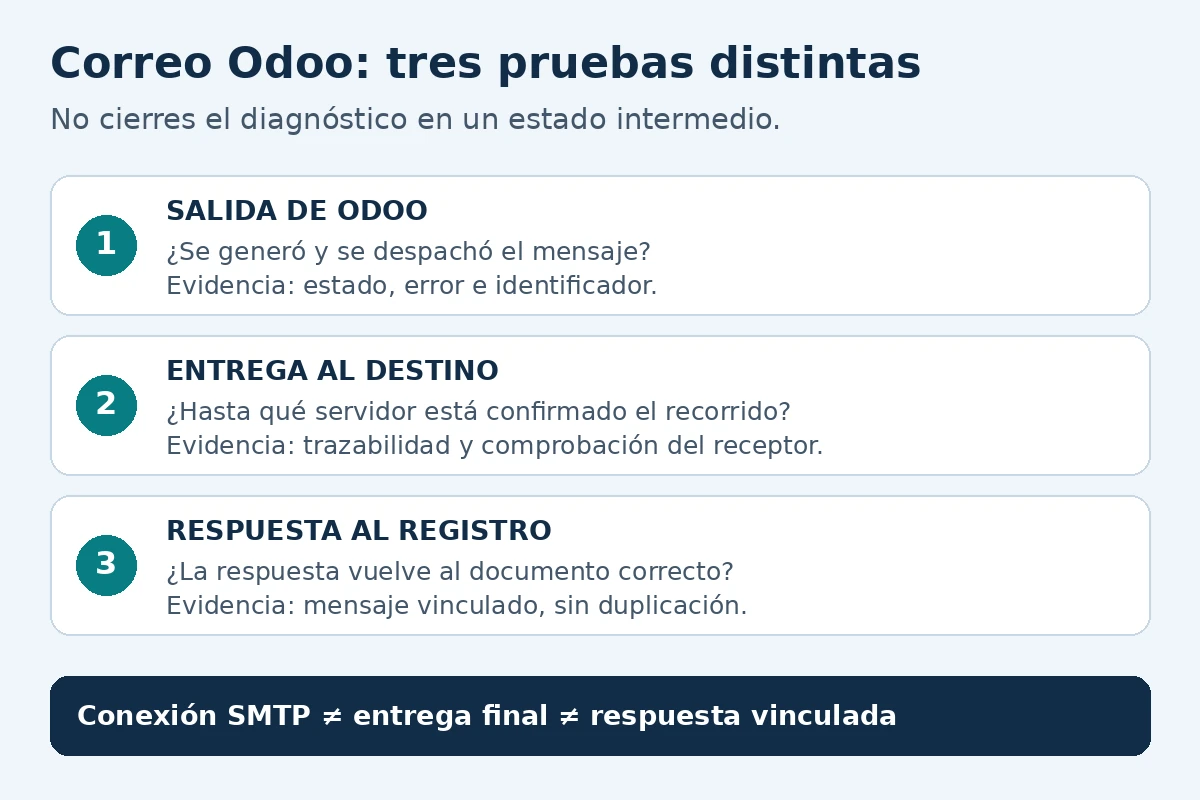
En Odoo, «enviado» no significa necesariamente «en la bandeja del cliente», y recibir una respuesta en un buzón no demuestra que haya quedado vinculada al documento correcto. El diagnóstico útil separa tres recorridos: salida desde Odoo, entrega por el servicio de correo y regreso de la respuesta al registro.
Esta guía usa la documentación de Odoo 19.0 como referencia explícita. Antes de aplicar un paso, identifica tu versión y modalidad: Odoo Online, Odoo.sh o instalación propia. Los menús, proveedores y responsabilidades pueden variar. El objetivo es reunir evidencia y hacer una prueba controlada, no cambiar DNS, credenciales o políticas de seguridad por ensayo y error.
Mapa de diagnóstico, no captura de una instalación. Cada etapa requiere su propia comprobación.
1. Dibuja tu recorrido antes de tocar parámetros
Anota qué aplicación genera el mensaje, qué servidor lo envía, qué dominio aparece como remitente y por dónde vuelven respuestas y rebotes. Incluye plantillas o módulos personalizados que cambien remitentes. Identifica al responsable de Odoo, al proveedor de correo y al administrador del dominio; pueden ser tres equipos distintos.
El correo del ERP no sustituye necesariamente los buzones de las personas. Una respuesta vinculada a una cotización y un mensaje nuevo dirigido a un alias tienen finalidades distintas. La documentación de mensajes entrantes de Odoo 19 explica esas rutas, incluidos alias, catchall y rebotes. No conviertas el catchall en un buzón general para cualquier mensaje.
Para la salida, comprueba el mecanismo admitido por tu versión e integración. La documentación de correo saliente describe servidores SMTP externos y selección del remitente. Que un proveedor comercial ofrezca una API no significa que Odoo la utilice sin un módulo compatible y mantenido.
2. Árbol de diagnóstico: abre sólo la rama de tu síntoma
Las ramas son una guía de investigación, no ejecutan cambios ni envían mensajes. Guarda primero el error y la hora. Evita reenviar un lote entero mientras desconoces cuáles destinatarios ya recibieron el original.
A. Odoo no genera o no despacha el mensaje
Primera pregunta: ¿existe un mensaje asociado al documento o sólo se esperaba que una automatización lo creara?
Si no existe, revisa con el responsable funcional la acción, plantilla, destinatario y condición que debían generarlo.
Si existe y sigue pendiente, registra su estado y antigüedad. Solicita evidencia del procesamiento de la cola y de las tareas programadas aplicables.
Si aparece un fallo, conserva el texto exacto y el destinatario afectado antes de reintentar.
No concluyas: «es spam» cuando todavía no hay evidencia de que el mensaje salió. Una cola detenida, un destinatario vacío y una autenticación rechazada son problemas distintos.
B. El servicio rechaza el envío o devuelve un rebote
Identifica quién emitió el error: el proveedor de salida o el servidor del destino. Guarda código, texto, fecha y referencia del mensaje. Distingue una respuesta temporal de un rechazo permanente y sigue la explicación del proveedor; no reduzcas todos los códigos a «contraseña incorrecta».
Comprueba límites contratados, remitentes permitidos y tamaño del mensaje con su codificación y adjuntos. El límite real puede no coincidir con el peso del archivo en disco. Si sólo falla un destinatario, investiga esa ruta antes de cambiar una configuración que funciona para los demás.
Escala con evidencia: un resumen del error y el identificador permiten correlacionar registros. Nunca incluyas contraseñas, tokens ni secretos en un ticket o captura.
C. El servidor aceptó el mensaje, pero no aparece en la bandeja
Verifica qué aceptación está documentada: entregar el mensaje al proveedor de salida no equivale a que el servidor receptor lo haya aceptado. Pide la trazabilidad hasta el siguiente salto conocido, sin presentar un estado intermedio como entrega final.
Con un destinatario de prueba autorizado, revisa bandeja, carpeta de no deseados y cuarentena si existe. Solicita al administrador receptor información del mensaje concreto. La autenticación puede pasar y aun así intervenir filtros, reputación o políticas del destinatario. No hay garantía universal de bandeja de entrada.
No hagas: cambiar palabras para burlar filtros, comprimir un adjunto para ocultarlo o pedir que se desactive la protección del receptor. Corrige identidad, contenido legítimo y condiciones documentadas.
D. La respuesta llega al correo, pero no al registro de Odoo
Responde al mensaje original de prueba; no empieces un correo nuevo con el mismo asunto. Comprueba el Reply-To, el recorrido entrante configurado y la asociación de referencias del mensaje. Un asunto parecido no basta para identificar el documento.
Revisa con el administrador el alias y modelo de destino, así como reenvíos o servidores entrantes que correspondan a esa instalación. Odoo documenta la vinculación de respuestas mediante referencias de mensajes. El catchall espera respuestas a mensajes previos, no es una dirección genérica para crear cualquier registro.
Cierre de la prueba: la respuesta aparece una sola vez, en el registro correcto y accesible sólo para los usuarios que deban verla. Recibirla en un buzón intermedio es un avance, no el cierre.
La guía oficial de problemas comunes de correo en Odoo ayuda a interpretar fallos, límites y evidencias para soporte. Usa las pantallas de tu versión; no ejecutes instrucciones de otra modalidad como si fueran intercambiables.
3. SPF, DKIM y DMARC: qué debe alinearse realmente
Según RFC 9989, publicado en mayo de 2026, DMARC pasa si existe SPF válido y alineado O una firma DKIM válida y alineada con el dominio del From visible. No exige que From, Return-Path y DKIM sean tres cadenas idénticas.
SPF: para esta evaluación se considera el dominio autenticado del MAIL FROM del sobre.
DKIM: se considera el dominio d= de una firma validada.
Alineación estricta: exige igualdad exacta del dominio correspondiente con el del From.
Alineación relajada: compara su dominio organizacional conforme al estándar; no basta con que dos nombres «se parezcan».
Ejemplo conceptual: DKIM puede pasar y estar alineado aunque SPF no lo esté; esa vía puede satisfacer DMARC. Si SPF y DKIM pasan pero ninguno está alineado, no basta. El resultado de DMARC tampoco certifica que un mensaje sea deseado, legítimo en todos sus contenidos o destinado a la bandeja principal.
SPF tiene además un límite específico: RFC 7208, sección 4.6.4, limita a 10 los términos que provocan consultas DNS durante la evaluación, incluidos mecanismos y modificadores como include y redirect. No son simplemente diez dominios escritos ni diez registros DNS totales. La evaluación incluye dependencias; si se excede ese límite, el resultado es permerror. Debe revisarlo el administrador, no «arreglarse» añadiendo autorizaciones indiscriminadas.
Con un SMTP externo, los valores de autenticación deben corresponder al proveedor que realmente envía. No copies los registros del servicio de Odoo como si autorizaran a cualquier tercero. Documenta las fuentes autorizadas y la política existente antes de proponer cambios; no rebajes automáticamente una política a monitoreo para hacer desaparecer un fallo.
4. Un subdominio organiza, no blinda la reputación
Separar flujos puede facilitar responsables, métricas y políticas. No demuestra aislamiento absoluto de reputación: receptores y proveedores pueden considerar distintas señales y relaciones entre dominios, infraestructura y comportamiento. Tampoco transforma un envío no solicitado en uno aceptable.
La operación debe distinguir notificaciones esperadas de campañas, controlar destinatarios y respetar los límites y requisitos aplicables. No adoptes límites de grandes emisores como si fueran los de todo negocio. Si cambia el volumen, solicita al proveedor las condiciones vigentes para tu cuenta y comprueba que el flujo legítimo pueda procesarse sin saturación.
Usa el mecanismo de autenticación admitido por la combinación concreta de proveedor y versión, incluido OAuth cuando corresponda. No existe una contraseña de aplicación universal. Un método soportado y una cuenta con alcance adecuado son más importantes que copiar parámetros de una captura ajena.
5. Prueba de aceptación: envío, adjunto, respuesta y rebote
Prepara un documento ficticio claramente marcado como prueba, sin datos fiscales, personales o comerciales reales. Si tu operación utiliza PDF y XML, incluye archivos de prueba inocuos que reproduzcan su formato y tamaño razonable. Usa buzones autorizados para la prueba, no direcciones inventadas de terceros.
Texto simple: envía desde el flujo funcional que necesitas, no sólo desde una pantalla de configuración. Registra documento, hora con zona y referencia del mensaje.
Adjuntos: repite con los archivos ficticios y verifica recepción e integridad. Compara el resultado con el mensaje sin adjuntos.
Identidad: revisa los encabezados en el destino autorizado, incluyendo resultados de autenticación, From y Reply-To. Conserva una copia interna depurada de información sensible.
Respuesta: responde al original y comprueba que aparezca en el registro correcto de Odoo, una sola vez.
Error controlado: coordina con el administrador un destino o mecanismo de prueba de rechazo. Verifica quién recibe el aviso y cómo se identifica el destinatario afectado. No generes rebotes hacia personas ajenas.
Cierre: documenta resultados, pendientes y responsables. Repite sólo los casos necesarios tras una corrección autorizada.
La prueba de conexión SMTP es un control preliminar. Odoo advierte que un resultado exitoso no asegura que el mensaje salga: pueden persistir restricciones del proveedor. La aceptación necesita el recorrido funcional completo, incluida la respuesta si tu negocio depende de ella.
6. Ficha de evidencia para soporte
Este desplegable no transmite ni almacena información. Copia la ficha a tu expediente interno y comparte con soporte sólo lo necesario por un canal autorizado.
Abre la ficha del incidente de correo
Versión y modalidad de Odoo: ____
Fecha, hora y zona horaria: ____
Flujo y documento ficticio o referencia anonimizada: ____
Síntoma: no generado / pendiente / rechazado / no visible / respuesta sin vincular: ____
Identificador del mensaje y del proveedor, sólo para soporte autorizado: ____
Destinatario anonimizado y dominio de destino pertinente: ____
Responsable, siguiente comprobación y resultado: ____
Oculta direcciones personales, contenido, identificadores internos y demás datos innecesarios. Los encabezados también pueden contener información privada. No publiques su versión completa en foros ni la envíes a herramientas sin autorización.
7. Qué soporte vale la pena contratar
Pide que el alcance diferencie generación en Odoo, servicio de salida, dominio y entrada. Debe quedar claro quién puede consultar registros, coordinar con el receptor, revisar una plantilla y proponer un cambio. Una promesa genérica de «correo funcionando» no define esas responsabilidades.
El servicio con experiencia puede justificar un costo mayor si evita que tu equipo invierta horas reenviando facturas o buscando respuestas perdidas. Evalúa ese valor mediante pruebas, atención y documentación, no mediante una garantía imposible de que ningún mensaje irá a spam. Cobalt Blue Web puede ser una opción a evaluar cuando necesitas acompañamiento técnico; compara el alcance escrito con el de otros proveedores y decide libremente.
Si Odoo está lento, correlaciona la antigüedad de la cola con registros y carga del sistema antes de culpar a la infraestructura. La lentitud no prueba por sí sola duplicación de mensajes. Cambiar de servidor tampoco corrige automáticamente un alias, un remitente no autorizado o una política del receptor.
8. IA para clasificar, no para reenviar a ciegas
La IA puede agrupar errores depurados, resumir una cronología o sugerir qué evidencia falta. Contrasta cada hipótesis con el código del proveedor y el registro original. No le entregues secretos, facturas reales ni encabezados completos a un servicio no autorizado.
No permitas que una clasificación dispare reenvíos masivos o cambie políticas de dominio sin revisión. El avance medible es saber qué etapa falló, qué evidencia lo demuestra y quién puede resolverla. Eso mejora la operación sin convertir un mensaje ambiguo de «enviado» en una promesa de entrega.
Proveedores de servidores cloud en México no es una búsqueda “de infraestructura”, sino, más bien, una búsqueda de continuidad: si tu sistema se cae, si se vuelve lento, o si el soporte tarda, entonces la operación se detiene y, por lo tanto, el costo real aparece en horas perdidas, clientes esperando y tareas críticas acumuladas. Además, aunque dos ofertas parezcan parecidas, en la práctica se separan cuando hay carga, cuando hay incidentes, o cuando toca recuperar.
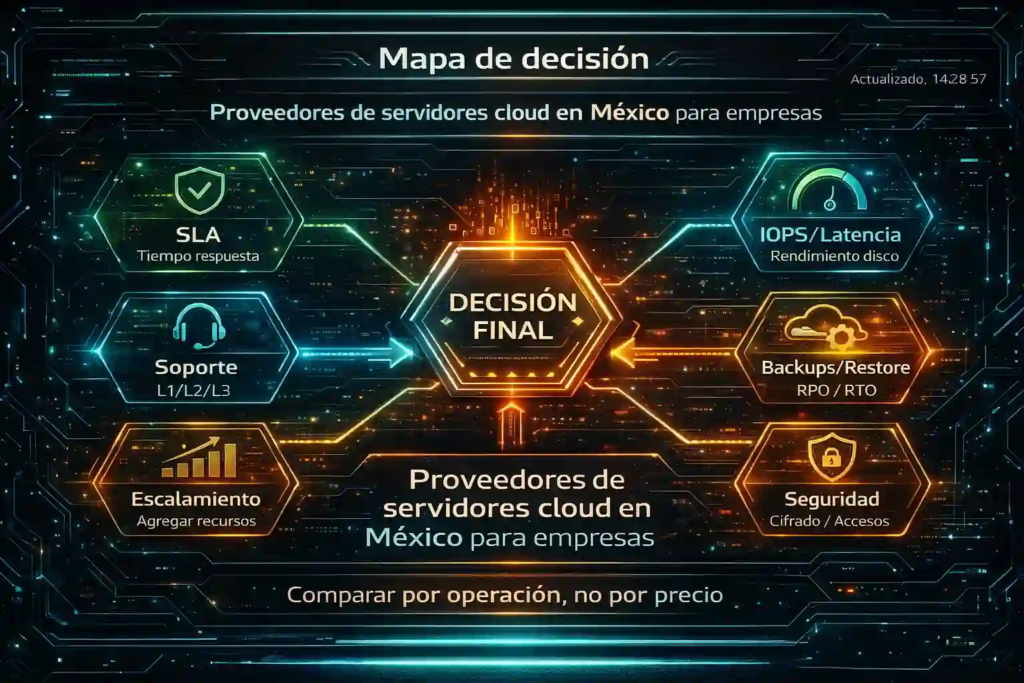
Ahora bien, para comparar bien, conviene cambiar el enfoque: en lugar de elegir por “GB y precio”, evalúa por operación. Es decir, revisa recursos garantizados, rendimiento de almacenamiento, monitoreo, backups con restauración probada y soporte con escalamiento. En consecuencia, la elección se vuelve técnica, medible y defendible.
Proveedores cloud empresariales en México: qué estás comprando en realidad
Cuando una empresa contrata “cloud”, normalmente contrata una combinación de recursos y operación. Por eso, conviene pedir claridad en cuatro frentes: cómputo (vCPU/RAM), almacenamiento (latencia/IOPS), red (estabilidad y rutas), y operación (soporte, mantenimiento, backups). Además, si tu carga es un ERP o un sistema administrativo, entonces el desempeño percibido depende mucho del disco y de la red, no solamente de la CPU.
Asimismo, aunque haya ofertas “ilimitadas” en marketing, en infraestructura casi todo tiene límites técnicos. Por lo tanto, el proveedor confiable es el que explica límites, umbrales y cómo se escala sin improvisar.
Proveedor de nube para empresas: hyperscaler vs proveedor administrado
En México puedes elegir entre nubes globales de autoservicio y proveedores más enfocados a acompañamiento y administración. Sin embargo, lo relevante no es la etiqueta, sino el modelo operativo: ¿tu equipo interno puede operar monitoreo, parches, seguridad y recuperación?, ¿o necesitas que el proveedor lo haga y lo documente?
De hecho, si tu empresa no tiene un equipo TI dedicado 24/7, entonces el valor no está en “tener consola”, sino en tener respuesta, guías, y acciones repetibles. En consecuencia, el proveedor administrado suele ser más compatible con empresas que requieren estabilidad sin convertirse en un centro de operaciones.
Cómo detectar si tu servidor actual ya quedó corto para un sistema crítico
Antes de cambiar, primero valida señales. A veces la empresa normaliza la lentitud intermitente; sin embargo, eso suele ser el inicio de un cuello de botella. Por ejemplo, si hay picos por cierres, por reportes, por timbrado, o por sincronizaciones, entonces la carga real está superando el dimensionamiento.
En este contexto, proveedores de servidores cloud en México deja de ser “una lista” y se vuelve un proceso de evaluación.
Rendimiento real: el disco manda, y el proveedor debe demostrarlo
En sistemas empresariales, el almacenamiento suele ser el cuello silencioso. Por lo tanto, cuando preguntes por “SSD”, pide algo más específico: latencia típica, IOPS incluidas, y comportamiento en hora pico. Asimismo, pregunta si el proveedor permite separar volúmenes (SO, datos y logs), porque, de hecho, esa separación reduce fricción cuando la base crece.
Además, evita caer en el error de subir CPU para arreglar disco lento. En consecuencia, el proveedor serio debe ayudarte a identificar la causa dominante y, luego, a dimensionar lo que de verdad limita.
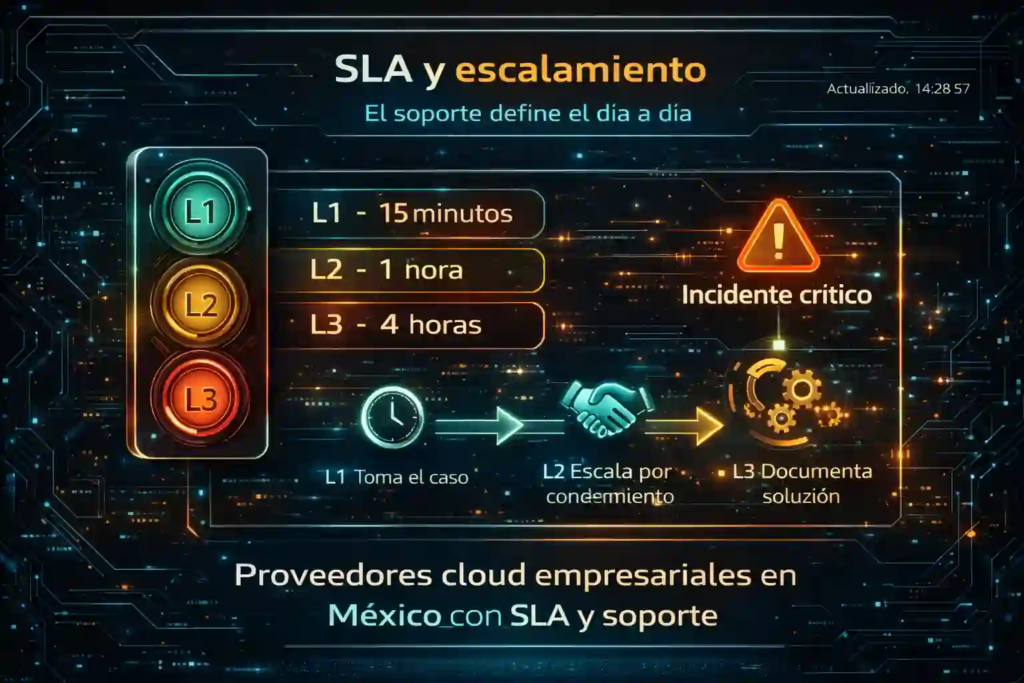
Soporte, SLA y escalamiento: el factor que define el día a día
El soporte define el día a día
Aunque el hardware sea bueno, la operación se gana con soporte. Por eso, pregunta con precisión: tiempos de respuesta, niveles de escalamiento (L1/L2/L3), canales, y criterios de “incidente crítico”. Además, pide evidencia de proceso: bitácoras, ventanas de mantenimiento, y cómo documentan cambios.
En otras palabras, el SLA no sirve si no hay un mecanismo real para cumplirlo. Por lo tanto, compárate contra tu propia realidad: ¿cuántas horas puedes estar caído?, ¿qué pasa si el sistema se vuelve lento a las 9:00?, ¿quién atiende y en cuánto tiempo?
Aquí, además, conviene remarcar que proveedores de servidores cloud en México se diferencian mucho más por operación y soporte que por “marca”.
Si necesitas una base empresarial para dimensionar y escalar con claridad, revisa opciones de servidores virtuales cloud VPS y compáralas con tu carga real.
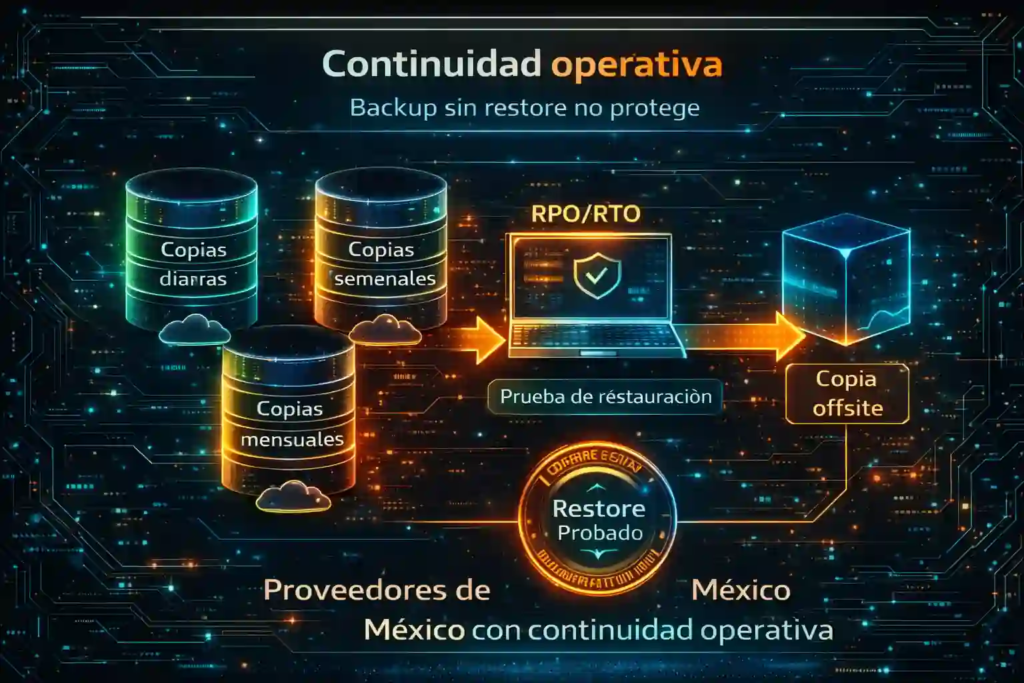
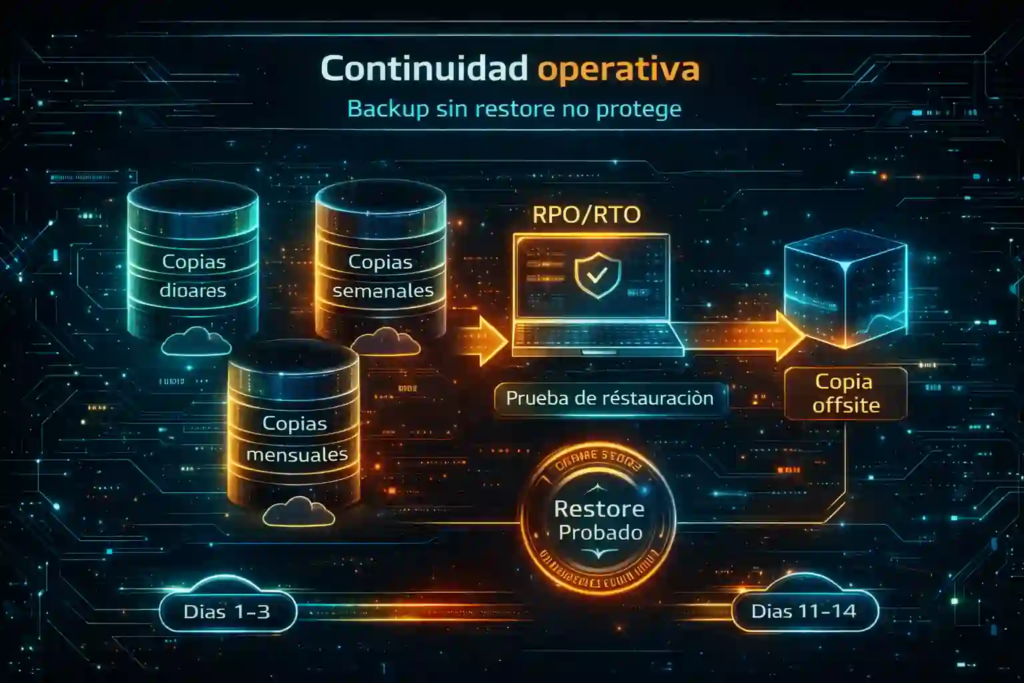
Backups y continuidad: backup sin restauración probada no protege
Backup sin restore no protege
En continuidad operativa, la pregunta no es “¿hay backups?”, sino “¿se restauran y se prueban?”. Por lo tanto, exige: retención diaria/semanal/mensual, copia fuera del servidor, pruebas de restauración calendarizadas, y definición de RPO/RTO. Además, pregunta qué pasa si falla un backup y cómo te enteras.
Para aterrizarlo con criterios claros y lenguaje de negocio, revisa esta guía: respaldos de equipos de cómputo en la nube. Asimismo, úsala como checklist para comparar proveedores, porque, en consecuencia, reduces el riesgo de “respaldos decorativos”.
De hecho, cuando hay incidentes, el diferencial aparece aquí: la empresa que restaura en horas opera; la que no, improvisa.
En este punto, proveedores de servidores cloud en México debe evaluarse con una pregunta central: “¿Cómo vuelvo a operar si algo falla hoy?”
Windows Server y compatibilidad: cuando tu sistema lo exige
Muchas empresas operan sistemas administrativos sobre Windows, y eso no es negociable si la aplicación lo requiere. Por lo tanto, el proveedor debe dominar Windows en producción: parches, hardening, RDP estable, políticas de acceso y ajustes para rendimiento. Además, conviene que el soporte entienda el tipo de carga (multiusuario, escritorio remoto, base de datos).
Aun cuando existan alternativas, en la práctica el riesgo está en forzar migraciones de plataforma sin plan. En consecuencia, si tu operación depende de Windows, el proveedor debe ofrecer una ruta clara, estable y soportada.
Seguridad operativa: controles mínimos que debes exigir
La seguridad no es solo “firewall”. Por eso, pide controles operativos: MFA, gestión de privilegios, bitácora de accesos, segmentación de red, políticas de actualización, y respaldos offsite. Además, pregunta por responsabilidades: qué cubre el proveedor y qué te corresponde a ti, porque, de lo contrario, cada parte asume que la otra lo hace.
Asimismo, si manejas datos sensibles, integra prácticas como cifrado en tránsito, revisión de puertos expuestos y políticas de cuentas. En consecuencia, reduces superficie de ataque sin complicar la operación.
En términos prácticos, proveedores de servidores cloud en México debe poder explicarte seguridad como proceso, no como promesa.
Método comparativo en 5 pasos para elegir sin sesgos
Comparar por operación, no por precio
Para decidir con evidencia, aplica este orden:
Define carga: usuarios concurrentes, base de datos, picos y procesos pesados.
Identifica el cuello dominante: disco, RAM, red o CPU (idealmente con métricas).
Compara recursos garantizados y almacenamiento (latencia/IOPS), no solo “tamaño”.
Valida continuidad: backups, restore probado, RPO/RTO y copia offsite.
Evalúa soporte: SLA real, escalamiento y operación documentada.
Después, si dos proveedores empatan, decide por el que tenga mejor capacidad de acompañamiento en incidentes y cambios. Por lo tanto, tu decisión se vuelve operacionalmente sólida.
Además, si hoy no tienes métricas, entonces el primer paso es instalarlas, porque, en consecuencia, comparas mejor y negocias mejor.
Preguntas que obligan a respuestas útiles (y evitan sorpresas)
Para cerrar la brecha entre marketing y realidad, pregunta así:
¿Qué latencia e IOPS se esperan en hora pico, y cómo se monitorea?
¿Cómo se alertan incidentes y quién atiende fuera de horario?
¿Cómo se escala CPU/RAM/disco y cuánto tarda el cambio?
¿Cómo se ejecuta un restore completo y cuánto tarda?
¿Qué incluye soporte: infraestructura, sistema operativo, hardening, o solo “encendido”?
Mientras más claras sean las respuestas, más predecible será tu operación. Además, si el proveedor evita responder, entonces esa evasión también es una señal.
Aquí, proveedores de servidores cloud en México se vuelve una decisión de riesgo controlado, no de fe.
CTA 3 (integrado): Si quieres aterrizar tu caso con un criterio técnico y operativo, puedes contactar con la agencia y pedir una recomendación basada en carga, backups y continuidad.
Costos reales: lo caro no es el servidor, es la interrupción
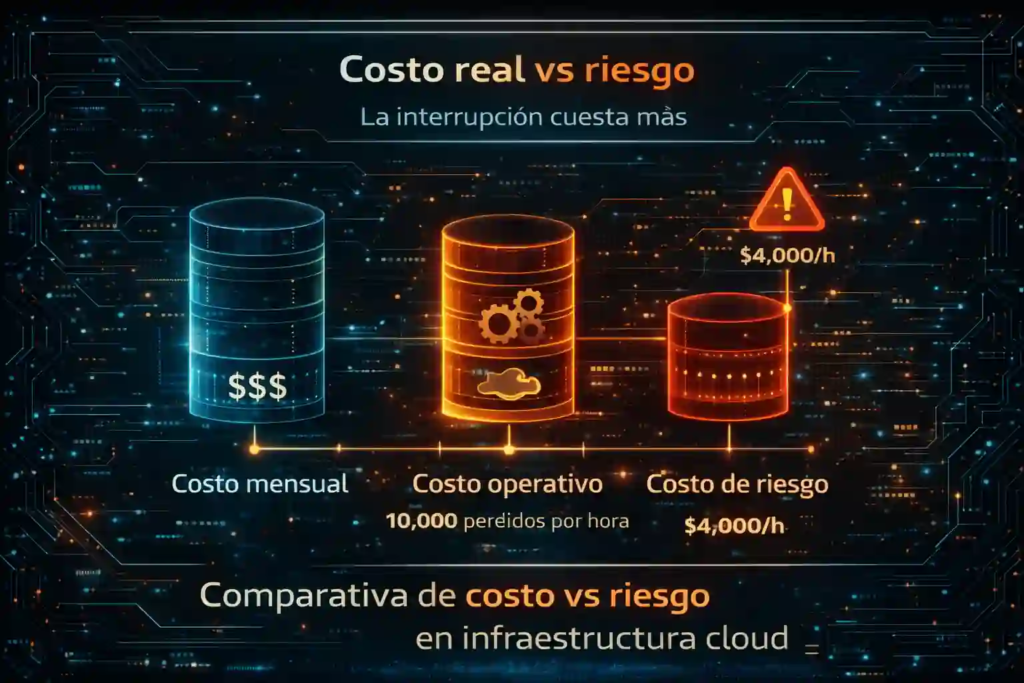
Es tentador elegir el plan más barato. Sin embargo, lo que suele salir caro es el downtime, la pérdida de productividad, y la recuperación improvisada. Por lo tanto, separa costo mensual (infraestructura) de costo operativo (soporte/monitoreo/backups) y de costo de riesgo (tiempo muerto y pérdida de datos).
Además, si tu empresa timbra, factura o cierra contabilidad sobre el sistema, entonces una hora caída puede costar más que un upgrade anual. En consecuencia, tu comparativa debe incluir impacto, no solo precio.
En este cierre operativo, proveedores de servidores cloud en México se debe elegir por estabilidad sostenida, soporte serio y continuidad probada.
Si tu objetivo es crecer con margen y reducir incidentes recurrentes, revisa servidores virtuales cloud VPS y compáralos contra tu checklist antes de decidir.
La interrupción cuesta más
FAQ´s
1) ¿Cómo comparar proveedores de servidores cloud en México para empresas? Primero compara recursos garantizados, luego valida disco (latencia/IOPS), después revisa backups con restauración probada y, finalmente, confirma soporte con SLA y escalamiento.
2) ¿Qué debo pedirle a un proveedor cloud para correr un ERP estable? Pide rendimiento de almacenamiento, monitoreo, backups offsite con restore probado, capacidad de escalamiento, y soporte con tiempos claros para incidentes críticos.
3) ¿Por qué el disco suele ser el cuello de botella en sistemas administrativos? Porque la base de datos escribe y lee constantemente; por lo tanto, si la latencia sube o las IOPS son bajas, el sistema se siente lento aunque la CPU no esté saturada.
4) ¿Qué significa “restore probado” y por qué importa? Significa que el backup se ha restaurado con éxito en pruebas; en consecuencia, no depende de suposiciones cuando ocurre un incidente real.
5) ¿Qué es RPO y RTO en continuidad operativa? RPO define cuánta información puedes perder; RTO define en cuánto tiempo vuelves a operar. Por eso, ambos deben acordarse y probarse.
6) ¿Cuándo conviene elegir un VPS Windows para sistemas administrativos? Cuando tu software depende de Windows, RDP y compatibilidad específica; además, conviene si necesitas soporte que conozca Windows en producción.
7) ¿Qué señales indican que debo cambiar de proveedor cloud? Lentitud intermitente, reinicios como “solución”, soporte lento en incidentes, backups sin pruebas de restore, y falta de métricas claras para diagnosticar.
8) ¿Cómo evaluar el SLA de un proveedor cloud? Revisa tiempos de respuesta, escalamiento (L1/L2/L3), cobertura fuera de horario y, además, evidencia de procesos (bitácoras, mantenimiento, alertas).
9) ¿Qué métricas mínimas debo monitorear siempre? CPU, RAM, disco (latencia/IOPS/cola/espacio), red (latencia/jitter/pérdida) y disponibilidad de servicios críticos del sistema.
10) ¿Cómo evitar pagar “barato” y terminar pagando más? Incluye en tu evaluación el costo del downtime, el costo operativo y la continuidad. En consecuencia, comparas por impacto real, no por precio nominal.
Caídas y lentitud en servidores cloud no aparecen “de la nada”; por el contrario, casi siempre son el resultado de una cadena de decisiones técnicas y operativas que, con el tiempo, se vuelven fricción: recursos insuficientes, almacenamiento saturado, falta de monitoreo, parches acumulados, o respaldos que existen “en teoría” pero no en práctica. Por lo tanto, si hoy tu sistema se siente inestable, no necesitas adivinar: necesitas un método.
Además, el problema rara vez se limita a “la nube” como concepto. De hecho, el fallo suele estar en algo más específico: una VM mal dimensionada, un disco con IOPS limitadas, una red con jitter, o un servidor Windows sin ajustes para carga real. En consecuencia, en lugar de perseguir síntomas, conviene analizar capas: aplicación, base de datos, sistema operativo e infraestructura. Así reduces costo operativo y, al mismo tiempo, aumentas disponibilidad.
Señales tempranas de degradación que casi nadie toma en serio
Aunque a veces el equipo lo normaliza, una operación estable no debería depender de “reiniciar y listo”. Por eso, antes de hablar de soluciones, identifica señales concretas:
Lentitud intermitente a ciertas horas (picos de CPU, RAM o disco).
Pantallas que “se congelan” al guardar, timbrar o actualizar inventario.
Sesiones remotas que se desconectan con frecuencia.
Errores 5xx, timeouts, o servicios que se reinician solos.
Backups que tardan más cada semana, o que ya no caben en la ventana nocturna.
Aun así, no todas las señales apuntan al mismo origen. Sin embargo, sí comparten algo: cuando aparecen, ya existe un cuello de botella. Por lo tanto, el objetivo real es ubicar el cuello y eliminarlo sin romper lo que ya funciona.
Diagnóstico por capas: cómo encontrar el cuello en menos de 60 minutos
Para no perderte, trabaja de arriba hacia abajo:
1) Capa de aplicación (sistema/ERP): Primero valida si la lentitud coincide con tareas específicas: timbrado, consultas, reportes, cierres de mes, conciliaciones, o cargas masivas. Luego, revisa si hay módulos nuevos, integraciones, o cambios recientes. Además, si el sistema es multiusuario, compara un usuario “rápido” contra uno “lento” para detectar si el problema es general o por perfil/datos.
2) Base de datos: Después, revisa tamaño, crecimiento y mantenimiento: índices, fragmentación, jobs, y estadísticas. Aun cuando el proveedor del sistema diga “es normal”, una base sin mantenimiento amplifica cualquier limitación de disco. En consecuencia, la degradación suele parecer “misteriosa”, aunque sea totalmente medible.
3) Sistema operativo (Windows/Linux): Posteriormente valida servicios, logs y consumo real. En Windows, por ejemplo, es común ver presión en disco por antivirus mal configurado, paginación agresiva, o servicios innecesarios. Por lo tanto, antes de “subir CPU”, revisa por qué se está consumiendo.
4) Infraestructura (VPS/Cloud): Finalmente, confirma límites del plan: vCPU reales, RAM garantizada, almacenamiento (tipo, IOPS), red, y si existe oversubscription. Además, cuestiona el “hasta” del proveedor: “hasta X vCPU” no es lo mismo que recursos garantizados.
Para atacar con precisión, vincula síntoma con métrica:
CPU alta sostenida: suele ser cálculo, procesos concurrentes o consultas pesadas. Sin embargo, también puede ser compresión, antivirus o indexaciones.
RAM al límite: provoca swapping/paginación; por lo tanto, aunque “CPU se vea bien”, el sistema se siente lento.
Disco con cola (queue length) alta o IOPS insuficientes: se nota en guardados lentos y consultas que se congelan. Además, suele empeorar con el crecimiento de la base.
Red inestable: causa desconexiones en RDP, sesiones remotas y servicios que “se caen” sin razón aparente.
En consecuencia, no basta con “más recursos”; necesitas el recurso correcto. Y, sobre todo, necesitas medir antes, durante y después.
Monitoreo que sí sirve: lo mínimo viable para operar con control
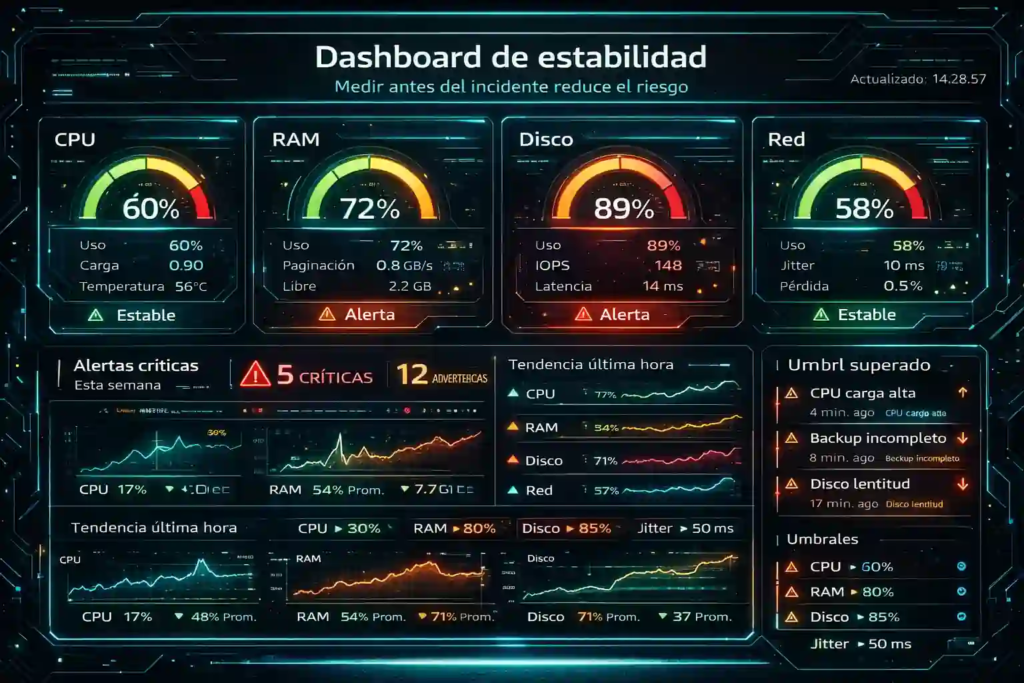
Medir antes del incidente reduce el riesgo
Si no hay monitoreo, todo se vuelve opinión. Por eso, arma un tablero con estos indicadores:
CPU: promedio, picos, y procesos top.
RAM: uso real, paginación, commits.
Disco: latencia, IOPS, throughput, espacio libre, y cola.
Red: latencia, pérdida de paquetes, jitter, retransmisiones.
Aplicación/DB: tiempos de consulta, bloqueos, errores, y jobs críticos.
Aquí aparece el punto clave: caídas y lentitud en servidores cloud se previenen más por disciplina operativa que por “comprar más”. Por lo tanto, si hoy no mides, mañana pagas doble: primero en horas-hombre, y luego en urgencias.
Además, cuando el monitoreo está bien, puedes definir umbrales y acciones: alertas, escalamiento, o ventanas de mantenimiento. En ese sentido, una operación madura es la que no se sorprende.
Si estás evaluando una base sólida para monitorear y escalar sin improvisación, revisa opciones de servidores virtuales cloud VPS orientados a carga empresarial.
Dimensionamiento correcto: no es “más grande”, es “más adecuado”
Una práctica común es “subir” CPU y listo. Sin embargo, si el cuello está en disco, subir CPU no cambia nada. Por eso, dimensiona en función de carga:
Número de usuarios concurrentes reales (no los que “podrían” conectarse).
Tamaño de base de datos hoy y proyección de crecimiento.
Ventanas de procesos pesados (cierres, reportes, timbrado, conciliación).
Además, define márgenes: si hoy operas a 70–80% en horas pico, estás a una caída de distancia. En consecuencia, apunta a operar con holgura, especialmente en disco y RAM.
Almacenamiento: el origen silencioso de la mayoría de incidentes
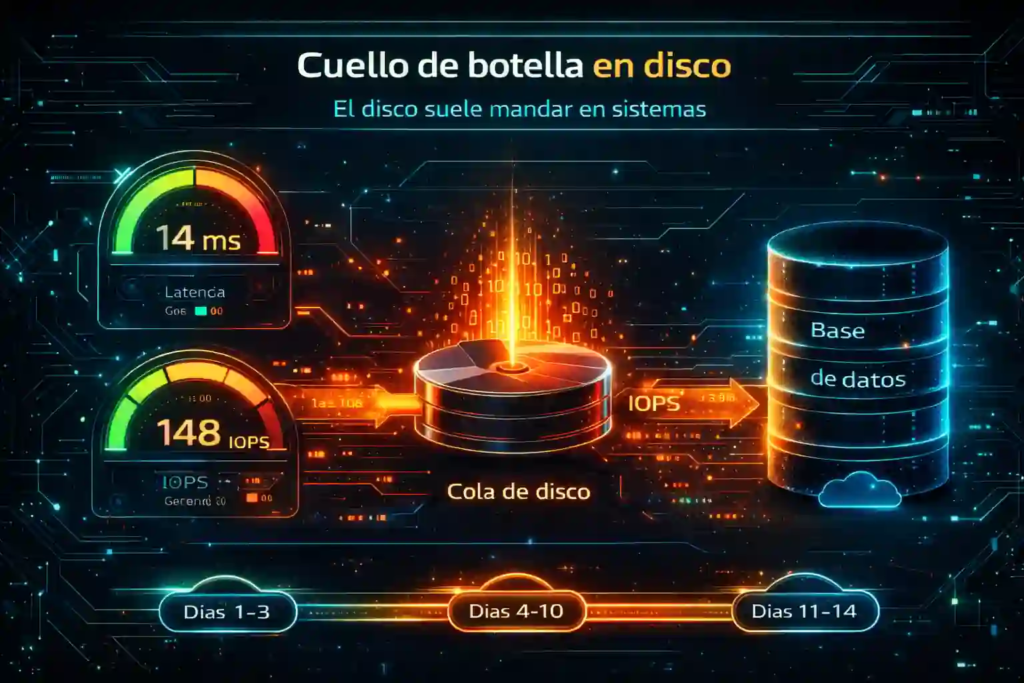
El disco suele mandar en sistemas
En sistemas administrativos, el disco manda más de lo que la gente cree. De hecho, un ERP puede “vivir” con CPU moderada, pero no con disco lento. Por lo tanto, revisa:
Tipo de almacenamiento (SSD, NVMe, premium, etc.).
IOPS garantizadas.
Latencia media y p95 (no solo “promedio”).
Separación de volúmenes (SO vs datos vs logs).
Estrategia de crecimiento (expandir sin apagar).
Cuando la base crece, la escritura de logs y la lectura de índices se vuelven constantes. En consecuencia, si tu almacenamiento no escala, la lentitud escala por ti.
Además, evita el error de “dejar 5–10% libre”. En servidores para sistemas, eso es receta para degradación. Mantén un margen razonable, y planifica expansiones con tiempo.
Red y acceso remoto: estabilidad también es rendimiento percibido
Aunque el servidor esté “bien”, una red inestable se siente como lentitud. Por eso, considera:
Rutas y saltos (traceroute) en horas pico.
Latencia desde sedes y home office.
Políticas de QoS si hay VPN o enlaces compartidos.
Configuración de RDP (compresión, recursos, límites de sesión).
Además, si tu operación depende de acceso remoto, la continuidad no se negocia: define redundancia, políticas de reconexión, y ventanas de mantenimiento visibles para usuarios. Así reduces tickets y estrés operativo.
Backups y continuidad: el seguro que se prueba antes del siniestro
Aquí mucha gente falla: tiene “respaldo”, pero no tiene recuperación. Por lo tanto, tu estándar mínimo debería incluir:
Backups automáticos con retención (diaria, semanal, mensual).
Copia fuera del servidor (offsite) y, si aplica, inmutable.
Pruebas de restauración calendarizadas (no “cuando se pueda”).
RPO/RTO definidos (cuánta pérdida toleras, cuánto tardas en volver).
Si quieres aterrizarlo con prácticas claras, revisa Respaldos de equipos de cómputo en la nube, porque ahí se entiende la diferencia entre “tener archivos” y “tener continuidad”.
En este punto conviene decirlo sin rodeos: caídas y lentitud en servidores cloud se vuelven crisis cuando además no hay un plan de recuperación. En consecuencia, aunque el incidente sea “pequeño”, el impacto se multiplica por el tiempo muerto.
Alta disponibilidad y mantenimiento: evitar que un solo punto te apague todo
No todos los sistemas requieren HA compleja, sin embargo, casi todos requieren mantenimiento real: parches, reinicios controlados, limpieza de logs, y revisión de servicios críticos. Por lo tanto:
Programa mantenimiento recurrente.
Automatiza alertas y reinicios de servicios cuando aplique.
Separa ambientes si puedes (producción vs pruebas).
Documenta cambios (bitácora) y valida rollback.
Además, si el sistema es crítico (facturación, inventarios, contabilidad), evalúa escenarios de redundancia gradual: desde snapshots y replicación, hasta clúster o failover según presupuesto y criticidad.
Plan práctico en 3 pasos para estabilizar en 7–14 días
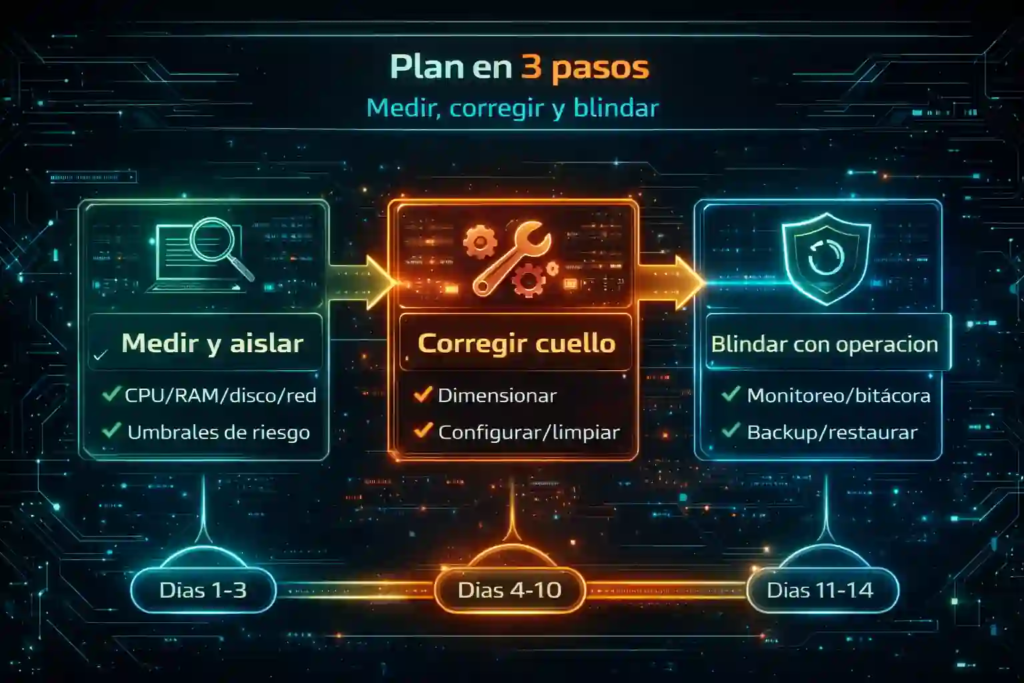
Medir, corregir y blindar
Para no quedarte en teoría, aplica este orden:
Paso 1: Medir y aislar (Días 1–3) Primero instala/activa métricas, define umbrales y detecta el cuello dominante (CPU/RAM/disco/red). Además, registra “hora y operación” cuando ocurre el problema; esa correlación ahorra días.
2: Corregir el cuello (Días 4–10) Luego corrige lo que manda: ajustar disco, ampliar RAM, revisar configuración de DB, limpiar jobs, o segmentar volúmenes. Sin embargo, cambia una cosa a la vez para saber qué arregló el problema.
Paso 3: Blindar con operación (Días 11–14) Finalmente deja instalado el sistema de prevención: alertas, backups verificados, mantenimiento calendarizado, y bitácora. En consecuencia, reduces incidentes repetidos y vuelves predecible el desempeño.
Aquí el objetivo no es “cero problemas”, sino control: que los riesgos sean visibles y gestionables.
Errores comunes que disparan incidentes (y cómo evitarlos)
Crecer sin revisar disco: tarde o temprano explota. Por lo tanto, monitorea IOPS y espacio libre con margen.
Backups sin prueba de restore: es como no tener backup. Además, agenda pruebas.
Cambiar proveedor por precio: si no revisas garantías de recursos, te compras variabilidad. En consecuencia, compara por SLA y soporte.
No documentar cambios: cuando algo falla, nadie sabe qué tocó. Por lo tanto, bitácora simple pero constante.
Y sí, esto conecta con el tema central: caídas y lentitud en servidores cloud casi siempre son consecuencia de decisiones acumuladas, no de una “mala suerte” puntual.
Si necesitas revisar tu caso con un enfoque técnico y orientado a continuidad, puedes contactar al equipo y pedir una recomendación basada en métricas (no suposiciones).
Checklist final para operar estable mes a mes
Antes de cerrar, deja estas prácticas como rutina:
Revisión semanal de logs críticos.
Revisión de crecimiento de base y volúmenes.
Pruebas mensuales de restauración.
Revisión trimestral de dimensionamiento vs crecimiento.
Actualizaciones en ventanas controladas, con rollback definido.
Si haces esto, el servidor deja de ser “un gasto que da problemas” y se vuelve una plataforma operable. Y, sobre todo, el equipo deja de vivir apagando incendios.
Para aterrizarlo: caídas y lentitud en servidores cloud se reducen cuando conviertes la infraestructura en un proceso: medir, corregir, y blindar. Por lo tanto, si hoy tu sistema ya muestra señales, actúa antes de que el incidente te obligue a hacerlo en modo urgencia.
Si estás listo para estabilizar y escalar con una base sólida, revisa alternativas de servidores virtuales cloud VPS y compáralas contra tu carga real.
Backup sin restore no protege
FAQ´s
1) ¿Cómo sé si la lentitud viene del servidor o del sistema? Si el consumo de CPU/RAM/disco sube al mismo tiempo que la operación se vuelve lenta, el origen suele ser infraestructura. Si las métricas están estables, revisa aplicación y base de datos.
2) ¿Qué métrica es la más importante para un ERP en nube? La latencia de disco y los IOPS suelen mandar. Después, RAM suficiente para evitar paginación y CPU para concurrencia.
3) ¿Cada cuánto debo revisar el rendimiento del servidor? Idealmente a diario con alertas automáticas y, además, con una revisión semanal breve de tendencias (crecimiento, picos, errores).
4) ¿Por qué un servidor “se siente lento” solo en ciertos horarios? Porque hay picos de usuarios, tareas programadas, respaldos o procesos de cierre. Por lo tanto, hay que correlacionar horario con métricas y eventos.
5) ¿Qué es RPO y RTO y por qué importan? RPO es cuánta información puedes perder; RTO es cuánto tardas en volver. En sistemas críticos, ambos deben definirse y probarse.
6) ¿Los backups automáticos garantizan recuperación? No necesariamente. Sin prueba de restauración, el backup puede fallar justo cuando más lo necesitas.
7) ¿Cuándo conviene migrar a un VPS Windows para sistemas administrativos? Cuando dependes de aplicaciones Windows, escritorio remoto estable, o compatibilidad con componentes específicos. Además, conviene cuando el soporte y el rendimiento deben ser predecibles.
8) ¿Cómo puedo reducir caídas y lentitud en servidores cloud sin sobredimensionar? Primero identifica el cuello con monitoreo, luego corrige el recurso dominante (disco/RAM/red), y finalmente implementa rutina de mantenimiento y continuidad.
9) ¿Qué ajustes simples suelen dar mejora inmediata? Liberar espacio en disco, revisar tareas programadas, optimizar antivirus, separar volúmenes, y ajustar memoria/paginación de forma correcta.
10) ¿Qué debo pedirle a un proveedor para operar con estabilidad? Recursos garantizados, especificación de almacenamiento e IOPS, soporte con tiempos claros, y herramientas de monitoreo/backup verificables.
Si tu servidor actual poniendo en riesgo tu ERP ya se siente “más lento de lo normal”, no lo trates como una molestia menor: casi siempre es una señal de saturación, mala configuración o falta de continuidad. Además, cuando el ERP se vuelve intermitente, el costo real aparece en retrasos, captura doble, inventarios descuadrados y facturación detenida. Por lo tanto, antes de “aguantar” otra temporada, conviene identificar síntomas medibles y actuar con un plan.
A continuación, verás señales técnicas y operativas que, en conjunto, indican que tu infraestructura ya está al límite. Asimismo, incluyo qué revisar primero, qué evidencia pedirle a tu proveedor y qué acciones suelen estabilizar el sistema sin improvisar. Mientras tanto, si quieres una referencia de costos y alcances para comparar, puedes apoyarte en esta guía sobre cuánto cuesta realmente un servidor para ERP en México, porque te ayuda a separar “precio mensual” de “servicio operable”.
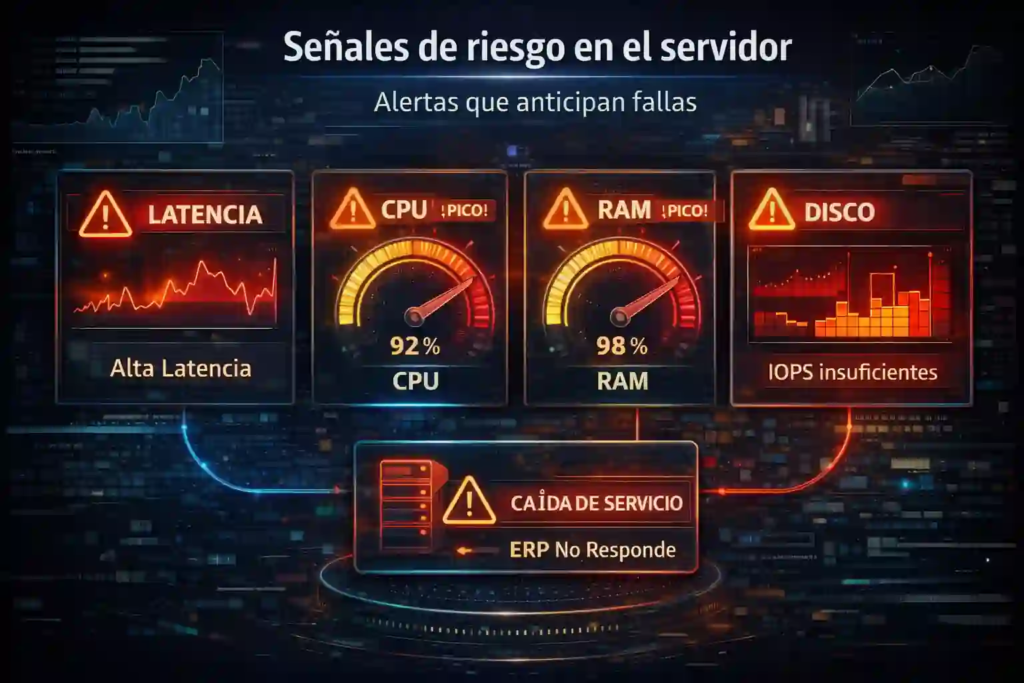
Alertas que anticipan fallas
servidor actual poniendo en riesgo tu ERP: tiempos de respuesta variables y “microcortes”
Cuando los usuarios describen el ERP como “se tarda en guardar” o “se congela y luego regresa”, normalmente hay latencia acumulada. En primer lugar, revisa si el problema coincide con horas pico; después, identifica si hay operaciones específicas que disparan el retraso (guardar pólizas, timbrar, actualizar existencias). Además, confirma si el sistema “se recupera” solo, porque eso suele apuntar a saturación temporal, no a un fallo total.
Por otro lado, si los microcortes se presentan en accesos remotos (RDP, VPN o escritorio virtual), entonces la causa puede ser red, pero también CPU o disco. Por esta razón, exige métricas: latencia de disco, tiempos de consulta, colas y errores. Incluso, si tu proveedor no entrega reportes, ya tienes una señal de riesgo: no puedes controlar lo que no se mide.
servidor actual poniendo en riesgo tu ERP: picos de CPU sostenidos y colas de procesos
Si la CPU llega a 90–100% por periodos largos, el ERP empieza a “pelear” por ciclos de procesamiento. Sin embargo, no todos los picos significan que necesitas más vCPU; a veces el problema es un proceso mal programado (reportes, cierres, tareas automáticas) o una base de datos sin mantenimiento. Por lo tanto, lo correcto es correlacionar picos con eventos: hora, usuario, operación y módulo.
Además, revisa si hay “colas” visibles: tareas que se quedan esperando, servicios que reinician, o sesiones que se multiplican. Asimismo, si el servidor comparte recursos con otras cargas, la CPU puede verse afectada por falta de aislamiento o por límites del plan. En consecuencia, antes de comprar “más por comprar”, exige evidencia y define un umbral claro de escalamiento.
Si necesitas una plataforma que permita crecer por etapas y con recursos ajustables, revisa opciones de servidores virtuales cloud VPS para comparar escalamiento, rendimiento y soporte.
servidor actual poniendo en riesgo tu ERP: RAM al límite, swapping y reinicios “misteriosos”
Cuando el rendimiento se vuelve variable
Cuando falta RAM, el sistema operativo compensa usando disco como memoria (swapping). Aun así, ese “arreglo” suele ser el origen de la lentitud más desesperante, porque multiplica la latencia y bloquea operaciones. Por consiguiente, si notas que el servidor “respira” y luego se vuelve pesado, revisa uso de RAM, memoria caché y consumo por procesos.
Además, en ambientes Windows con múltiples sesiones, la RAM se vuelve un cuello frecuente, sobre todo cuando hay escritorios remotos y aplicaciones paralelas. Por lo tanto, si tu ERP depende de Windows, necesitas una configuración pensada para esa realidad, no un servidor “genérico”.
Si tu operación usa Windows Server y acceso remoto intensivo, solicita una referencia técnica de servidores VPS Windows para sistemas administrativos y compárala con tus métricas actuales (sesiones, RAM por usuario, latencia y reinicios).
servidor actual poniendo en riesgo tu ERP: disco lento, IOPS insuficientes y latencia creciente
En ERPs, el disco no se evalúa por “cuántos GB tengo”, sino por “qué tan rápido responde”. De hecho, puedes tener espacio de sobra y aun así sufrir lentitud por IOPS bajos o por almacenamiento compartido sin garantías. Por esta razón, pide datos concretos: tipo de almacenamiento (SSD/NVMe), límites de I/O, latencia promedio y picos.
Además, observa señales indirectas: respaldos que tardan más cada mes, reportes que se vuelven eternos y tiempos de arranque que empeoran. Asimismo, revisa si la base de datos creció sin mantenimiento (índices, logs, tablas temporales). En consecuencia, antes de escalar CPU, valida si el problema real es I/O; de lo contrario, solo encarecerás el plan sin resolver la causa.
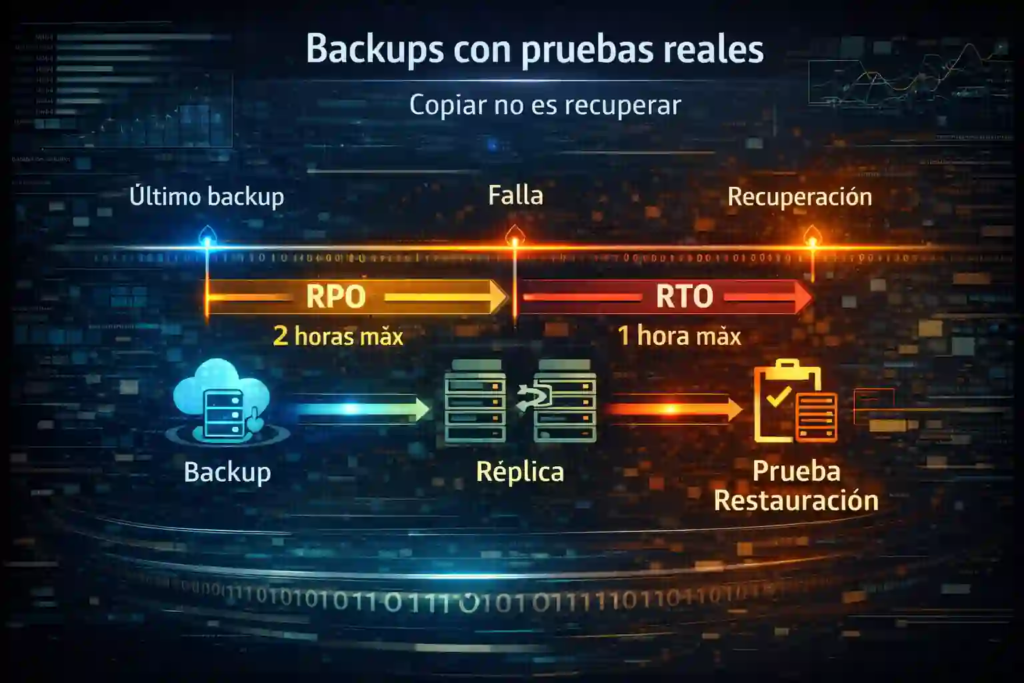
servidor actual poniendo en riesgo tu ERP: respaldos que existen, pero no restauran
Copiar no es recuperar
Tener “backups” no significa poder recuperar. Sin embargo, muchos negocios se enteran tarde: cuando falla el servidor, descubren que el respaldo era incompleto, corrupto o inaccesible. Por lo tanto, una señal crítica de riesgo es no tener evidencia de restauraciones probadas.
Además, verifica frecuencia, retención y ubicación de copias. Igualmente, confirma si existe copia fuera del servidor (y, mejor aún, fuera del proveedor). Para aterrizar esto sin rodeos, revisa esta guía de respaldos de equipos de cómputo en la nube, porque te ayuda a traducir “tengo backup” en RPO/RTO y procedimientos reales.
Qué pedir como prueba mínima de continuidad
En primer lugar, un reporte de la última restauración completa. Después, un checklist de verificación (servicios arriba, base de datos consistente, usuarios validando). Asimismo, un registro de tiempos: cuánto tardó en restaurar y qué quedó fuera. En consecuencia, si tu proveedor no puede darte esa evidencia, entonces tu ERP ya está expuesto aunque “todo se vea bien hoy”.
servidor actual poniendo en riesgo tu ERP: seguridad débil, parches atrasados y accesos sin control
La continuidad también se pierde por incidentes de seguridad. Por ejemplo, un ransomware puede tumbar el ERP incluso si el hardware está “sobrado”. Por lo tanto, otra señal de riesgo es no saber cuándo fue el último parche del sistema operativo, de la base de datos y de los servicios expuestos.
Además, revisa controles básicos: MFA, contraseñas fuertes, bloqueo por intentos, firewall bien configurado y acceso remoto restringido. Asimismo, valida si hay segmentación: el ERP no debería estar expuesto directamente a internet sin protección. En consecuencia, si no existe una política clara de actualizaciones y hardening, el riesgo operativo sube semana a semana.
servidor actual poniendo en riesgo tu ERP: acceso remoto inestable y sesiones que se desconectan
Cuando el ERP se usa por acceso remoto, la experiencia depende de red, configuración y capacidad. Sin embargo, desconexiones frecuentes, pantallas congeladas o sesiones “fantasma” suelen indicar saturación o problemas de transporte. Por lo tanto, revisa si el proveedor monitorea latencia, pérdida de paquetes y uso de canales.
Además, valida cuántas sesiones concurrentes soporta tu esquema y si hay límites de licenciamiento o de recursos. Asimismo, define si tu acceso remoto requiere VPN o si estás usando RDP expuesto, lo cual incrementa riesgo de ataques. En consecuencia, un ajuste de arquitectura puede estabilizar más que “reiniciar y rezar”.
servidor actual poniendo en riesgo tu ERP: soporte reactivo, sin monitoreo ni bitácora
Si solo te enteras del problema cuando un usuario se queja, entonces no hay monitoreo efectivo. Además, si cada incidente se resuelve “a ojo” sin bitácora, la probabilidad de repetición es alta. Por lo tanto, otra señal clara es no contar con alertas proactivas (CPU/RAM/disco, errores, caídas de servicios) ni con reportes mensuales.
Asimismo, exige un proceso de escalamiento: quién atiende, en cuánto tiempo, y cómo se documenta. Para preparar un comparativo serio, apóyate en esta lista de qué preguntar antes de contratar servidor ERP, ya que convierte la conversación en requisitos medibles.
Si ya tienes síntomas y necesitas un diagnóstico con métricas (no opiniones), puedes contactar con agencia Cobalt Blue Web y pedir una ruta de mejora por etapas con evidencia y prioridades.
Qué hacer en los próximos 7 días para reducir riesgo sin detener la operación
Primero, levanta una línea base: CPU, RAM, disco, latencia e IOPS, además de incidentes y horas pico. Después, identifica el “top 3” de operaciones que más fallan (timbrado, reportes, cierres). Asimismo, revisa el estado del respaldo: última ejecución, última restauración y ubicación de copias. Mientras tanto, documenta accesos remotos, usuarios concurrentes y permisos.
Luego, ordena acciones por impacto: (1) estabilizar disco/IOPS y base de datos, (2) ajustar memoria y servicios, (3) mejorar seguridad y accesos, (4) formalizar monitoreo y soporte, y (5) planear escalamiento o migración. Aunque suene obvio, lo que salva proyectos es el orden. Por consiguiente, evita migrar “en caliente” sin respaldo probado y sin ventana definida.
Cuándo conviene escalar y cuándo conviene migrar
Escalar conviene cuando el proveedor puede aumentar recursos sin tocar arquitectura y cuando la causa está clara (RAM corta, IOPS limitados, CPU insuficiente). Sin embargo, migrar conviene cuando hay límites estructurales: almacenamiento compartido sin garantías, soporte inconsistente, o prácticas débiles de seguridad y continuidad.
Además, si tu operación crece por temporadas, entonces prioriza un esquema que permita subir recursos por etapas y sin paros; en cambio, si dependes de escritorio remoto intensivo o de componentes específicos del ERP, valida compatibilidades y licencias antes de cambiar. En consecuencia, la decisión correcta no es “escalar o migrar”, sino reducir riesgo con un camino que puedas ejecutar y documentar.
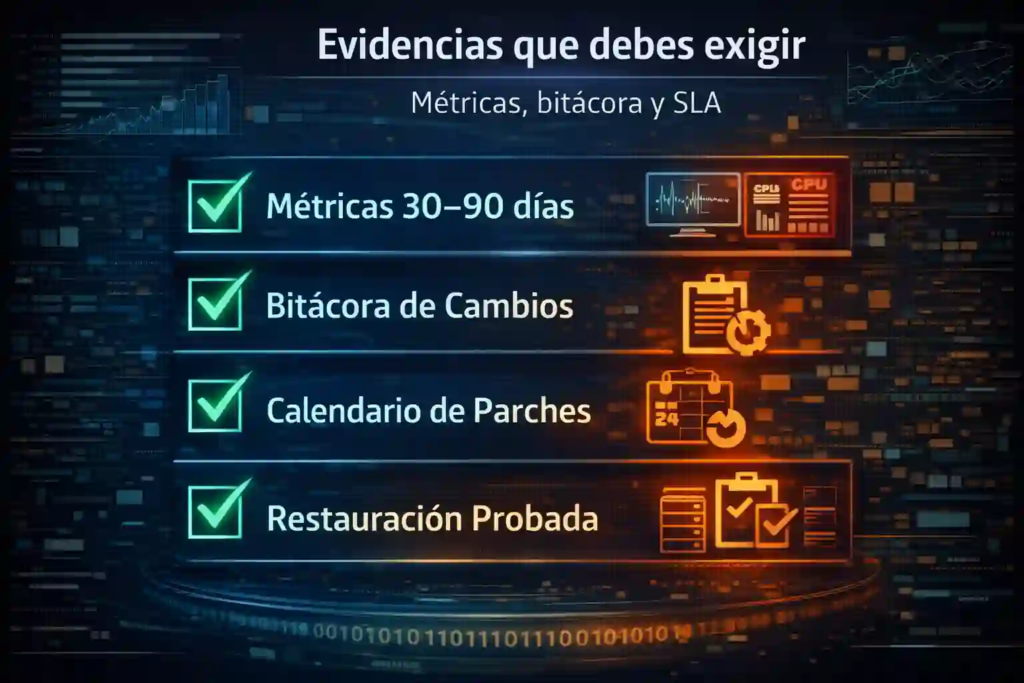
Checklist de evidencias que debes exigir a tu proveedor
Métricas, bitácora y SLA
En primer lugar, métricas históricas (30–90 días) de CPU, RAM, disco y red. Después, evidencia de respaldo y restauración. Asimismo, bitácora de cambios y calendario de parches. Además, reporte de incidentes y tiempos de respuesta. Finalmente, claridad contractual sobre alcance: qué incluye y qué se cobra aparte.
Si el proveedor no puede entregar evidencia, entonces tu decisión es sencilla: no estás comprando operación, estás comprando esperanza. Por lo tanto, documenta requisitos, exige pruebas y compara con variables equivalentes.
Recomendación de planeación: define una ruta por etapas
Si quieres convertir señales en un plan ejecutable, entonces pide una propuesta por fases: estabilización, hardening, continuidad y escalamiento. Además, solicita que cada fase incluya objetivos medibles, supuestos, riesgos y un calendario realista, de modo que puedas avanzar sin detener la operación y sin depender de improvisación.
FAQs: señales y acciones para proteger tu ERP
¿Cómo sé si la lentitud viene del servidor o del ERP? En primer lugar, correlaciona horas pico con métricas (CPU/RAM/disco). Después, identifica operaciones específicas que detonan el problema. Si hay latencia de disco alta, suele ser infraestructura; si hay consultas lentas puntuales, puede ser base de datos o configuración.
¿Qué indicador es más decisivo en un ERP: CPU o IOPS? A menudo, IOPS y latencia de disco definen la “sensación” de rapidez. Sin embargo, con muchos usuarios concurrentes, la CPU también pesa. Por lo tanto, mide ambos y decide por evidencia.
¿Cada cuánto debo probar una restauración completa? Como mínimo, de forma mensual o después de cambios relevantes. Además, prueba escenarios parciales (archivo, base, máquina) para validar tiempos y consistencia.
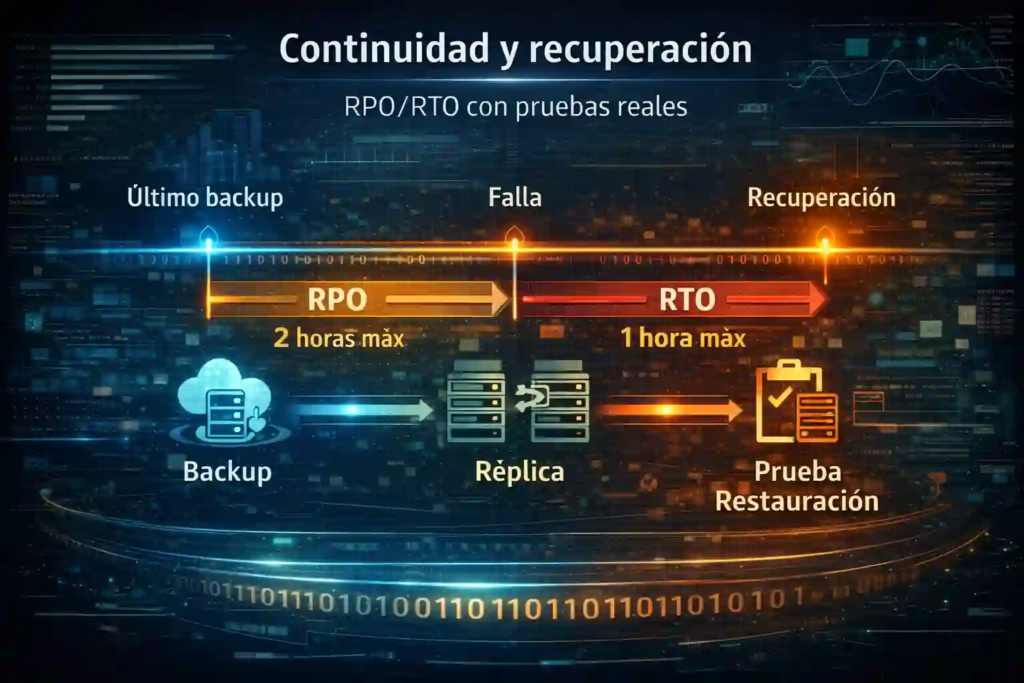
¿Qué es RPO y por qué importa si “tengo respaldo diario”? RPO es la pérdida de datos tolerable. Si tu RPO es de 2 horas, un respaldo diario no alcanza. En consecuencia, el esquema debe ajustarse al riesgo del negocio.
¿Qué señales apuntan a falta de RAM? Swapping, lentitud progresiva, servicios que reinician y sesiones que se caen. Asimismo, en Windows con RDP, el consumo por usuario puede dispararse.
¿Qué preguntas clave debo hacerle a un proveedor antes de migrar? Pregunta por límites de I/O, tipo de disco, monitoreo, respaldo con restauración, SLA y proceso de escalamiento. Además, exige evidencia, no solo promesas.
¿Qué prácticas reducen riesgo sin aumentar mucho el costo? Monitoreo con alertas, parches regulares, MFA, backups con pruebas y un plan de recuperación documentado. Por lo tanto, muchas mejoras son de proceso, no de “comprar más”.
¿Cuándo es peligroso exponer RDP directo a internet? Siempre que no haya VPN, MFA y reglas estrictas. En consecuencia, es preferible acceso remoto protegido y segmentado.
¿Qué hago si mi proveedor responde lento y el ERP es crítico? Documenta incidentes, solicita métricas, prepara plan de contingencia y evalúa migración con ventana y respaldo probado. Además, busca un diagnóstico externo para priorizar.
¿Cómo convierto estas señales en un plan concreto en menos de una semana? Primero, mide y documenta. Después, asegura respaldo y restauración. Luego, corrige cuellos obvios (disco/RAM). Finalmente, define escalamiento o migración con alcance y SLA.
Si no quieres que el siguiente incidente te obligue a migrar a la fuerza, entonces agenda una revisión y cierra brechas con un plan y un responsable: puedes contactar con agencia Cobalt Blue Web para solicitar una ruta de estabilización y continuidad con métricas, calendario y prioridades.
Arrancar un proyecto de ERP no se trata solo de “rentar un servidor”; se trata de asegurar rendimiento, continuidad y soporte. Cuánto cuesta realmente un servidor para ERP en México depende, por lo tanto, de cómo uses el sistema (usuarios concurrentes, módulos, base de datos, archivos), de qué tan estrictos sean tus tiempos de respuesta y, además, de si necesitas Windows, alta disponibilidad o respaldos verificados.
Qué pagas cuando contratas un servidor para ERP y qué suele quedar fuera del alcance
Aunque a primera vista veas un precio mensual, en la práctica pagas un paquete de recursos y de responsabilidades. Primero, pagas cómputo (CPU), memoria (RAM) y almacenamiento (SSD/NVMe). Después, pagas capacidad de I/O (IOPS), que es lo que vuelve “ágil” o “lento” al ERP cuando hay consultas y escrituras constantes. Asimismo, pagas red (ancho de banda y calidad de ruta), y, si aplica, direcciones IP y firewall.
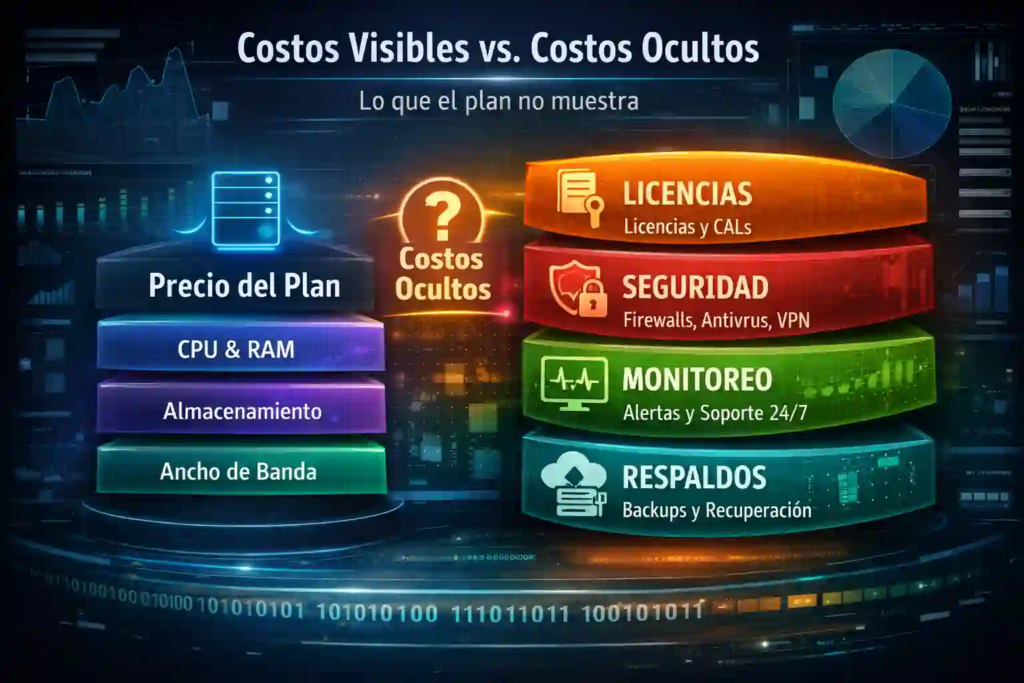
Sin embargo, lo que suele cambiar por completo el costo es lo que no se ve en la ficha: administración del sistema, monitoreo, parches, hardening, políticas de acceso, y, sobre todo, una estrategia de continuidad que se pueda probar. De hecho, si tu proveedor no se compromete con un SLA claro, entonces el precio “barato” suele salir caro cuando aparece el primer incidente.
Rangos de costo por tipo de infraestructura para un servidor ERP
Lo que el plan no muestra
No existe un número único porque el “servidor” puede significar varias arquitecturas. Aun así, sí existen rangos y patrones.
VPS cloud administrado para ERP: el punto de entrada más común
Para la mayoría de pymes, un VPS cloud administrado funciona bien como base, siempre que se dimensione con criterio. Por ejemplo, un VPS con 2–4 vCPU y 8–16 GB de RAM puede cubrir operación ligera o moderada si la base de datos está bien configurada y si el disco es rápido. Además, en muchos casos se puede crecer por pasos, lo cual reduce el riesgo de pagar de más desde el día uno.
Si quieres evaluar opciones de infraestructura flexible, conviene revisar alternativas de servidores virtuales cloud VPS que permitan escalar CPU, RAM y almacenamiento sin migraciones traumáticas.
VPS Windows para sistemas ERP contables y administrativos
Cuando el ERP depende de componentes Windows (por ejemplo, por compatibilidad con ciertos sistemas contables, conectores o clientes remotos), entonces el costo no solo es infraestructura. En ese caso, también influyen licencias, parches, y una operación más estricta en seguridad. Por lo tanto, suele ser más sensible al soporte técnico y a la disciplina de actualizaciones.
Servidor dedicado o bare metal para ERP: rendimiento constante, mayor compromiso
Cuando el ERP crece, y especialmente cuando hay más concurrencia, reportes pesados o integración con múltiples sucursales, un dedicado se vuelve atractivo. A cambio, la inversión suele ser superior y, además, necesitas definir con precisión respaldo, redundancia y monitoreo. Aunque ofrece rendimiento predecible, también te “amarra” más a un dimensionamiento inicial, a menos que tengas un plan de renovación o expansión.
Nube privada o alta disponibilidad para ERP: continuidad estricta
Si el ERP es crítico (ventas, facturación, inventarios, producción), entonces, tarde o temprano, se habla de alta disponibilidad, replicación o al menos de una arquitectura con puntos únicos de falla minimizados. En consecuencia, el precio deja de ser “un servidor” y se convierte en “un servicio” con más capas: balanceo, replicación, almacenamiento redundante y pruebas de recuperación.
Costos ocultos que elevan el presupuesto real de un ERP
El gasto real casi nunca se limita al “plan mensual”. Por esta razón, conviene revisar los componentes que suelen aparecer después:
Respaldos útiles, no solo copias: backups automáticos sin prueba de restauración son una ilusión operativa. Además, necesitas política 3-2-1 (y, si se puede, copia inmutable).
Soporte y escalamiento: no es lo mismo “soporte por ticket” que una mesa con tiempos de respuesta y escalamiento.
Seguridad: MFA, VPN, segmentación, WAF (si hay web), y control de accesos.
Monitoreo: métricas de CPU/RAM, disco, latencia, errores, además de alertas accionables.
Mantenimiento: parches del sistema, actualizaciones de base de datos y tareas de housekeeping.
Licencias: Windows, CALs/RDS, base de datos, antivirus/EDR, y, a veces, licencias del propio ERP por servidor.
Cuánto cuesta realmente un servidor para ERP en México se entiende mejor cuando haces este desglose y separas “infraestructura” de “operación”. En otras palabras, el servidor no es el costo; el costo es el servicio completo que mantiene el ERP disponible y rápido.
Cómo dimensionar CPU, RAM y disco para un servidor ERP sin comprar de más
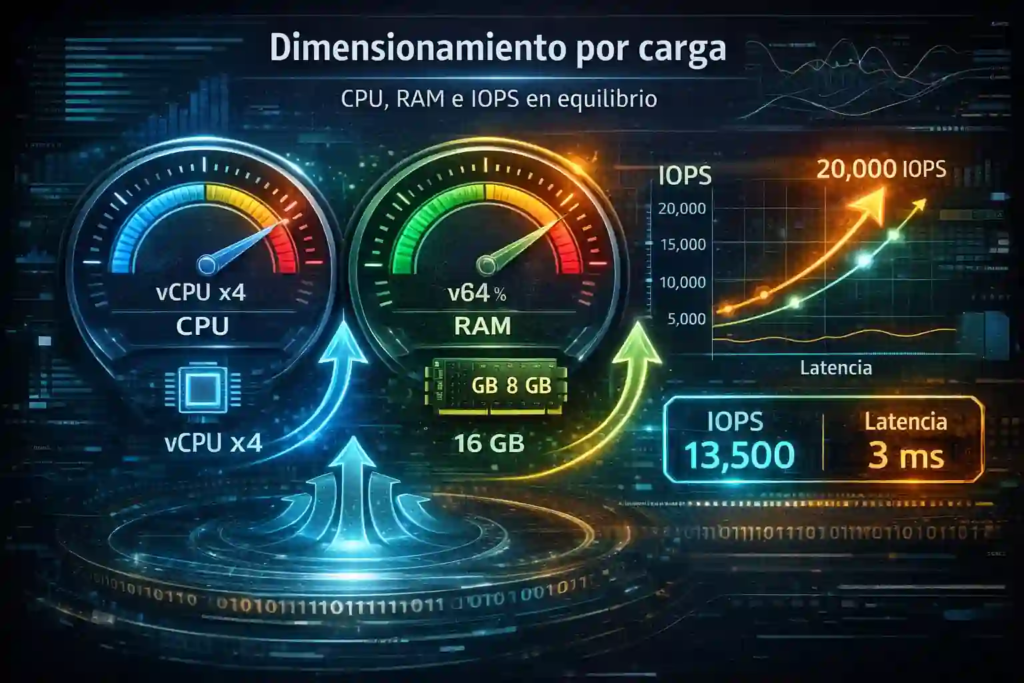
Lo que el plan no muestra CPU, RAM e IOPS en equilibrio
Dimensionar no es adivinar; es medir y proyectar. Primero, define cuántos usuarios trabajan al mismo tiempo y qué módulos usan. Después, identifica el tamaño de base de datos, el crecimiento mensual y el volumen de documentos adjuntos. Asimismo, determina tus “horas pico” y si los reportes se ejecutan en horario laboral.
CPU: más núcleos no siempre es la solución
En ERPs típicos, el cuello de botella puede ser el disco o la base de datos, no la CPU. Aun así, si hay concurrencia real, entonces sí necesitas vCPU suficientes. Por lo tanto, una regla práctica es crecer por escalones: subir vCPU cuando existan señales claras (colas, tiempos de consulta, saturación persistente), no por intuición.
RAM: estabilidad para base de datos y cachés
La RAM impacta en cachés, buffers y en la capacidad de sostener múltiples sesiones. Además, reduce el “swapping”, que es una de las causas más comunes de lentitud. En consecuencia, si el ERP es de base de datos intensiva, la RAM suele dar mejor retorno que agregar vCPU.
Disco e IOPS: aquí se decide la “sensación” de rapidez del ERP
El almacenamiento rápido (SSD/NVMe) y, sobre todo, IOPS suficientes determinan el desempeño en escrituras y lecturas pequeñas, típicas en ERPs. Por esta razón, pregunta siempre por tipo de disco, rendimiento y si hay límites de I/O. Si el proveedor no lo aclara, entonces el riesgo sube.
Cuánto cuesta realmente un servidor para ERP en México sube cuando necesitas disco rápido sostenido, porque no es solo capacidad (GB), sino rendimiento (IOPS/latencia).
Respaldos, RPO/RTO y pruebas: el costo de poder recuperar un ERP
RPO/RTO con pruebas reales
Una estrategia de continuidad no se compra con un check. Primero, define tu RPO (cuánta pérdida de datos toleras) y tu RTO (cuánto tiempo puedes estar fuera). Después, adapta el esquema de backups: horarios, retención, copia externa, y pruebas periódicas.
En ese punto, lo más sensato es apoyarte en una guía de respaldo realista, como la de respaldos de equipos de cómputo en la nube, porque, además, te ayuda a aterrizar la diferencia entre “backup configurado” y “restauración probada”.
Cuánto cuesta realmente un servidor para ERP en México también incluye, por lo tanto, el costo de restaurar: tiempo del equipo, ventanas de prueba, y procedimientos documentados.
Licencias y componentes que cambian el número final del servidor ERP
Aquí es donde muchos presupuestos se rompen. Si tu ERP corre en Linux y usa una base de datos incluida (o de licencia libre), entonces el costo se concentra en infraestructura y soporte. Sin embargo, si necesitas Windows Server, RDS para acceso remoto, o una base de datos comercial, el gasto mensual puede aumentar de forma notoria.
Además, considera:
Antivirus/EDR con consola central.
Herramientas de respaldo con versionado e inmutabilidad.
VPN empresarial o SD-WAN si hay múltiples sedes.
Certificados, dominio y correo si el ERP se integra con notificaciones.
Cuánto cuesta realmente un servidor para ERP en México se vuelve más predecible cuando separas “licencias obligatorias” de “mejoras recomendadas” y decides por fases.
Soporte, SLA y administración para ERP: por qué el “administrado” vale (o no vale)
Un servidor “sin administración” puede ser viable si tienes equipo interno con tiempo y habilidades. Aun así, en muchos negocios el costo real es el tiempo de TI y el riesgo. Por lo tanto, si tu operación depende del ERP, el soporte administrado suele pagar su propio costo cuando evita paros o acelera la recuperación.
A continuación, verifica que el proveedor incluya:
Ventanas de mantenimiento y avisos.
Monitoreo proactivo y alertas.
Respuesta ante incidentes y escalamiento.
Bitácora de cambios.
Recomendaciones de capacity planning.
Si quieres aterrizar preguntas concretas para comparar proveedores, apóyate en esta guía de qué preguntar antes de contratar servidor ERP, ya que te permite convertir “promesas” en compromisos medibles.
Cuánto cuesta realmente un servidor para ERP en México suele bajar, indirectamente, cuando el soporte evita decisiones reactivas y compras urgentes.
Escenarios típicos de carga y cómo se reflejan en el costo del servidor ERP
No todos los ERPs se comportan igual, pero estos escenarios te ayudan a estimar.
Escenario A: operación ligera (pocos usuarios, una sede)
Si tienes pocos usuarios y un catálogo pequeño, normalmente basta con un VPS bien configurado. Además, si programan reportes fuera de hora pico y si mantienen disciplina de limpieza de base de datos, el desempeño se mantiene estable.
Escenario B: operación media (más usuarios, inventarios y facturación)
Aquí suele requerirse más RAM, disco rápido y monitoreo serio. Por lo tanto, el salto de costo ocurre por IOPS, por respaldo con retención y por soporte con respuesta garantizada.
Escenario C: operación crítica (varias sedes, integraciones, alta demanda)
En este caso, la prioridad es continuidad. En consecuencia, se justifica redundancia, replicación y pruebas de recuperación. Además, el monitoreo deja de ser opcional y se vuelve parte del control operativo.
Cuánto cuesta realmente un servidor para ERP en México, en la práctica, se define por el escenario que más se parece a tu día a día, no por el “plan” que aparece en la web.
Si necesitas una evaluación rápida para elegir arquitectura y evitar sobredimensionar, puedes solicitar un diagnóstico y comparativa en contactar con agencia Cobalt Blue Web, especialmente si tu ERP ya muestra lentitud o si planeas migración.
Cómo comparar cotizaciones de servidor ERP sin caer en trampas
Para comparar de forma justa, alinea las variables. Primero, exige que todas las cotizaciones incluyan CPU, RAM, disco, tipo de almacenamiento, límites de I/O, transferencia, IPs y SLA. Después, confirma si el precio incluye administración, monitoreo y backups. Asimismo, valida si hay costos por incidentes, reinstalaciones o “trabajos fuera de alcance”.
Además, pide evidencia: reportes de monitoreo, ejemplos de bitácoras, y plantillas de procedimiento de recuperación. Si el proveedor no tiene procesos, entonces la operación dependerá de “quién esté disponible”, lo cual es un riesgo.
Señales de que tu servidor ERP ya quedó corto y te está costando productividad
A veces el “costo” no está en la factura, sino en productividad perdida. Por ejemplo:
Los reportes tardan cada vez más.
Hay bloqueos en base de datos en horario pico.
El ERP se “congela” cuando se adjuntan archivos.
El acceso remoto se vuelve inestable.
Los respaldos tardan tanto que invaden horario laboral.
En ese caso, conviene ajustar primero lo medible (I/O, RAM, configuración de base de datos) y, solo después, escalar CPU o migrar. Además, antes de mover cualquier cosa, documenta tu ventana de cambio, tus dependencias y tu plan de reversión.
Cuánto cuesta realmente un servidor para ERP en México se controla mejor cuando reaccionas con métricas y no con urgencias.
Decisión final: cómo pagar lo justo y reducir riesgo al contratar servidor ERP
Capas, seguridad y monitoreo
Si tu objetivo es pagar lo justo, entonces compra por capas: infraestructura correcta, continuidad mínima viable y soporte adecuado. Después, incrementa según crecimiento y criticidad. Asimismo, evita decisiones basadas solo en “más barato”, porque el ERP es un servicio operativo: si se cae, la empresa se detiene.
Cuánto cuesta realmente un servidor para ERP en México se vuelve manejable cuando conviertes la compra en un proceso: dimensionas, documentas, pruebas y ajustas por crecimiento.
Finalmente, si quieres que un equipo revise tu escenario, detecte cuellos de botella y te deje un plan de capacidad y continuidad listo para operar, el siguiente paso práctico es contactar con agencia Cobalt Blue Web y pedir una recomendación basada en métricas, no en suposiciones.
FAQ SEO/IA: preguntas frecuentes sobre costos de servidor ERP
¿Por qué dos proveedores dan precios tan distintos para “lo mismo”? Porque, además de recursos, cambia el nivel de administración, el tipo de disco, los límites de I/O, el SLA y la estrategia de respaldo. Por lo tanto, sin comparar esas variables, el precio aislado no significa mucho.
¿Qué pesa más en rendimiento: CPU o disco? En muchos ERPs, el disco y la latencia de I/O definen la experiencia. Aun así, con alta concurrencia la CPU también pesa. En consecuencia, conviene medir y ajustar en orden.
¿Un VPS siempre es suficiente para un ERP? Para operación ligera o media, muchas veces sí. Sin embargo, cuando crece la carga o la criticidad, puede convenir dedicado o alta disponibilidad.
¿Qué debo pedir sobre respaldos para no quedarme solo con “copias”? Pide retención, copia externa, frecuencia, cifrado y, además, evidencia de pruebas de restauración. Sin eso, el respaldo no es operativo.
¿Windows incrementa mucho el costo? Puede incrementarlo porque entran licencias, actualizaciones y requerimientos de seguridad más estrictos. Por esta razón, dimensiona considerando licencias desde el inicio.
¿Cómo calculo RPO y RTO de manera práctica? Define cuántas horas de operación puedes perder y cuánto tiempo toleras estar fuera. Después, alinea backups y procedimientos de recuperación a esos límites.
¿Qué significa “administrado” en un servidor para ERP? Generalmente implica parches, monitoreo, hardening, respuesta a incidentes y soporte. No obstante, cada proveedor lo define distinto, así que pide alcance por escrito.
¿Cuándo conviene alta disponibilidad? Cuando el costo de parada supera, de forma clara, el costo adicional de redundancia. Además, si hay múltiples sedes y procesos críticos, suele justificarse.
¿Qué métrica debo vigilar para anticipar crecimiento? Además de CPU y RAM, vigila IOPS, latencia de disco, tiempo de consulta y colas de base de datos. En consecuencia, podrás escalar antes de que haya crisis.
¿Cómo preparo una migración sin riesgo? Primero, haz inventario, ventana de cambio y plan de reversión. Después, valida respaldo y restauración en un entorno de prueba. Finalmente, ejecuta con monitoreo y bitácora.
Respaldar una computadora en la nube sirve si puedes recuperar los archivos correctos, de una fecha útil, en un equipo desde el que sea posible volver a trabajar. Que una carpeta esté sincronizada o una tarea aparezca en verde no demuestra las tres cosas.
Esta guía es para quien administra laptops y computadoras de oficina, incluidas las que salen de la empresa. Te ayudará a decidir qué copiar, cómo detectar equipos desprotegidos y qué exigir en una restauración. No hace falta comprar un VPS para resolver todos los respaldos: empieza por el dato y el escenario de pérdida, no por el servidor.
La decisión rápida
Solo necesitas recuperar documentos: evalúa copia por archivos con versiones, retención y cobertura comprobadas.
Necesitas reconstruir el puesto: añade reinstalación documentada o respaldo de imagen compatible, aplicaciones y acceso seguro. Copiar documentos no reconstruye el equipo.
El trabajo ya vive en un servicio en línea: verifica su recuperación y qué queda fuera. No confundas un acceso directo local con una copia del dato remoto.
Antes de contratar, elige un archivo importante fuera de la carpeta habitual y comprueba si aparece en una copia recuperable. Esa prueba suele revelar más que una lista de funciones.
Backup, sincronización y versionado: tres funciones distintas
Sincronizar mantiene cambios entre ubicaciones. Es útil para colaborar, pero también puede propagar un borrado o una modificación equivocada. Versionar conserva estados anteriores dentro de una ventana o política. Respaldar mantiene una copia recuperable bajo un procedimiento de conservación y restauración. Una solución puede combinar funciones; lo decisivo es qué sucede cuando pierdes el original y su acceso.
El versionado no equivale a inmutabilidad. Una versión que el mismo administrador puede borrar no tiene la misma protección que una copia cuya eliminación está bloqueada durante una retención comprobada. Tampoco basta con cifrar: el cifrado protege confidencialidad, no demuestra que el archivo se copió ni que puedas abrirlo después.
Qué pregunta responde cada mecanismo
Mecanismo
Te ayuda a resolver
Debes comprobar aparte
Sincronización
Continuar en otro dispositivo y compartir trabajo.
Carpetas incluidas, cambios propagados y archivos pendientes.
Historial de versiones
Volver a un estado anterior disponible.
Antigüedad, límites, eliminación y acceso si se pierde la cuenta.
Backup de archivos
Recuperar contenido incluido en una copia.
Exclusiones, archivos abiertos, retención y restauración real.
Imagen o reconstrucción del puesto
Recuperar un entorno de trabajo, según su diseño.
Hardware, arranque, aplicaciones, licencias y autenticación.
Tres referencias que muestran por qué no basta una etiqueta
No son productos equivalentes ni una clasificación de ganadores. Estas documentaciones permiten contrastar tres necesidades diferentes:
Microsoft: recuperación de archivos en OneDrive. Documenta papelera y recuperación, con condiciones distintas según cuenta y función. La restauración completa para suscriptores Microsoft 365 cubre cambios dentro de los últimos 30 días. Es una ayuda real para los archivos incluidos; no acredita la protección de una carpeta local que nunca se sincronizó.
Backblaze Computer Backup: datos admitidos y exclusiones. Detalla exclusiones de sistema, aplicaciones, unidades de red y archivos bloqueados. Sirve para evaluar una copia de archivos de un equipo, no para asumir que existe una imagen arrancable de toda la computadora. Revisa la configuración y versión concretas, no solo el nombre comercial.
Apple: respaldo con Time Machine. Explica el uso de almacenamiento externo y la recuperación en un Mac. Es una alternativa local útil, pero un disco guardado junto al portátil no resuelve por sí mismo la pérdida de ambos. Una copia local y otra fuera de la oficina pueden complementarse.
Documentación consultada el 23 de octubre de 2026. Confirma compatibilidad y condiciones vigentes antes de elegir; ninguna de estas referencias constituye una prueba de tu propia restauración.
Diseña la cobertura por ubicación, no por nombre de usuario
Recorre con cada área dónde guarda realmente su trabajo. Incluye Escritorio, Documentos, carpetas creadas en la raíz del disco, unidades externas, perfiles adicionales y archivos de aplicaciones. Anota qué datos son locales, cuáles solo tienen un marcador de descarga y cuáles pertenecen a un servidor o servicio remoto. No copies indiscriminadamente cachés, secretos o información personal ajena al propósito empresarial.
Para cada ubicación registra el mecanismo que la protege y quién responderá por recuperarla. Una carpeta de red montada en la laptop no convierte al equipo en responsable de respaldar el servidor. Y una copia del cliente de ERP no protege la base de datos del ERP: ese es otro plan de recuperación. Si necesitas proteger la aplicación central, continúa con la evaluación de recuperación ante desastres para ERP.
1. Dato que existeArchivo local, fecha de cambio y ubicación. ¿Está incluido o excluido?
2. Copia que terminóPunto recuperable, antigüedad y retención. ¿Sobrevive al incidente previsto?
3. Trabajo que funcionaRestaurar en destino limpio, abrir y validar. ¿El usuario puede continuar?
Flujo de comprobación: un archivo descubierto no es todavía un archivo respaldado; un archivo respaldado no es todavía un puesto recuperado. Si falla un paso, el siguiente no compensa esa ausencia.
Separa la copia del riesgo que quieres cubrir
Una copia fuera de la oficina ayuda ante robo o daño del sitio. Para un compromiso de credenciales, revisa además quién puede borrar originales y copias, cómo se recupera el acceso y qué retenciones resisten esa acción. Un disco siempre conectado puede quedar expuesto al mismo equipo comprometido. CISA recomienda copias offline cifradas y pruebas periódicas de disponibilidad e integridad.
La regla 3-2-1 es una guía para diversificar copias y ubicaciones, no una certificación. Si utilizas su ampliación 3-2-1-1-0, explica qué copia queda offline o protegida contra cambios y qué comprobaciones respalda el “cero errores”. No significa cero riesgo futuro. Verificar una suma de comprobación tampoco demuestra, por sí solo, que una aplicación podrá abrir el contenido.
Frecuencia, retención y monitoreo responden preguntas distintas
Frecuencia: ¿cuánto trabajo se puede perder entre puntos recuperables? El RPO es el objetivo de pérdida tolerable, no el intervalo que muestra el programador. Un equipo apagado o desconectado puede incumplirlo.
Retención: ¿cuánto tardarías en descubrir un borrado o corrupción? Si el error se detecta después de desaparecer la última versión sana, ejecutar más copias no lo corrige.
RTO: ¿cuándo debe poder continuar el usuario? Incluye conseguir equipo, acceso autorizado, descarga, instalación y validación. El tiempo de transferencia es solo una parte.
Monitoreo: ¿quién actúa cuando falta una copia? Observa antigüedad del punto recuperable por equipo y ubicación, no únicamente porcentaje de tareas exitosas. Una tarea correcta puede haber omitido justo la carpeta necesaria.
Acuerda la frecuencia de pruebas según criticidad, cambios de equipo, aplicaciones y políticas. Repite pruebas después de cambios relevantes; no adoptes un calendario trimestral universal como sustituto del análisis.
Caso resuelto: la laptop dice “sincronizado”, pero falta la carpeta de trabajo
Ejemplo hipotético de decisión. Los archivos, fechas, tiempos y resultados siguientes son supuestos didácticos, no mediciones de un cliente ni una prueba realizada sobre un servicio.
Entradas: lo que se necesita recuperar
Una oficina tiene ocho laptops. En una de ellas, una persona prepara cotizaciones en una carpeta local llamada “Proyectos”, fuera de la carpeta sincronizada. El equipo contiene 80 GB de datos de trabajo; 6 GB corresponden al proyecto urgente. Viaja el lunes y trabaja sin conexión desde las 09:00. El último punto recuperable completo es del domingo a las 20:00. A las 15:00 del lunes se plantea el escenario de pérdida del equipo.
La oficina fija para este proyecto una pérdida tolerable de cuatro horas y un objetivo de retorno de cuatro horas desde la declaración del incidente. Tiene un equipo de reemplazo disponible, una cuenta de recuperación independiente y software instalable. La conexión de recuperación se supone de 40 Mb/s efectivos; para el cálculo se usan GB decimales. Estos objetivos pertenecen al ejemplo, no son recomendaciones para todas las empresas.
Razonamiento: la primera falla está antes de la descarga
El punto del domingo tiene 19 horas de antigüedad en el momento del incidente. Aunque no todas fueron horas trabajadas, no protege los cambios del lunes; por tanto, no acredita el objetivo de cuatro horas. Si “Proyectos” nunca estuvo incluida, ni siquiera ese punto contiene el dato buscado. Cambiar a una descarga más rápida no resuelve una copia inexistente.
La decisión es incorporar y verificar la carpeta, acordar oportunidades de conexión durante el viaje y alertar cuando la antigüedad exceda el objetivo. Si la persona debe permanecer desconectada más tiempo que la pérdida tolerable, hay que cambiar el modo de trabajo, usar una protección local separada apropiada al riesgo o aceptar explícitamente otro objetivo. Ningún agente puede subir a la nube cambios que no logra transmitir.
Para recuperar, se priorizan los 6 GB del proyecto antes que los 80 GB del equipo. El límite ideal de transferencia es: horas = GB × 8,000 ÷ Mb/s ÷ 3,600. Para 6 GB y 40 Mb/s son 0.333 horas, aproximadamente 20 minutos. Para 80 GB son 4.444 horas, unas 4 horas 27 minutos. No incluye preparación, latencia, límites del servicio, reintentos ni validación; con velocidad desconocida no existe una estimación defendible.
Restauración de prueba: qué se simula y cómo se acepta
La segunda prueba ocurre después de corregir la exclusión, completar una nueva copia y crear las versiones y el borrado de prueba dentro de su retención. No recupera retroactivamente lo que faltaba en la copia del domingo. El guion usa un equipo de reemplazo, una carpeta de destino distinta y archivos de prueba sin datos sensibles. Conserva el equipo original sin sobrescribirlo. Se registran un archivo actual, una versión anterior y un archivo eliminado que aún deba estar retenido. El responsable anota fecha del punto, cantidad esperada, contenido identificable y apertura en la aplicación.
Bitácora didáctica: resultado supuesto, no ensayo ejecutado
Comprobación
Resultado del escenario
Decisión
Carpeta Proyectos incluida
Primera revisión: ausente del conjunto protegido.
No aceptar cobertura. Corregir selección y esperar una copia completa.
Archivo actual, anterior y eliminado
Después de corregir: los tres se recuperan del punto elegido y se abren en destino separado.
Aceptar esas recuperaciones, no extender el resultado a todos los archivos.
Proyecto operativo
Supuesto de segunda prueba: 40 min de preparación + 35 min de descarga + 45 min de aplicación y validación = 120 min.
Dos horas caben en el objetivo de cuatro para este conjunto, con este equipo disponible.
Trabajo del viaje
Los cambios posteriores al último punto no están en la copia.
El RPO sigue sin cumplirse. Resolver conectividad o aceptar el riesgo por escrito.
Resultado y contrafactual: qué cambia realmente la decisión
El plan corregido permite recuperar la carpeta y priorizar el proyecto, pero no debe aprobarse como cumplimiento integral mientras permanezca la brecha del viaje. Se necesitan responsables y una nueva prueba con la política de conexión acordada. El resultado no es “comprar más almacenamiento”: es eliminar una exclusión, comprobar restauración y hacer visible el periodo sin protección.
Si todos los archivos estuvieran incluidos en un servicio con recuperación suficiente y el usuario pudiera continuar desde otro equipo, quizá no haría falta una imagen completa ni contratar administración adicional. Si dependiera de un periférico, licencia ligada al hardware o aplicación difícil de reinstalar, devolver archivos no bastaría: el ensayo tendría que incluir ese requisito. Si fueran 80 GB indispensables desde el primer momento, la transferencia ideal ya excedería las cuatro horas y haría falta otra estrategia, no prometer el mismo RTO.
Guion reutilizable: del respaldo terminado a la aceptación del usuario
Requisitos: permiso para restaurar, destino aislado con espacio, acceso recuperable sin depender del equipo perdido, software compatible y una persona que conozca los archivos. Si hay sospecha de ransomware, coordina contención y revisión de seguridad antes de devolver datos a producción; no asumas que la copia más reciente es sana.
Fija el escenario: archivo borrado, versión incorrecta o equipo perdido. Especifica qué resultado sería suficiente y qué no estás probando.
Elige muestras representativas: documento pequeño, archivo grande, archivo de aplicación y una ubicación poco habitual. Incluye una versión anterior y un eliminado dentro de la retención acordada.
Identifica el punto: fecha, zona horaria, ubicación, exclusiones y finalización. No confundas inicio de tarea con copia completada.
Restaura sin sobrescribir: utiliza una ruta separada y verifica permisos del destino. Un ensayo no debe reemplazar trabajo vigente.
Comprueba contenido: compara cantidad y tamaño cuando corresponda; usa hashes para archivos que deban ser idénticos y abre los documentos en su aplicación. Revisa fórmulas, referencias o elementos vinculados relevantes.
Valida el puesto: confirma que el usuario autorizado puede editar y guardar; prueba instalación, licencias y periféricos si forman parte del alcance. No copies tokens para saltarte autenticación.
Cierra las excepciones: registra faltantes, tiempos por etapa, responsable y fecha de nueva prueba. No marques “todo correcto” porque una muestra funcionó.
Ficha para copiar a tu bitácora
Equipo o perfil: ______ Escenario y alcance de la prueba: ______ Ubicaciones incluidas / excluidas: ______ Dato local, remoto o solo disponible en línea: ______ RPO y RTO acordados, con inicio del reloj: ______ Punto recuperable, zona horaria y antigüedad: ______ Retención y fecha límite para recuperar: ______ Destino separado y acceso autorizado: ______ Archivo actual / versión anterior / eliminado: ______ Resultado esperado y obtenido para cada muestra: ______ Preparación / transferencia / instalación / validación: ______ Aplicación y usuario que aceptan el resultado: ______ Faltantes, responsable y fecha de repetición: ______ Decisión: aceptado para este alcance / pendiente / rechazado: ______
Regla para usarla: “no comprobado” no equivale a “correcto”. No escribas contraseñas, claves de cifrado ni contenido confidencial en esta ficha.
Qué revisar cuando una laptop deja de aparecer
Distingue vacaciones, falta de conexión, agente desinstalado, credenciales vencidas y equipo dado de baja. Define un responsable suplente para alertas; una notificación sin atención no cierra el incidente. Al reemplazar o retirar un equipo, confirma cómo se conserva el respaldo anterior, quién podrá restaurarlo y cuándo vence. No borres la copia anterior solo porque la nueva computadora aparece registrada.
Costo total: compara la operación, no solo gigabytes
Una propuesta comparable debe separar licencia por equipo o usuario, capacidad y retención, implantación, monitoreo, pruebas, restauraciones, transferencias cobradas, asistencia y salida. Pregunta si se cobra por equipo inactivo, datos de exempleados o versiones conservadas; registra impuestos y moneda. No apliques un porcentaje supuesto de compresión para prometer una factura menor.
TCO mensual equivalente = cuotas + capacidad/retención + cargos de recuperación previstos + horas internas × costo por hora + preparación amortizada. Usa el mismo alcance y horizonte. El equipo de reemplazo puede ser una inversión aparte. No inventes una probabilidad de ransomware para convertir un riesgo en “ahorro garantizado”.
Ejemplo económico hipotético, no cotización: si dos opciones cubren la misma licencia y capacidad, pero la administrada cuesta $1,200 MXN más al mes, y tu costo interno es $400 MXN por hora, la diferencia equivale a tres horas mensuales. Solo se compensa por tiempo si realmente evita al menos esas tres horas sin dejar fuera tareas. Puede justificarse además por cobertura operativa o especialización, pero ese valor debe demostrarse, no darse por hecho. Impuestos y diferencias de alcance deben incorporarse antes de comparar.
Cuándo ayuda un socio experimentado
Un proveedor con experiencia demostrable puede aportar inventario de cobertura, seguimiento de equipos desconectados, solución de exclusiones, guiones de recuperación y coordinación durante el reemplazo. Pide evidencia del método, responsables y un reporte de muestra anonimizado. La diferencia defendible no es “somos más caros y por eso mejores”, sino el trabajo concreto que deja de depender de una persona ocupada o ausente.
Solicita por escrito horario de atención, tiempo de primera respuesta, qué restauraciones incluye, límites de volumen, intervención en aplicaciones, traslado o suministro de hardware y escalamiento a fabricantes. Una respuesta de soporte dentro de cierto plazo no garantiza terminar la recuperación en ese mismo plazo. Tampoco un respaldo contratado convierte automáticamente a nadie en responsable de tus licencias o del dato guardado fuera del alcance.
Cuándo hacerlo internamente o no contratar un servicio adicional
Un equipo pequeño, con datos bien ubicados, administración disponible y pruebas documentadas puede operar su propio esquema. También puede bastar una revisión puntual para corregir cobertura, o aprovechar mecanismos ya contratados si satisfacen los escenarios y retenciones necesarios. Conserva una copia apropiadamente separada cuando el riesgo lo exija. Contratar otra cuota sin alguien que revise exclusiones y ensaye recuperación no resuelve la disciplina operativa.
Si necesitas contrastar alcance y responsabilidades, solicita una revisión de tus requisitos. Lleva número de equipos, sistemas operativos, ubicaciones de datos, volumen, objetivos y la ficha de prueba, sin archivos privados ni credenciales. Confirma primero si el servicio ofrecido cubre endpoints: alojar un servidor no implica administrar los respaldos de todas las laptops.
IA: ayuda a revisar evidencias, no certifica que puedas restaurar
Una herramienta de IA capaz de analizar texto puede ayudar a ordenar registros anonimizados, resumir exclusiones o preparar preguntas para una propuesta. Su utilidad aquí es documental: no crea una copia ausente, no determina por sí misma que un archivo está sano y no sustituye abrirlo en la aplicación.
Una tarea acotada sería darle cuatro registros ficticios con identificador de equipo, última copia completada, exclusiones y resultado de restauración. Pídele: “Separa hechos y datos faltantes. Cita el registro que respalda cada observación. No declares protegido ningún equipo sin evidencia de cobertura y restauración. Devuelve la siguiente comprobación humana, no instrucciones para borrar o cambiar retenciones”.
Por ejemplo, ante “equipo A: tarea correcta; Proyectos excluida”, una conclusión aceptable es “la tarea terminó, pero esa carpeta no está cubierta”. “Equipo protegido” sería una inferencia incorrecta. Revisa manualmente cada observación contra el registro y calcula antigüedad con fechas y zona horaria explícitas. Para reglas simples, una hoja o alerta determinista suele ser más verificable que un resumen generado.
No subas archivos de clientes, nombres de usuario, rutas sensibles, claves ni registros completos a un servicio no autorizado. Comprueba permisos, conservación y uso de datos antes de utilizarlo. Si la herramienta no puede leer un archivo, carece de contexto o contradice el registro, marca la conclusión como no determinada. La decisión sobre restauración, retención y acceso sigue siendo humana.
Preguntas que conviene cerrar antes del primer incidente
¿Un respaldo en la nube protege lo que solo está disponible en línea?
No lo asumas. Un marcador local puede no contener los bytes del archivo. Verifica si el mecanismo protege el servicio remoto o requiere descargar el contenido; revisa también exclusiones y el espacio necesario. Comprueba un archivo representativo mediante restauración independiente.
¿Puedo recuperar una computadora completa con una copia de archivos?
Puedes recuperar los archivos incluidos. El sistema, las aplicaciones, licencias, controladores y configuración pueden necesitar reinstalación. Decide si una reconstrucción documentada basta o si necesitas imagen; ensaya sobre el reemplazo previsto, no solo sobre el equipo original.
¿Conservar más versiones siempre es mejor?
Más retención puede cubrir detecciones tardías, pero cuesta y aumenta lo que debes custodiar. Define periodos por uso y obligaciones aplicables, quién autoriza la eliminación y cómo se atiende la salida de una persona o proveedor. No conserves datos sin propósito solo porque hay espacio.
¿Qué debo hacer hoy si nunca he probado una restauración?
Elige un archivo no sensible, una versión anterior y un eliminado que deba seguir retenido. Recupéralos a una carpeta distinta y verifica su contenido. Documenta qué alcance comprobaste y qué falta. Si no encuentras un punto recuperable, registra la brecha antes de contratar más capacidad.
La pregunta para tu equipo: si mañana desaparece una laptop, ¿qué archivo importante descubrirían que nunca estuvo en el respaldo? Empieza por esa ubicación y convierte la respuesta en una prueba.
Si vas a definir presupuesto y contrato, conviene empezar por qué preguntar antes de contratar un servidor para tu ERP; así, evitarás ambigüedades, reducirás costos ocultos y, además, compararás propuestas “manzana con manzana”. En la práctica, el desempeño del ERP depende de cuatro pilares: arquitectura, red, continuidad y operación. Por lo tanto, ordenemos las preguntas críticas por cada frente, integrando referencias técnicas para que puedas verificar.
Checklist ejecutivo: qué preguntar antes de contratar un servidor para tu ERP
¿Cuál es el rendimiento por núcleo (benchmarks reales) y cuántas vCPU recomiendan para mis usuarios concurrentes?
¿Qué IOPS y latencia de disco ofrece el volumen NVMe en P95 bajo carga sostenida?
¿Cómo separan datos, WAL/logs y backups en volúmenes distintos?
¿Licenciamiento incluido (SPLA) o BYOL? ¿La matriz de licencias está firmada y es auditable?
¿RTO/RPO garantizados y pruebas de restauración calendarizadas?
¿Cómo mitigarán la latencia de sucursales (QoS, SD-WAN, DNS local, RDP/VDI)?
¿Qué cubre el SLA (primer respuesta, escalamiento, créditos por incumplimiento)?
¿Monitoreo 24/7 con reportes mensuales y recomendaciones de ajuste de capacidad?
¿CFDI, moneda y términos de salida (egress, entrega de respaldos en formatos abiertos)?
Si deseas una revisión inicial de arquitectura con estimaciones de IOPS y rutas de acceso, solicita una evaluación técnica aquí: Servicios en la nube para empresas.
Arquitectura y rendimiento (CPU, RAM, NVMe, IOPS)
Antes de nada, exige frecuencia alta y buen desempeño por hilo, porque muchas operaciones del ERP son sensibles al tiempo de CPU más que al conteo masivo de núcleos. Asimismo, pide al proveedor valores de IOPS y latencia P95/P99 con la carga que tú esperas (lecturas y escrituras mixtas). Adicionalmente, solicita separar volúmenes:
Datos de la base, WAL/log y temp en NVMe distintos;
Backups en almacenamiento independiente (idealmente con otra política de acceso y cifrado).
Para comparar dimensiones y evitar sesgos comerciales, valida ejemplos prácticos y recomendaciones específicas por aplicación; si trabajas con Odoo, aquí tienes una guía de sizing y buenas prácticas: Servidor cloud para Odoo en México. En cualquier caso, recuerda qué preguntar antes de contratar un servidor para tu ERP sobre la relación entre vCPU, IOPS y tamaño de cachés para tus picos de fin de mes.
Licenciamiento y cumplimiento (SPLA/BYOL)
Matriz por versión, núcleo y usuario
Además de la potencia, la legalidad importa. Por consiguiente, solicita una matriz de licencias con versiones, métricas (núcleo/usuario/TB) y evidencia de elegibilidad en nube si aportarás BYOL. Pide que el contrato identifique dónde corre cada componente (VM/host), cómo se mide el consumo y cómo se audita. Para evitar bloqueos o sanciones, cruza esta lista con la guía de referencia: Servidor cloud con licencias correctas. Incluye en tu lista qué preguntar antes de contratar un servidor para tu ERP acerca de renovaciones, cambios de versión y compatibilidad entre sistema operativo, motor de base de datos y el propio ERP.
Sin un objetivo de recuperación, no hay presupuesto realista. Por eso, exige RTO y RPO explícitos y alcanzables, además de pruebas de restauración documentadas. Para gran parte de las pymes, un RPO ≤ 15 min y un RTO ≤ 60 min suelen ser metas razonables; aun así, confírmalo con tus ventanas de operación. Asimismo, solicita diagrama de activo/pasivo o activo/activo entre zonas, planes de conmutación y bitácoras de drills trimestrales. Esta guía te ayudará a exigir lo correcto por contrato: ERP con Disaster Recovery: qué pedir a tu proveedor. Todo lo anterior forma parte de qué preguntar antes de contratar un servidor para tu ERP, especialmente cuando los cierres contables no admiten caídas.
Red y acceso: latencia desde oficinas remotas
La aplicación puede ser rápida en el data center y, sin embargo, sentirse lenta en sucursales. Por lo tanto, pide políticas de QoS por aplicación, enlaces redundantes con SD-WAN, DNS local con TTL corto y perfiles RDP/VDI optimizados (compresión activa, prioridad de entrada, redirecciones deshabilitadas). Para implementar un plan paso a paso y probar la experiencia de usuario, apóyate en esta guía: Servidor para ERP en cierres de mes, ya que ahí se concentran los picos. Además, vuelve a recordar qué preguntar antes de contratar un servidor para tu ERP sobre mediciones P95/P99 y líneas base por transacción (abrir catálogo, guardar documento, generar reporte).
¿Quieres levantar un piloto con escritorios publicados y balanceo en horas? Arranca un entorno administrado: Servidores Virtuales Cloud VPS.
Seguridad sin fricción: Qué preguntar antes de contratar un servidor para tu ERP
En paralelo, solicita hardening del sistema, TLS extremo a extremo, MFA para cuentas privilegiadas, protección de endpoints expuestos, registros de auditoría y copias cifradas con llaves rotadas. Evita inspecciones redundantes cuando ya exista cifrado de punto a punto, y define listas de acceso por rol (app, DB, backups). Además, documenta tiempos de parcheo y ventanas de mantenimiento anunciadas.
Monitoreo, SLA y operación continua: Qué preguntar antes de contratar un servidor para tu ERP
Métricas P95/P99 y créditos por incumplimiento
Pide monitoreo 24/7 con alertas sobre CPU, RAM, IOPS y latencia de aplicación, además de reportes mensuales con recomendaciones de ajuste. Respecto al SLA, exige tiempos de primera respuesta, escalamiento y créditos por incumplimiento. Incluye métricas operativas (P95 de apertura de catálogo, guardado y reporte) para que el acuerdo sea accionable. Asimismo, define responsabilidades en incidentes y “runbooks” de recuperación. Y, sí, anota nuevamente qué preguntar antes de contratar un servidor para tu ERP en materia de evidencias y entregables mensuales.
Costos y términos de salida: Qué preguntar antes de contratar un servidor para tu ERP
Para evitar sorpresas, solicita un anexo con costos de egress, precios por IOPS extra, crecimiento de almacenamiento por GB/mes y horas de ingeniería fuera de SLA. Pide formatos abiertos para exportar bases de datos, adjuntos y logs, además de procedimientos de borrado seguro tras la terminación. De igual forma, pregunta por la moneda de facturación, CFDI, recargos por pago tardío y ajustes por tipo de cambio. Con esta visión completa, será más fácil aterrizar qué preguntar antes de contratar un servidor para tu ERP en tu realidad financiera.
Qué preguntar antes de contratar un servidor para tu ERP
Propón un piloto con: 1) despliegue inicial; 2) pruebas sintéticas y de estrés con datos enmascarados; 3) restauración parcial y conmutación planificada; 4) reporte final con métricas y mejoras. Define criterios de aceptación (tiempos P95 máximos, RTO/RPO logrados, latencia por sede) para pasar a producción con certeza.
Si sigues este checklist, tendrás claridad técnica, legal y operativa. Y, sobre todo, sabrás qué preguntar antes de contratar un servidor para tu ERP para que el proveedor te entregue exactamente lo que necesitas, sin costos ocultos ni promesas ambiguas.
Si tu meta es una instancia estable, segura y veloz, comenzar con un servidor cloud para Odoo en México te dará control fino sobre rendimiento, escalabilidad y soporte. Además, al definir criterios técnicos desde la cotización, podrás pedir propuestas comparables y, por consiguiente, evitar sobrecostos en producción.
Por qué un servidor cloud para Odoo en México
Odoo integra módulos de ventas, compras, inventario, contabilidad y facturación local. Por lo tanto, requiere CPU con buen desempeño por hilo, almacenamiento NVMe de baja latencia y una base de datos optimizada. Asimismo, en México vas a necesitar timbrado CFDI, complementos y reglas fiscales locales; en consecuencia, conviene asegurar versiones soportadas, parches y un proveedor que emita factura.
(Primer consejo práctico) Integra los costos “no evidentes” en tu presupuesto (egress, pruebas de DR, soporte, almacenamiento). Para no dejar nada fuera, compárate con esta guía de referencia sobre diferencias de costo operativo: ERP en Cloud vs Local: Costos ocultos.
Requisitos técnicos del servidor cloud para Odoo en México
Para dimensionar, arranca por usuarios concurrentes y transacciones pico. Después, traduce eso a vCPU, RAM e IOPS; así, evitarás cuellos de botella.
CPU: prioriza frecuencia y rendimiento por núcleo; Odoo (Python + PostgreSQL) responde bien a núcleos rápidos y pocos “ruidos” vecinos.
RAM: reserva memoria para Odoo workers, PostgreSQL (buffers), Redis y sistema; añade 20–30% de holgura para picos.
Almacenamiento NVMe: separa volúmenes: base de datos, logs, archivos (filestore) y backups; de este modo, aislas I/O críticos.
Red: exige latencia baja hacia tus sedes y un 95 percentil controlado; además, negocia ancho de banda saliente suficiente para reportes y APIs.
Dimensionamiento del servidor cloud para Odoo en México
Empieza con un perfil inicial (por ejemplo, 4–8 vCPU, 8–16 GB de RAM, NVMe dedicado) y valida con pruebas sintéticas: alta de cliente, orden de venta, validación de factura, movimiento de inventario y consulta de reportes. Asimismo, mide P95/P99 para verificar que los tiempos “peores aceptables” estén dentro de tus SLA internos.
Almacenamiento NVMe en el servidor cloud para Odoo en México
Mientras más grande la base, más se nota la latencia. Por eso, coloca PostgreSQL en NVMe y separa el WAL/log del volumen de datos. Además, activa compresión y rotación de logs, y define retención por normativa. Si necesitas un repositorio capacitado para copias masivas, repasa esta guía útil sobre arquitecturas de almacenamiento: Servidores de almacenamiento de datos en la nube 2025.
Seguridad del servidor cloud
TLS extremo a extremo y copias cifradas
De inicio, habilita TLS de extremo a extremo (proxy inverso + app + DB). Asimismo, aplica hardening en el sistema, usa MFA para administración y registra auditoría. En paralelo, incorpora Redis para sesiones, configura límites de solicitud y protege endpoints expuestos. Y, además, cuida la privacidad: usa copias cifradas y llaves rotadas. Para un refuerzo adicional, consulta estas mejores prácticas de blindaje y copias: ERP seguro en la nube con cifrado y respaldos dobles.
No basta con tener backups; necesitas pruebas de restauración calendarizadas y, además, un plan de conmutación. Define RTO/RPO con base en tus horas de operación y, después, elige activo/pasivo o réplicas entre zonas. Documenta responsables, ventanas y tiempos de reversión. Para estructurarlo sin ambigüedades, apóyate en esta guía: ERP con Disaster Recovery: qué pedir a tu proveedor. Paralelamente, considera un VPS para respaldos fuera de línea para neutralizar ransomware y cumplir retenciones: VPS para respaldos.
Cuando tus equipos trabajan desde varias oficinas, la red define la experiencia. Por lo tanto, implementa SD-WAN con QoS por aplicación, split-tunnel en VPN y DNS local con TTL corto. Además, si acceden por RDP/VDI, prioriza la entrada (teclado, mouse), limita FPS y desactiva redirecciones innecesarias; así, evitarás congestión. Para una guía paso a paso que ya puedes aplicar, revisa: Cómo evitar latencia en ERP al trabajar desde oficinas remotas.
Licencias, versiones y timbrado
Asimismo, confirma versiones soportadas de Odoo y PostgreSQL, más módulos mexicanos (CFDI, complementos). Solicita matriz de licencias y carta de elegibilidad en nube (si llevas BYOL). Exige que el contrato identifique dónde corre cada producto y cómo se mide consumo. Además, pide que el proveedor emita CFDI y que documente el proceso de actualización mayor.
Monitoreo del servidor cloud para Odoo en México
Telemetría 24/7 con P95/P99
Sin visibilidad, no hay SLA que se cumpla. Por consiguiente, implementa métricas y alertas: CPU, RAM, IOPS, latencia de disco, conexiones a DB, tiempos de endpoints críticos y errores por módulo. Pide reportes mensuales y ajustes de capacidad. Y, de hecho, agrega pruebas sintéticas que simulen la jornada real (ventas, inventario, contabilidad).
¿Quieres levantar tu instancia con monitoreo, copias y actualizaciones administradas? Solicita un arranque guiado aquí: Servidores Virtuales Cloud VPS.
Migración ordenada: datos, adjuntos y pruebas
Antes de mover producción, ejecuta un cutover con: inventario de módulos, congelamiento de cambios, sanitización de datos, exportación/importación controlada y verificación de permisos. Después, corre pruebas de negocio: creación de facturas, conciliación bancaria, impresión de CFDI y reportes clave. Finalmente, programa una ventana de reversión.
Checklist final del servidor cloud para Odoo en México
CPU con alto rendimiento por núcleo; RAM con 20–30% de holgura.
NVMe separado para DB, WAL, filestore y backups.
TLS, MFA, hardening y copias cifradas.
DR con RTO/RPO definidos y pruebas trimestrales.
SD-WAN, QoS, DNS local y perfiles RDP/VDI optimizados.
Licencias y versiones documentadas; CFDI garantizado.
Monitoreo 24/7 con reportes y pruebas sintéticas.
Proceso de migración y reversión probado.
Si deseas comparar dos tamaños de instancia con cálculos de IOPS y escenarios de DR listos para auditoría, pide tu cotización en español y revisa opciones administradas con CFDI aquí: Servidores nube VPS para empresas. Y, si prefieres iniciar ya con un stack optimizado, arranca tu instancia desde: Servidores Virtuales Cloud VPS.