Proveedores de servidores cloud en México no es una búsqueda “de infraestructura”, sino, más bien, una búsqueda de continuidad: si tu sistema se cae, si se vuelve lento, o si el soporte tarda, entonces la operación se detiene y, por lo tanto, el costo real aparece en horas perdidas, clientes esperando y tareas críticas acumuladas. Además, aunque dos ofertas parezcan parecidas, en la práctica se separan cuando hay carga, cuando hay incidentes, o cuando toca recuperar.
Ahora bien, para comparar bien, conviene cambiar el enfoque: en lugar de elegir por “GB y precio”, evalúa por operación. Es decir, revisa recursos garantizados, rendimiento de almacenamiento, monitoreo, backups con restauración probada y soporte con escalamiento. En consecuencia, la elección se vuelve técnica, medible y defendible.
Proveedores cloud empresariales en México: qué estás comprando en realidad
Cuando una empresa contrata “cloud”, normalmente contrata una combinación de recursos y operación. Por eso, conviene pedir claridad en cuatro frentes: cómputo (vCPU/RAM), almacenamiento (latencia/IOPS), red (estabilidad y rutas), y operación (soporte, mantenimiento, backups). Además, si tu carga es un ERP o un sistema administrativo, entonces el desempeño percibido depende mucho del disco y de la red, no solamente de la CPU.
Asimismo, aunque haya ofertas “ilimitadas” en marketing, en infraestructura casi todo tiene límites técnicos. Por lo tanto, el proveedor confiable es el que explica límites, umbrales y cómo se escala sin improvisar.
Proveedor de nube para empresas: hyperscaler vs proveedor administrado
En México puedes elegir entre nubes globales de autoservicio y proveedores más enfocados a acompañamiento y administración. Sin embargo, lo relevante no es la etiqueta, sino el modelo operativo: ¿tu equipo interno puede operar monitoreo, parches, seguridad y recuperación?, ¿o necesitas que el proveedor lo haga y lo documente?
De hecho, si tu empresa no tiene un equipo TI dedicado 24/7, entonces el valor no está en “tener consola”, sino en tener respuesta, guías, y acciones repetibles. En consecuencia, el proveedor administrado suele ser más compatible con empresas que requieren estabilidad sin convertirse en un centro de operaciones.
Cómo detectar si tu servidor actual ya quedó corto para un sistema crítico
Antes de cambiar, primero valida señales. A veces la empresa normaliza la lentitud intermitente; sin embargo, eso suele ser el inicio de un cuello de botella. Por ejemplo, si hay picos por cierres, por reportes, por timbrado, o por sincronizaciones, entonces la carga real está superando el dimensionamiento.
Por esta razón, conviene revisar una guía práctica de síntomas y causas antes de comparar opciones: evitar caídas y lentitud en servidores cloud para sistemas. Además, si ya sospechas riesgo, entonces te conviene contrastar con señales típicas de “servidor al límite” en esta referencia: señales de que tu servidor actual está en riesgo para ERP.
En este contexto, proveedores de servidores cloud en México deja de ser “una lista” y se vuelve un proceso de evaluación.
Rendimiento real: el disco manda, y el proveedor debe demostrarlo
En sistemas empresariales, el almacenamiento suele ser el cuello silencioso. Por lo tanto, cuando preguntes por “SSD”, pide algo más específico: latencia típica, IOPS incluidas, y comportamiento en hora pico. Asimismo, pregunta si el proveedor permite separar volúmenes (SO, datos y logs), porque, de hecho, esa separación reduce fricción cuando la base crece.
Además, evita caer en el error de subir CPU para arreglar disco lento. En consecuencia, el proveedor serio debe ayudarte a identificar la causa dominante y, luego, a dimensionar lo que de verdad limita.
Soporte, SLA y escalamiento: el factor que define el día a día
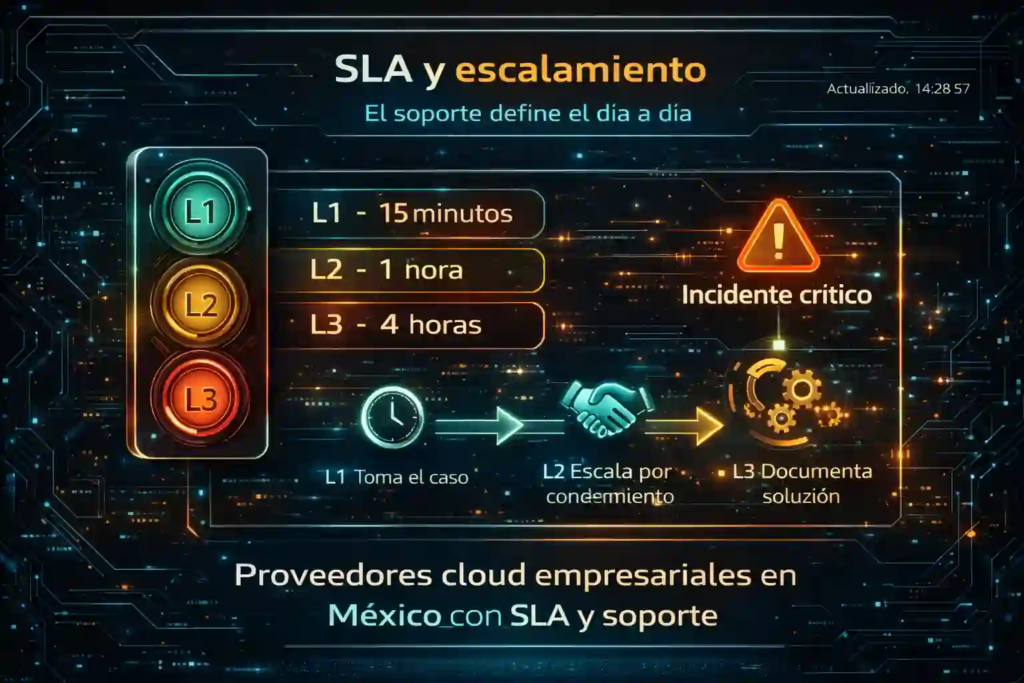
Aunque el hardware sea bueno, la operación se gana con soporte. Por eso, pregunta con precisión: tiempos de respuesta, niveles de escalamiento (L1/L2/L3), canales, y criterios de “incidente crítico”. Además, pide evidencia de proceso: bitácoras, ventanas de mantenimiento, y cómo documentan cambios.
En otras palabras, el SLA no sirve si no hay un mecanismo real para cumplirlo. Por lo tanto, compárate contra tu propia realidad: ¿cuántas horas puedes estar caído?, ¿qué pasa si el sistema se vuelve lento a las 9:00?, ¿quién atiende y en cuánto tiempo?
Aquí, además, conviene remarcar que proveedores de servidores cloud en México se diferencian mucho más por operación y soporte que por “marca”.
Si necesitas una base empresarial para dimensionar y escalar con claridad, revisa opciones de servidores virtuales cloud VPS y compáralas con tu carga real.
Backups y continuidad: backup sin restauración probada no protege
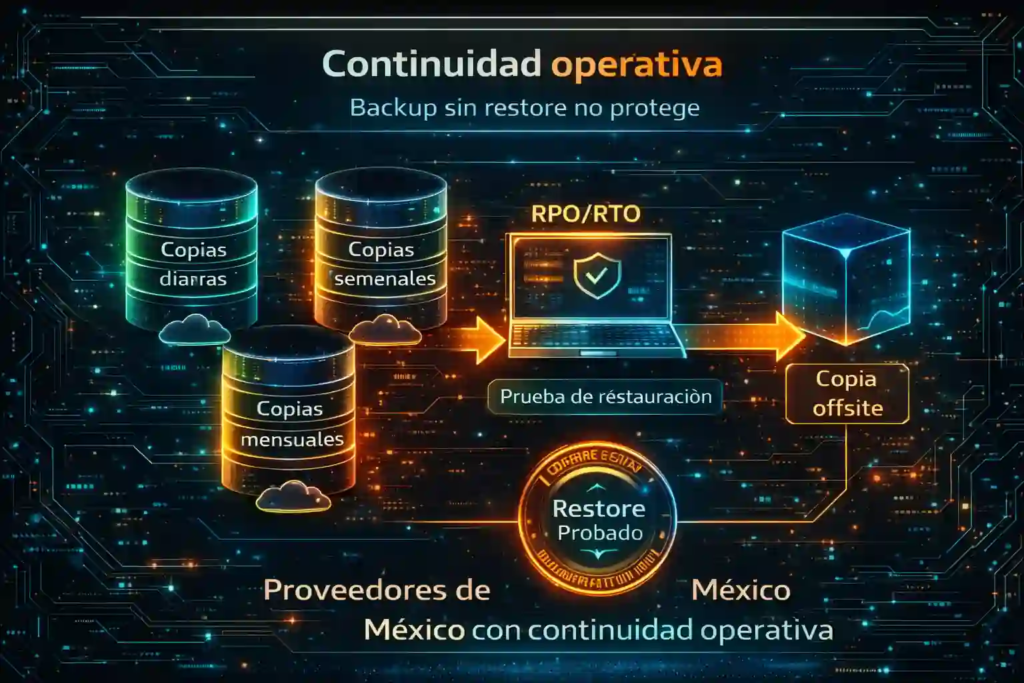
En continuidad operativa, la pregunta no es “¿hay backups?”, sino “¿se restauran y se prueban?”. Por lo tanto, exige: retención diaria/semanal/mensual, copia fuera del servidor, pruebas de restauración calendarizadas, y definición de RPO/RTO. Además, pregunta qué pasa si falla un backup y cómo te enteras.
Para aterrizarlo con criterios claros y lenguaje de negocio, revisa esta guía: respaldos de equipos de cómputo en la nube. Asimismo, úsala como checklist para comparar proveedores, porque, en consecuencia, reduces el riesgo de “respaldos decorativos”.
De hecho, cuando hay incidentes, el diferencial aparece aquí: la empresa que restaura en horas opera; la que no, improvisa.
En este punto, proveedores de servidores cloud en México debe evaluarse con una pregunta central: “¿Cómo vuelvo a operar si algo falla hoy?”
Windows Server y compatibilidad: cuando tu sistema lo exige
Muchas empresas operan sistemas administrativos sobre Windows, y eso no es negociable si la aplicación lo requiere. Por lo tanto, el proveedor debe dominar Windows en producción: parches, hardening, RDP estable, políticas de acceso y ajustes para rendimiento. Además, conviene que el soporte entienda el tipo de carga (multiusuario, escritorio remoto, base de datos).
Aun cuando existan alternativas, en la práctica el riesgo está en forzar migraciones de plataforma sin plan. En consecuencia, si tu operación depende de Windows, el proveedor debe ofrecer una ruta clara, estable y soportada.
Si tu operación requiere Windows y acceso remoto estable, evalúa servidores VPS Windows para sistemas administrativos con enfoque en desempeño y soporte.
Seguridad operativa: controles mínimos que debes exigir
La seguridad no es solo “firewall”. Por eso, pide controles operativos: MFA, gestión de privilegios, bitácora de accesos, segmentación de red, políticas de actualización, y respaldos offsite. Además, pregunta por responsabilidades: qué cubre el proveedor y qué te corresponde a ti, porque, de lo contrario, cada parte asume que la otra lo hace.
Asimismo, si manejas datos sensibles, integra prácticas como cifrado en tránsito, revisión de puertos expuestos y políticas de cuentas. En consecuencia, reduces superficie de ataque sin complicar la operación.
En términos prácticos, proveedores de servidores cloud en México debe poder explicarte seguridad como proceso, no como promesa.
Método comparativo en 5 pasos para elegir sin sesgos
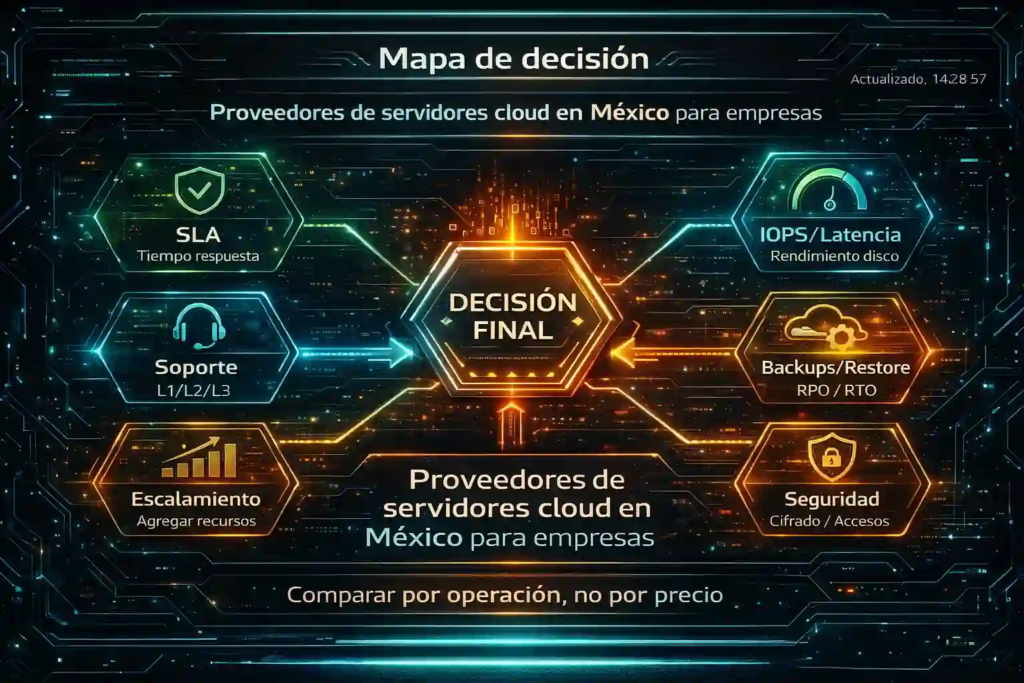
Para decidir con evidencia, aplica este orden:
-
Define carga: usuarios concurrentes, base de datos, picos y procesos pesados.
-
Identifica el cuello dominante: disco, RAM, red o CPU (idealmente con métricas).
-
Compara recursos garantizados y almacenamiento (latencia/IOPS), no solo “tamaño”.
-
Valida continuidad: backups, restore probado, RPO/RTO y copia offsite.
-
Evalúa soporte: SLA real, escalamiento y operación documentada.
Después, si dos proveedores empatan, decide por el que tenga mejor capacidad de acompañamiento en incidentes y cambios. Por lo tanto, tu decisión se vuelve operacionalmente sólida.
Además, si hoy no tienes métricas, entonces el primer paso es instalarlas, porque, en consecuencia, comparas mejor y negocias mejor.
Preguntas que obligan a respuestas útiles (y evitan sorpresas)
Para cerrar la brecha entre marketing y realidad, pregunta así:
-
¿Qué latencia e IOPS se esperan en hora pico, y cómo se monitorea?
-
¿Cómo se alertan incidentes y quién atiende fuera de horario?
-
¿Cómo se escala CPU/RAM/disco y cuánto tarda el cambio?
-
¿Cómo se ejecuta un restore completo y cuánto tarda?
-
¿Qué incluye soporte: infraestructura, sistema operativo, hardening, o solo “encendido”?
Mientras más claras sean las respuestas, más predecible será tu operación. Además, si el proveedor evita responder, entonces esa evasión también es una señal.
Aquí, proveedores de servidores cloud en México se vuelve una decisión de riesgo controlado, no de fe.
CTA 3 (integrado): Si quieres aterrizar tu caso con un criterio técnico y operativo, puedes contactar con la agencia y pedir una recomendación basada en carga, backups y continuidad.
Costos reales: lo caro no es el servidor, es la interrupción
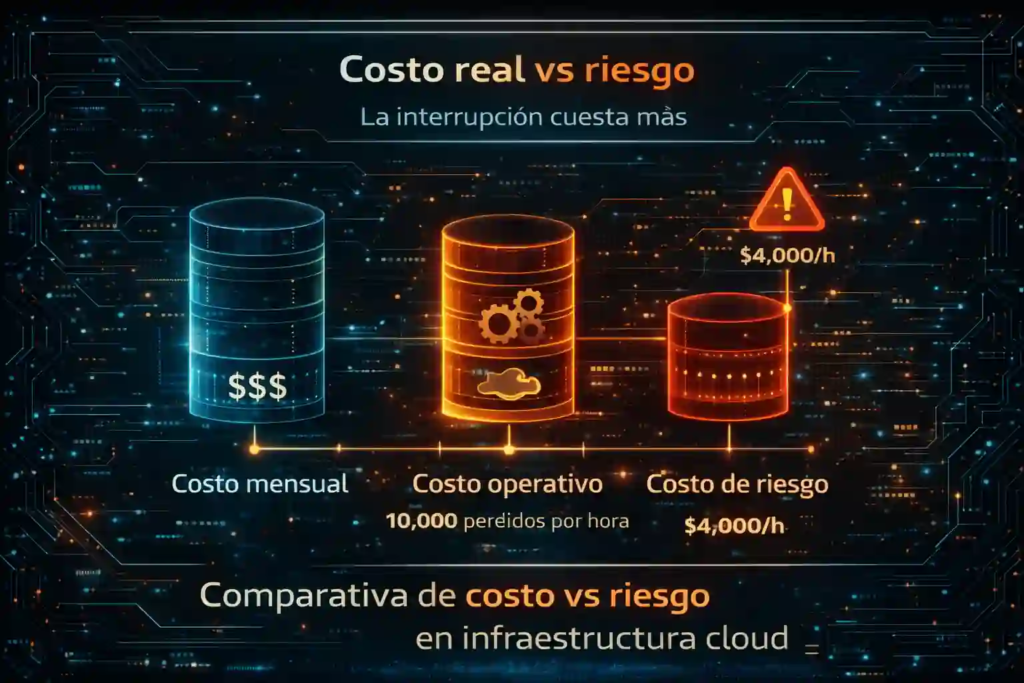
Es tentador elegir el plan más barato. Sin embargo, lo que suele salir caro es el downtime, la pérdida de productividad, y la recuperación improvisada. Por lo tanto, separa costo mensual (infraestructura) de costo operativo (soporte/monitoreo/backups) y de costo de riesgo (tiempo muerto y pérdida de datos).
Además, si tu empresa timbra, factura o cierra contabilidad sobre el sistema, entonces una hora caída puede costar más que un upgrade anual. En consecuencia, tu comparativa debe incluir impacto, no solo precio.
En este cierre operativo, proveedores de servidores cloud en México se debe elegir por estabilidad sostenida, soporte serio y continuidad probada.
Si tu objetivo es crecer con margen y reducir incidentes recurrentes, revisa servidores virtuales cloud VPS y compáralos contra tu checklist antes de decidir.
FAQ´s
1) ¿Cómo comparar proveedores de servidores cloud en México para empresas?
Primero compara recursos garantizados, luego valida disco (latencia/IOPS), después revisa backups con restauración probada y, finalmente, confirma soporte con SLA y escalamiento.
2) ¿Qué debo pedirle a un proveedor cloud para correr un ERP estable?
Pide rendimiento de almacenamiento, monitoreo, backups offsite con restore probado, capacidad de escalamiento, y soporte con tiempos claros para incidentes críticos.
3) ¿Por qué el disco suele ser el cuello de botella en sistemas administrativos?
Porque la base de datos escribe y lee constantemente; por lo tanto, si la latencia sube o las IOPS son bajas, el sistema se siente lento aunque la CPU no esté saturada.
4) ¿Qué significa “restore probado” y por qué importa?
Significa que el backup se ha restaurado con éxito en pruebas; en consecuencia, no depende de suposiciones cuando ocurre un incidente real.
5) ¿Qué es RPO y RTO en continuidad operativa?
RPO define cuánta información puedes perder; RTO define en cuánto tiempo vuelves a operar. Por eso, ambos deben acordarse y probarse.
6) ¿Cuándo conviene elegir un VPS Windows para sistemas administrativos?
Cuando tu software depende de Windows, RDP y compatibilidad específica; además, conviene si necesitas soporte que conozca Windows en producción.
7) ¿Qué señales indican que debo cambiar de proveedor cloud?
Lentitud intermitente, reinicios como “solución”, soporte lento en incidentes, backups sin pruebas de restore, y falta de métricas claras para diagnosticar.
8) ¿Cómo evaluar el SLA de un proveedor cloud?
Revisa tiempos de respuesta, escalamiento (L1/L2/L3), cobertura fuera de horario y, además, evidencia de procesos (bitácoras, mantenimiento, alertas).
9) ¿Qué métricas mínimas debo monitorear siempre?
CPU, RAM, disco (latencia/IOPS/cola/espacio), red (latencia/jitter/pérdida) y disponibilidad de servicios críticos del sistema.
10) ¿Cómo evitar pagar “barato” y terminar pagando más?
Incluye en tu evaluación el costo del downtime, el costo operativo y la continuidad. En consecuencia, comparas por impacto real, no por precio nominal.
Tu ERP está listo para migrar cuando las personas responsables pueden demostrar que el destino cumple los criterios acordados y que saben qué hacer si una condición crítica falla. Que el servidor encienda, permita iniciar sesión o muestre una gráfica favorable no basta para autorizar el cambio de operación.
La decisión de continuar, o GO, debe basarse en evidencia del sistema concreto. La decisión de detenerse, o NO-GO, también es un resultado válido: evita convertir un pendiente conocido en una interrupción de negocio. Esta guía organiza las puertas de aceptación, el momento del corte y los límites del retorno. No es una receta para ejecutar cambios de red, timbrado, seguridad o bases de datos.
La salida de esta guía es un acta de decisión, no una fecha prometida. En el ensayo trabajado una exportación incorrecta detiene el corte; al corregirla, el equipo puede reconsiderarlo. En el segundo escenario, tres pedidos nuevos cambian por completo la posibilidad de volver al origen. Ambos casos son ficticios y sirven para aprender a justificar una decisión propia.
Revisa el punto que necesitas: dependencias · criterios de aceptación · registro GO/NO-GO · plan de retorno.
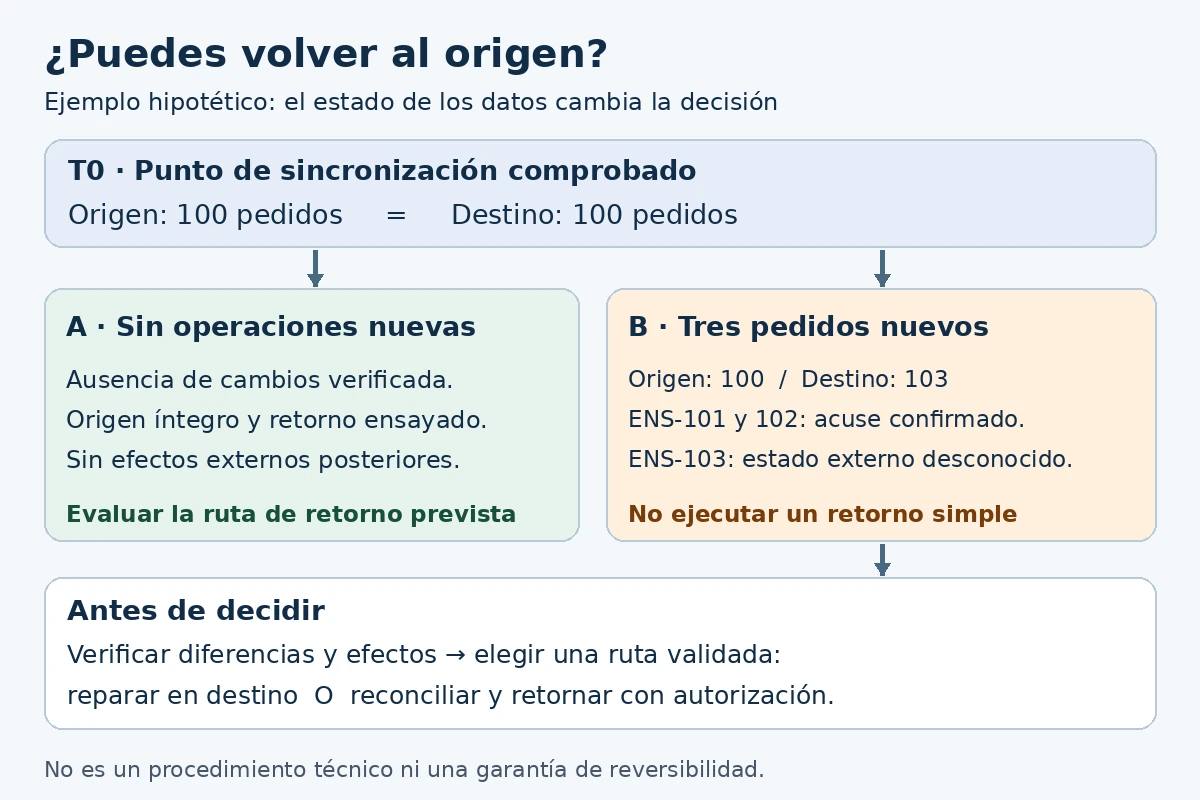
Equivalente textual del diagrama: en T0, origen y destino tienen 100 pedidos comprobados. Si no existen cambios posteriores y el origen sigue validado, se puede evaluar la ruta de retorno ensayada. Si el destino recibe tres pedidos más, hay 103 allí y sólo 100 en origen; además, un acuse externo puede quedar desconocido. Primero se verifican operaciones y efectos; después se decide reparar en destino o reconciliar y retornar. Cambiar el acceso no resuelve esa diferencia.
1. Mapea el proceso completo, no sólo el servidor
Primero delimita el cambio. Mover el mismo ERP a otro alojamiento no es lo mismo que cambiar de producto, de versión o de modelo a SaaS. Una sustitución puede requerir conversión de datos, rediseño de procesos y formación adicional. Esta guía se concentra en decidir un corte de operación; no presupone que todos esos proyectos tengan el mismo procedimiento.
Conserva un inventario de versión del ERP, motor de base de datos, complementos y conectores. Añade archivos compartidos, tareas programadas, dispositivos y servicios externos que intervienen en los procesos críticos. La lista debe explicar qué depende de qué y quién puede validar cada parte.
Una integración puede funcionar fuera del horario del piloto y fallar cuando se ejecuta un cierre. Una impresión puede verse bien en PDF y no salir por el dispositivo que necesita la operación. El mapa de dependencias convierte estas posibilidades en verificaciones concretas, sin afirmar que ocurrirán en todos los proyectos.
- Proceso: qué necesita completar el usuario, desde el inicio hasta la confirmación final.
- Dependencias: aplicación, datos, conectores, archivos, dispositivos y terceros implicados.
- Responsable: quién valida el resultado de negocio y quién atiende la parte técnica.
- Evidencia: qué prueba autorizada demostrará que funciona.
- Consecuencia: si el fallo impide el corte o puede quedar como pendiente aceptado expresamente.
Revisa soporte y derechos de uso para la combinación de versiones y el destino. No conviertas el éxito de una instalación de prueba en una declaración general de compatibilidad. Cuando el fabricante del ERP o del motor exige un procedimiento específico, ése debe formar parte del plan técnico.
2. Acuerda aceptación antes de ejecutar el piloto
Los criterios deben indicar operación, entorno, datos de prueba, carga representativa y resultado esperado. Define también cómo se medirá y quién tendrá autoridad para aceptarlo. Un umbral de CPU, memoria o latencia copiado de otra empresa no sustituye los requisitos de tu proceso.
Compara tiempos de tareas equivalentes y conserva errores y resultados, no sólo promedios. La duración del piloto depende de lo que necesites observar: procesos diarios, cierres, integraciones programadas o situaciones de excepción. Un número fijo de días no garantiza que se haya cubierto un ciclo relevante.
La disponibilidad observada en un piloto tampoco demuestra por sí sola un nivel de servicio futuro. Documenta la ventana y sus limitaciones. Si no se ensayó un proceso importante, clasifícalo como pendiente; no lo presentes como aprobado porque otros procesos se ejecutaron sin errores.
La guía de planificación de migración de Microsoft plantea criterios de retorno, responsables y decisiones de preparación. Su ámbito es Azure: aquí se usa como referencia de planificación, no como una arquitectura obligatoria ni una garantía aplicable a cualquier proveedor.
3. Registra una decisión por dependencia crítica
Una puerta de aceptación es una condición que debe resolverse antes de avanzar. Es útil cuando tiene evidencia, responsable y consecuencia definidos. Evita una lista de casillas en la que «revisado» pueda significar tanto «funciona» como «alguien recibió un correo».
Abrir registro de puerta de aceptación
- Proceso o dependencia que se valida: ___
- Condición exacta para aprobar: ___
- Entorno, versión y datos ficticios del ensayo: ___
- Evidencia y fecha de observación: ___
- Responsable técnico y responsable de negocio: ___
- Resultado: aprobado, pendiente o fallido: ___
- ¿Impide el corte? Motivo acordado: ___
- Acción pendiente, responsable y nueva verificación: ___
- Persona que autoriza continuar o detenerse: ___
- Limitaciones y riesgo aceptado expresamente, si corresponde: ___
Usa una ficha por condición crítica y conserva una decisión consolidada. La plantilla no envía información ni ejecuta pruebas desde esta página. No incluyas datos reales de clientes, credenciales o comprobantes sensibles para ilustrar el expediente.
Ensayo trabajado: por qué tres pruebas aprobadas no autorizan el corte
Escenario hipotético completo, no cliente ni prueba de rendimiento real. Una empresa traslada el mismo ERP a un alojamiento distinto. El proyecto contempla aplicación, base de datos, archivos de exportación y un receptor externo de pedidos. El fabricante ya confirmó para el ejercicio que la combinación propuesta es compatible; esa confirmación no prueba las personalizaciones. Las pruebas usan cuentas y pedidos sintéticos, una réplica autorizada y un receptor de prueba, nunca pedidos, cobros o documentos fiscales de producción.
El proceso crítico es crear un pedido interno, exportarlo con su almacén y comprobar el acuse del receptor. Negocio exige conservar identificador, almacén, artículo y cantidad; una exportación sin almacén impide saber dónde debe atenderse. El responsable funcional valida significado y resultados, el técnico verifica aplicación y transferencia, y el responsable del receptor confirma la recepción. Una persona designada por el negocio autoriza el corte; no se delega esa decisión a quien sólo observa que el servidor responde.
| Puerta | Evidencia ficticia observada | Resultado y dueño |
|---|---|---|
| Acceso y función permitida | El usuario de prueba completa su tarea; otro rol no obtiene una función que no le corresponde. | Aprobado para estos roles. Responsable funcional y técnico. |
| Pedido guardado correctamente | ENS-041 conserva almacén B02, artículo PRUEBA-A y cantidad 7 al consultarse de nuevo. | Aprobado para este caso. Responsable funcional. |
| Exportación y recepción completas | El archivo contiene ENS-041 y cantidad 7, pero omite B02; el receptor lo rechaza. | Fallido y bloqueante. Integración y responsable del receptor. |
| Reporte de control | El ERP muestra el pedido y sus campos esperados; el reporte local no demuestra recepción externa. | Aprobado sólo en el ERP. Responsable funcional. |
Decisión registrada: NO-GO. El proceso de negocio no termina en guardar el pedido: necesita recepción externa correcta. La prueba de acceso no compensa el rechazo de la integración. No se cambia el requisito después del fallo para que la hoja quede verde ni se compra más CPU sin una causa que lo justifique.
Corrección y reensayo, todavía ficticios: el equipo autorizado identifica un mapeo de exportación que omitía el almacén en la configuración del ensayo. Lo corrige en ese entorno y repite casos de B01 y B02. El receptor de prueba acepta ambos con identificador, almacén, artículo y cantidad correctos. También se vuelven a comprobar consulta y reporte porque el cambio afectó la ruta del pedido. Se guarda la revisión del mapeo y la evidencia asociada, no sólo una captura de «proceso terminado».
Qué decisión cambia: la puerta de exportación puede pasar a aprobada para los casos reensayados. El GO del proyecto todavía exige que estén resueltas las demás puertas, la validación de carga acordada, el punto de sincronización, los responsables y la contingencia. No se convierte un ensayo funcional con dos pedidos en una prueba de capacidad para todo el negocio.
Qué la volvería a cambiar: si después se modifica el conector, el formato o el receptor, hay que revisar qué evidencia quedó invalidada. Si el receptor sólo confirmó que llegó un archivo, pero no que aceptó sus campos, la puerta sigue pendiente. Si ese proceso no fuera necesario para el corte, sólo una decisión de negocio documentada sobre el alcance y su alternativa permitiría reclasificarlo; no basta llamarlo «detalle menor».
El énfasis en validación del usuario antes de cambiar los destinos coincide con la guía de corte de cargas de Azure. Su alcance es una reubicación en Azure: aquí se toma el principio de aceptación y verificación, no sus pasos de red ni un plazo universal de cierre.
4. Distingue recuperación de frecuencia de copias
RPO expresa la pérdida máxima de datos aceptable medida en tiempo; RTO expresa el tiempo máximo de indisponibilidad aceptable. Son objetivos que el negocio debe definir y la solución debe demostrar que puede atender en el escenario evaluado. La referencia de objetivos de confiabilidad de Microsoft distingue ambos conceptos.
Programar copias cada cierto intervalo no demuestra por sí solo que se cumpla el RPO: importan su finalización, consistencia, disponibilidad y el punto al que realmente se puede recuperar. Del mismo modo, el tiempo de copiar archivos no equivale al tiempo de volver a operar y verificar el ERP.
Para el corte, acuerda qué datos se detienen o sincronizan y cómo se comprobará el punto de partida del destino. Para una contingencia, documenta qué recuperación se ha ensayado y cuáles son sus límites. Si necesitas preparar esa evidencia, consulta la guía de respaldos empresariales; no hace falta repetir aquí toda la política de copias.
Calcula cuándo debes decidir, no sólo cuánto tarda copiar
Ejemplo hipotético de planificación, no tiempos medidos: se acuerda una ventana total de 90 minutos. Para el escenario de retorno sin datos nuevos se presupuestan 25 minutos de retorno, 15 de validación del proceso y 10 de margen. El último momento de decisión previsto sería 90 − 25 − 15 − 10 = 40 minutos desde el inicio. Esperar al minuto 55 deja 35 minutos, menos que los 50 presupuestados.
La relación reutilizable es: momento límite = ventana total − retorno − validación − margen, con todas las cantidades en la misma unidad. Si falta una duración, el resultado es desconocido, no cero; si el resultado es negativo, el plan no cabe en esa ventana. Es un presupuesto que debe contrastarse con ensayos y variabilidad, no prueba de cumplimiento del RTO ni garantía. Si aparecen datos nuevos, hay que reevaluar los tiempos y la ruta: el presupuesto anterior puede dejar de aplicar.
La planificación previa al corte de AWS incluye duración de tareas, responsables, contingencia y tiempo de retorno. Nuestro ejemplo sólo hace visible una decisión de agenda que esos componentes obligan a tomar.
5. Define qué significa volver atrás
El plan de retorno debe distinguir al menos dos momentos: antes de que el destino reciba trabajo nuevo y después de que ya existan cambios reales allí. En el segundo caso, volver a encender el origen puede dejar fuera operaciones recientes o producir divergencias. Un respaldo previo no resuelve automáticamente esa reconciliación.
Identifica el punto a partir del cual una reversión deja de ser simple y requiere un tratamiento específico de datos. No existe un «botón de rollback» universal para una aplicación, sus integraciones y los efectos que ya produjo fuera del servidor. El equipo debe acordar cuándo detener el trabajo, qué estado conservar y quién decidirá entre retorno, reparación o continuidad restringida.
Abrir preguntas del plan de retorno
- ¿Qué evento activa la evaluación de retorno y quién lo comunica?
- ¿Quién puede ordenar detener la operación y quién autoriza la decisión final?
- ¿Cuál es el último estado comprobado del origen y del destino?
- ¿Se han generado datos nuevos o efectos en servicios externos?
- ¿Cómo se identificarán y reconciliarán esas operaciones sin duplicarlas ni omitirlas?
- ¿Qué pasos fueron ensayados en un entorno autorizado y cuáles siguen sin comprobarse?
- ¿Qué tiempo queda para decidir dentro de la ventana disponible?
- ¿Cómo se comunicará la situación a los usuarios y al soporte?
El mismo fallo tiene dos decisiones distintas según los datos nuevos
Continuación hipotética del ensayo, no instrucciones para producción. El equipo prueba dos escenas separadas. En ambas existe un punto de sincronización identificado, T0, con 100 pedidos sintéticos comprobados en origen y destino. La cifra por sí sola no acredita igualdad: se contrastan los identificadores y campos relevantes del conjunto de prueba. El plan ya define quién puede detener la operación, quién decide y quién ejecuta la ruta autorizada.
Escena A: el destino no recibió trabajo nuevo
La validación inicial falla antes de abrir el destino a usuarios o integraciones. Los responsables verifican que no hubo nuevas escrituras ni efectos externos desde T0, que el origen sigue íntegro y que su reapertura fue ensayada. En ese escenario, el retorno previsto puede evaluarse sin tener que incorporar pedidos posteriores al corte. La decisión del ejercicio es no abrir el destino y usar el procedimiento de retorno aprobado, una vez comprobadas sus condiciones.
Si no puedes confirmar la ausencia de cambios, no clasifiques la escena como «sin datos nuevos». Un proceso programado o una integración puede escribir aunque nadie haya iniciado sesión. Y aunque no haya datos nuevos, todavía hay que validar que los usuarios vuelvan al sistema correcto y que el proceso completo funcione.
Escena B: el destino ya recibió tres pedidos
Después de habilitar el destino en el escenario de prueba, aparecen ENS-101, ENS-102 y ENS-103. Los dos primeros tienen acuse externo confirmado; el tercero quedó sin respuesta concluyente cuando falló la integración. El origen permanece en los 100 pedidos de T0. En este momento, «volver al servidor anterior» y «conservar toda la operación» son tareas distintas.
| Operación | Origen / destino | Efecto externo confirmado |
|---|---|---|
| ENS-101 | No está en origen; sí en destino. | Acuse recibido. No repetir a ciegas. |
| ENS-102 | No está en origen; sí en destino. | Acuse recibido. No repetir a ciegas. |
| ENS-103 | No está en origen; sí en destino. | Desconocido. Falta verificar con el receptor. |
Decisión del ejercicio: no ejecutar el retorno simple. El responsable activa la contención prevista para el proceso afectado y conserva el estado necesario para analizarlo, conforme al plan autorizado. El equipo debe determinar el estado de ENS-103 y decidir entre reparar en destino o aplicar una reconciliación y retorno ensayados. Reenviar los tres pedidos sin verificar puede duplicar efectos de ENS-101 y ENS-102; restaurar sólo T0 dejaría los tres fuera de la operación del origen.
Supón que el receptor confirma que ENS-103 también fue aceptado y que sólo se perdió el acuse. Ahora el registro tiene tres efectos externos confirmados, pero el origen sigue sin los tres pedidos. El dato nuevo elimina una incertidumbre; no autoriza borrar ni volver a enviar. En la rama resuelta de este ejercicio ficticio, el fabricante cuenta con un procedimiento validado para recuperar esos estados de confirmación. El equipo lo ensaya y el responsable funcional verifica los tres identificadores, sus campos y sus acuses, sin generar nuevos pedidos en el receptor. Por esa evidencia se elige reparar en destino y repetir la validación del proceso. Si esa ruta no existe, falla la comprobación o queda un efecto desconocido, la decisión cambia: la escena permanece detenida para la reconciliación autorizada. No se inventa una receta de base de datos para conseguir un final feliz.
La documentación de AWS sobre corte y rollback distingue expresamente el retorno sin cambios del retorno con nuevas transacciones. Las técnicas que enumera dependen de la aplicación y la arquitectura; no son autorización para configurar doble escritura ni replicación en cualquier ERP.
Antes del corte real, define para tu aplicación cómo reconocer y resolver estas diferencias, incluyendo estados desconocidos. La tabla sirve para discutir y comprobar el plan; no mueve datos, no identifica automáticamente todas las operaciones y no sustituye el procedimiento aprobado por el fabricante.
La guía de ejecución de migraciones a Azure destaca coordinación, revisión previa y control de cambios durante la transición. No se deben trasladar sus pasos técnicos automáticamente a un ERP diferente. El procedimiento ejecutable necesita ajustarse al motor, la aplicación, el proveedor y las autorizaciones del proyecto.
6. Autoriza el corte con evidencia vigente
Antes de la ventana, revisa que las personas necesarias estén disponibles, que las puertas críticas sigan aprobadas y que no haya cambios posteriores que invaliden el ensayo. Si una versión, integración o condición cambió, decide qué debe volver a comprobarse. Una aprobación antigua no cubre automáticamente un escenario nuevo.
Una regla de decisión que puedes aplicar a tu acta
- ¿Hay una condición crítica fallida o sin evidencia? NO-GO hasta resolverla o cambiar formalmente el alcance con una alternativa aceptada. «No sabemos» no equivale a aprobado.
- ¿Las pruebas corresponden a la versión y configuración que se va a mover? Si no, identifica y repite las afectadas antes de usar sus resultados.
- ¿Está claro el punto de sincronización y qué hacer con datos nuevos? Si no, falta una parte esencial de la contingencia.
- ¿Están disponibles quienes deciden, validan y ejecutan? Una ventana sin ellos no es una ventana preparada.
- ¿Todo lo anterior está resuelto? La persona designada puede valorar el GO documentado, con límites y riesgos residuales explícitos. La lista no lo autoriza por sí sola.
Copiar un acta breve de decisión y contingencia
Proyecto y revisión del plan: ___
Alcance exacto del corte: ___
Puertas críticas y referencias de evidencia: ___
Cambios desde el último ensayo y verificaciones repetidas: ___
Punto de sincronización y cómo se comprobará: ___
Responsable de negocio / técnico / receptor externo: ___
Estado de operaciones nuevas: ausencia verificada / existen / desconocido, con evidencia: ___
Ruta prevista ante fallo y condiciones para usarla: ___
Evento o momento que obliga a reconsiderar la decisión: ___
Decisión GO / NO-GO, razón, autor y fecha: ___
Validación posterior y criterio de cierre: ___
Completa las referencias con identificadores internos, no contraseñas ni datos de clientes. Copia también el registro de diferencias del ejemplo y cambia sus filas por las que correspondan a un ensayo autorizado. La página no guarda ni envía el acta.
El acta de GO/NO-GO debe identificar la versión del plan, los pendientes, la decisión y quién la toma. La aceptación de un riesgo residual debe ser explícita y corresponder a alguien con autoridad. No conviertas el silencio de un área en aprobación ni permitas que una fecha comercial oculte un impedimento técnico conocido.
Tras el cambio autorizado, valida el proceso de negocio completo y la continuidad de las integraciones. Abrir sesión es una comprobación inicial, no el cierre del proyecto. Mantén un periodo de observación definido por los procesos que faltan por recorrer y un canal de escalamiento acordado, sin prometer un horario de atención que no esté contratado.
El cierre debe explicar qué pasó al origen, quién opera el destino y qué pendientes siguen abiertos. Retirar datos o infraestructura requiere el procedimiento y los permisos correspondientes; no es una acción implícita por haber aprobado el piloto.
7. Compra coordinación y criterio, no una fecha prometida
Un acompañamiento experimentado puede justificar un coste mayor si aporta pruebas bien diseñadas, coordinación entre áreas y una decisión de corte respaldada por evidencia. Ese valor se compara con el tiempo interno y las interrupciones que se quieren evitar, sin convertirlo en una garantía de migración sin fallos.
Quizá no necesitas contratar una migración ahora: si el entorno actual cumple los requisitos y no existe una razón de negocio demostrada, puedes mantenerlo y resolver un problema específico. Si tu equipo y el fabricante ya cubren pruebas, coordinación y contingencia, una revisión puntual puede bastar. También cabe comparar otro proveedor o una modalidad distinta de la aplicación, pero sin tratar SaaS como si fuera sólo mover la misma VM.
Puedes consultar con Cobalt Blue Web u otro especialista qué parte del plan puede asumir, qué necesita del fabricante del ERP y qué entregables ofrecerá. Pide responsables, horarios, exclusiones y criterios de aceptación por escrito. El proveedor no debe decidir por sí solo cuánto riesgo de negocio puede aceptar tu empresa. Para una primera conversación comparte versión del ERP, dependencias, proceso crítico y evidencia que falta; no envíes bases de datos, credenciales ni documentos de clientes por un formulario general.
IA útil: revisar contradicciones antes de la reunión de corte
La IA puede ayudar a contrastar un mapa de dependencias y un acta depurados, pero no observa por sí sola el estado del ERP ni acredita una migración. En el ejemplo, una revisión útil detectaría que el acta dice «listo para corte» mientras la exportación está fallida, o que el retorno propuesto no explica los tres pedidos posteriores a T0. La salida esperada es una lista de preguntas y referencias, no un GO automático.
Con documentos sintéticos, puedes pedir: «Para cada puerta marcada aprobada, identifica su evidencia. Separa contradicciones de datos que faltan. Si hay operaciones posteriores al punto de sincronización, enumera qué debe verificarse antes de considerar el retorno. No supongas que una respuesta ausente significa que el receptor rechazó el pedido». Contrasta manualmente cada hallazgo con el acta y el responsable correspondiente.
No transmitas bases, credenciales, datos personales ni documentos confidenciales por canales no aprobados. Un modelo puede omitir una dependencia o inventar una certeza; la revisión documental ayuda a preparar la conversación, no reemplaza pruebas ni responsabilidad humana. No se han medido ahorros ni precisión de una herramienta de IA en los escenarios ficticios de esta guía.
Un servidor para ERP define si tu cierre de mes fluye o colapsa. Por eso, conviene dimensionarlo con datos, validar la arquitectura y asegurar que el soporte responda. Además, los cierres concentran cargas atípicas: reportes largos, timbrado simultáneo, consolidados y comprobaciones de inventario. En consecuencia, si la infraestructura no entrega CPU sostenida, RAM disponible e IOPS bajas, la operación se enlentece y los usuarios sienten que “todo se cayó”.
Checklist rápido para el cierre de mes
Primero, establece un mínimo técnico verificable:
-
CPU sostenida < 70% durante picos de cierre.
-
Memoria libre > 25% al ejecutar reportes.
-
Latencia de disco < 5 ms y IOPS garantizadas.
-
Ancho de banda estable y rutas RDP/HTTPS sin pérdida.
-
RPO/RTO documentados y probados.
-
Backups diarios con retención y restauración validada.
-
MFA en accesos administrativos y segmentación de redes.
Además, si tu ventana de cierre es corta, asegúrate de contar con un runbook de contingencia para restaurar rápido una versión consistente del ERP.
si necesitas dimensionamiento inmediato y opciones administradas, revisa estas soluciones VPS para empresas en México y alinea recursos antes del pico.
Capacidad base del servidor para ERP: CPU, RAM e IOPS

Aunque cada ERP tiene particularidades, para 15–40 usuarios concurrentes conviene iniciar con 8 vCPU, 32 GB RAM y NVMe dedicado con IOPS garantizadas. Asimismo, separa volúmenes: SO, datos, respaldos y, si aplica, logs. Así reduces contención y mejoras tiempos de respuesta en reportes.
Disco NVMe y colas de E/S
Consolidaciones y consultas de inventario son operaciones de lectura/escritura intensiva. Por lo tanto, la mejora más rentable suele estar en el almacenamiento. Activa NVMe, eleva IOPS y vigila la longitud de cola; si crece, la experiencia de usuario caerá aun con mucha CPU libre.
Alta disponibilidad y objetivos RPO/RTO

No siempre necesitas clúster activo/activo; sin embargo, para cierres con facturación continua, la alta disponibilidad entre zonas evita paros prolongados. Define RPO (pérdida aceptable de datos) y RTO (tiempo para volver a operar). Además, agenda pruebas de restauración trimestrales: solo así sabrás que el plan funciona. Si ocurre un incidente, aplica el procedimiento de recuperación de ERP en la nube urgente: levántalo en horas.
Servidor para ERP con escritorios Windows
Muchos ERPs funcionan mejor con escritorios remotos; por eso, valida códecs RDP, impresoras y escáneres. Asimismo, ubica la instancia cerca de tus usuarios para reducir latencia y evita “saltos” innecesarios por VPN mal configuradas.
Si requieres un entorno listo para aplicaciones Windows de escritorio ERP, conoce estas opciones de servidores en la nube y estandariza tu acceso remoto.
Monitoreo y pruebas de estrés
Mientras te acercas al cierre, ejecuta pruebas de carga representativas: genera reportes largos, multiplica sesiones, simula timbrado. Luego, observa:
-
CPU por vCPU y ready time.
-
RAM comprometida vs. en caché.
-
IOPS y latencia por volumen.
-
RDP RTT y pérdidas en la red.
-
Errores de aplicación (tiempos fuera, bloqueos).
Con métricas a la mano, podrás incrementar vCPU o RAM de forma preventiva y, en consecuencia, evitarás improvisaciones a última hora.
Seguridad operativa para el cierre
Durante cierres, crecen los accesos y las prisas; por eso, define políticas estrictas:
-
MFA obligatorio para administradores.
-
Listas de control por IP y bloqueo geográfico cuando aplique.
-
WAF en servicios web y TLS actualizado.
-
Segmentación por VLAN/SG para bases y escritorios.
-
Principio de mínimo privilegio durante la ventana de cierre.
Además, registra cambios en un change log y conserva evidencia de quién accedió, cuándo y desde dónde.
Plan de respaldos y cutover probado
No basta con “tener backups”; necesitas restauraciones validadas y, si migras a infraestructura nueva, un plan de cutover limpio. Define:
-
RPO 1 h (o menor) con retención 14–30 días.
-
Backups consistentes a nivel de aplicación.
-
Copias fuera de la zona para contingencias mayores.
-
Scripts de smoke test post-restauración (login, reporte crítico, impresión).
Asimismo, guarda copias en infraestructura independiente. Si tu ERP convive con bases auxiliares (por ejemplo, Access), revisa estas buenas prácticas para Access en la nube para evitar archivos bloqueados en hora pico.
Arquitectura recomendada por tamaño de operación
| Escenario | CPU y RAM | Almacenamiento | Red/Acceso | Observaciones |
|---|---|---|---|---|
| Pyme (≤20 usuarios) | 6–8 vCPU, 24–32 GB RAM | NVMe 500 GB (datos) + 200 GB (backups) | RDP por IP fija, MFA | Escalar IOPS si los reportes tardan > 60 s |
| Mediana (21–50) | 8–12 vCPU, 32–48 GB RAM | NVMe 1 TB (datos) + 500 GB (backups) | Balanceo RDP, WAF | Separar base y escritorios en VMs distintas |
| Multi-sucursal (51–100) | 12–16 vCPU, 64 GB RAM | NVMe 2 TB + réplica en otra zona | SD-WAN/QoS y HA | Replicación y cutover automatizado |
Cuándo cambiar de VPS a dedicado
Si la cola de E/S sigue alta tras subir IOPS, si las sesiones RDP saturan o si la contención de vCPU es crónica, entonces evalúa migrar. Compara en esta guía de servidor dedicado vs. VPS con escritorio remoto para decidir según picos, licencias y presupuesto. Además, recuerda que el dedicado administrado incluye más control sobre NUMA, afinidad y redes, lo que, en algunos ERPs, marca una diferencia tangible.
Gobierno de cambios y ventanas de mantenimiento
Para no interrumpir el cierre, calendariza parches y actualizaciones fuera de horario productivo. Documenta:
-
Paquetes aplicados y versiones.
-
Respaldos previos y punto de reversión.
-
Resultados de smoke tests.
-
Incidencias y mitigaciones.
Asimismo, comunica con antelación a las áreas contables y financieras qué días y horas habrá ventanas, y mantén un canal de soporte en vivo.
Estándares de servicio y soporte: Servidor para ERP
Un buen proveedor no solo “vende máquinas”; aporta SLA con primera respuesta y tiempos de resolución, acompañamiento en picos y runbooks de incidentes. Pide evidencias: capturas de monitorización, casos resueltos y referencias. Además, solicita acompañamiento durante el cierre y una línea directa con el NOC.
Si necesitas un diagnóstico express o apoyo de guardia para tu cierre, contacta a un ingeniero ahora y agenda una revisión de arquitectura.
Servidor para ERP: Métricas que debes vigilar el último día
-
Tiempo de apertura de reportes clave (< 30 s ideal, < 60 s aceptable).
-
Errores de aplicación por bloqueo o timeout.
-
RDP RTT promedio y picos.
-
Latencia de disco y longitud de cola.
-
Uso de CPU por proceso del ERP y del motor de base de datos.
Entonces, con estas métricas puedes decidir si escalar vertical u horizontalmente antes de que el personal se queje.
Integración con compras y ventas: picos previsibles: Servidor para ERP
Aun cuando contabilidad sufra la mayor carga, compras y ventas también generan picos. Por consiguiente, coordina horarios, secuencia reportes y limita procesos pesados simultáneos. Además, reserva “ventanas silenciosas” para la generación de pólizas y cálculos finales.
Servidor para ERP
Elegir el servidor para ERP adecuado no es un lujo; es un seguro contra cuellos de botella y paros en el momento más crítico del mes. Con capacidad correcta, NVMe garantizado, RPO/RTO probados, MFA y monitoreo, tu cierre será predecible. Finalmente, mantén un plan de escalado y un proveedor que acompañe de verdad.
Si quieres validar tu dimensionamiento y llegar al próximo cierre sin sobresaltos, agenda una llamada con Cobalt Blue Web y obtén un plan a medida.